Setiap kali Anda membuka File Explorer di Windows atau Finder di macOS, Anda sedang menatap data yang tersusun bercabang. Satu folder induk memuat beberapa subfolder, dan tiap subfolder bisa memuat subfolder lagi sampai berkas terakhir. Tidak ada subfolder yang punya dua folder induk sekaligus, dan tidak ada jalur yang berputar kembali ke titik asalnya.
Susunan seperti itu tidak bisa diwakili daftar yang berbaris lurus. Array dan linked list menyimpan data satu per satu dalam satu deret, sehingga hubungan "siapa induk siapa" hilang begitu datanya bertingkat. Di sinilah struktur data tree mengambil perannya.
Struktur Data Tree Adalah Data Bercabang dari Satu Akar
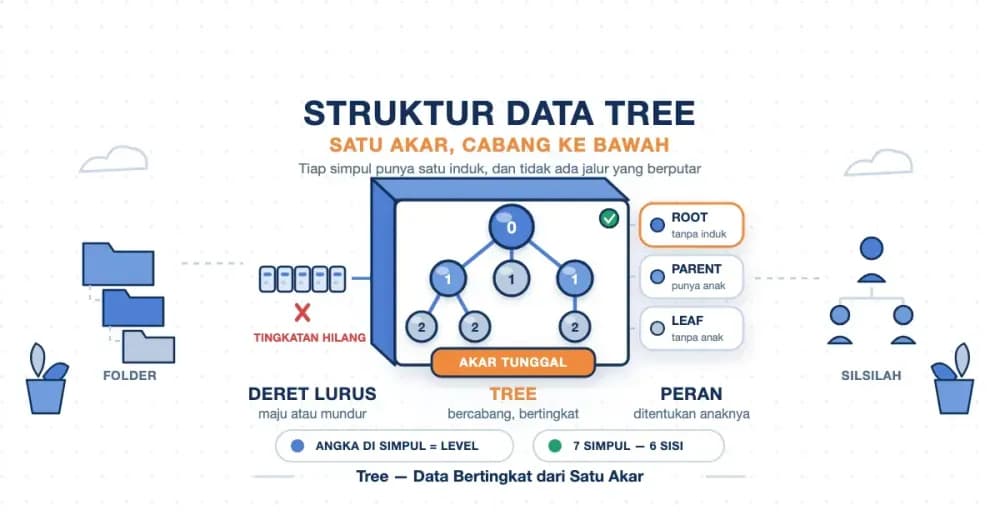
Struktur data tree adalah cara menyimpan data secara bertingkat atau hierarkis, di mana setiap elemen terhubung ke satu elemen di atasnya dan boleh memiliki beberapa elemen di bawahnya. Elemen penyimpan datanya disebut node (simpul), dan garis penghubung antarsimpul disebut edge (sisi). Satu simpul berada di puncak tanpa induk sama sekali, dan simpul itulah yang disebut root (akar).
Namanya diambil dari pohon karena bentuknya menyerupai pohon, tetapi gambarnya justru terbalik. Akar berada di atas, cabang tumbuh ke bawah, dan daun menempati baris paling bawah. Karena itu dalam materi berbahasa Indonesia istilah ini sering diterjemahkan menjadi struktur pohon atau struktur data pohon — ketiganya merujuk pada hal yang sama.
Tree termasuk struktur data non-linear. Pada struktur linear seperti array atau queue, setiap elemen punya tepat satu pendahulu dan satu pengganti, sehingga penelusurannya hanya bisa maju atau mundur. Tree membebaskan satu simpul bercabang ke beberapa arah, sehingga penelusurannya bisa menurun ke cabang mana pun.
Satu hal yang perlu diperhatikan sejak awal: tree tidak menyimpan data lebih cepat karena bentuknya cantik. Ia menyimpan data lebih cepat karena bentuknya memungkinkan separuh kemungkinan dibuang pada setiap langkah. Angkanya kita hitung di bagian fungsi nanti.
Tiga Syarat yang Membuat Gambar Anda Benar-benar Sebuah Tree
Banyak gambar bercabang terlihat seperti tree padahal bukan. Prinsip dasarnya terdiri dari tiga syarat yang harus dipenuhi bersamaan, dan syarat ketiga bisa Anda hitung sendiri tanpa perlu meneliti gambarnya satu per satu.
- Setiap simpul punya tepat satu induk, kecuali root: Root adalah satu-satunya simpul tanpa induk. Kalau ada simpul yang ditarik garis dari dua induk sekaligus, gambar itu bukan tree. Buku Siswa Informatika Kelas IX merumuskannya begini: "anak (child) yang hierarkinya lebih rendah, hanya mempunyai satu 'orang tua' (parent)".
- Tidak ada siklus: Menelusuri dari simpul mana pun ke bawah tidak boleh membawa Anda kembali ke simpul yang sudah dilewati. Jalur pada tree selalu menjauh dari akar, tidak pernah melingkar.
- N simpul harus terhubung oleh tepat N−1 sisi: Setiap simpul selain root menyumbang satu sisi ke induknya. Karena hanya root yang tidak menyumbang sisi, jumlah sisinya selalu satu lebih sedikit dari jumlah simpulnya.
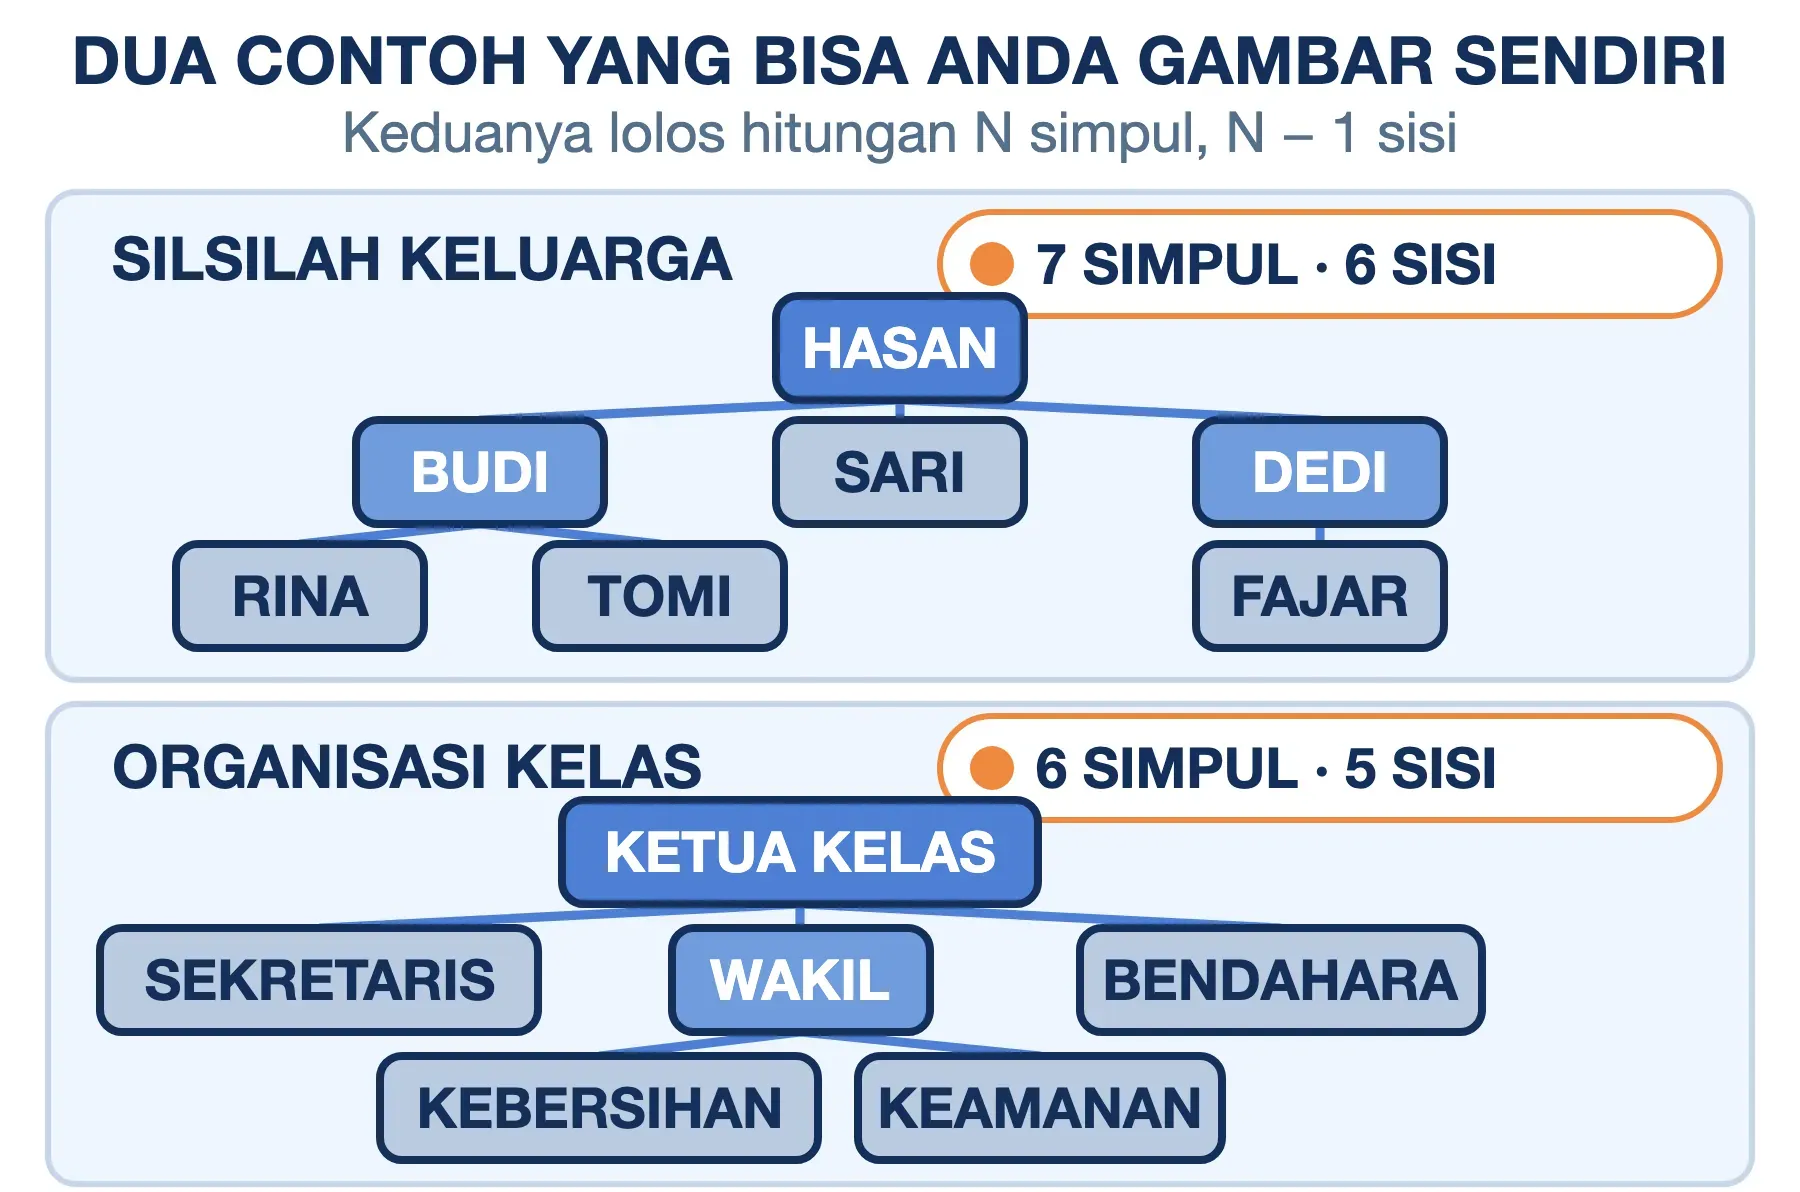
Syarat ketiga inilah alat periksa yang paling praktis. Ambil contoh silsilah tiga generasi yang akan kita pakai di sepanjang artikel ini: Hasan di puncak; Budi, Sari, dan Dedi sebagai anaknya; lalu Rina dan Tomi sebagai anak Budi, serta Fajar sebagai anak Dedi. Totalnya tujuh simpul, dan kalau Anda menghitung garisnya akan ada tepat enam.
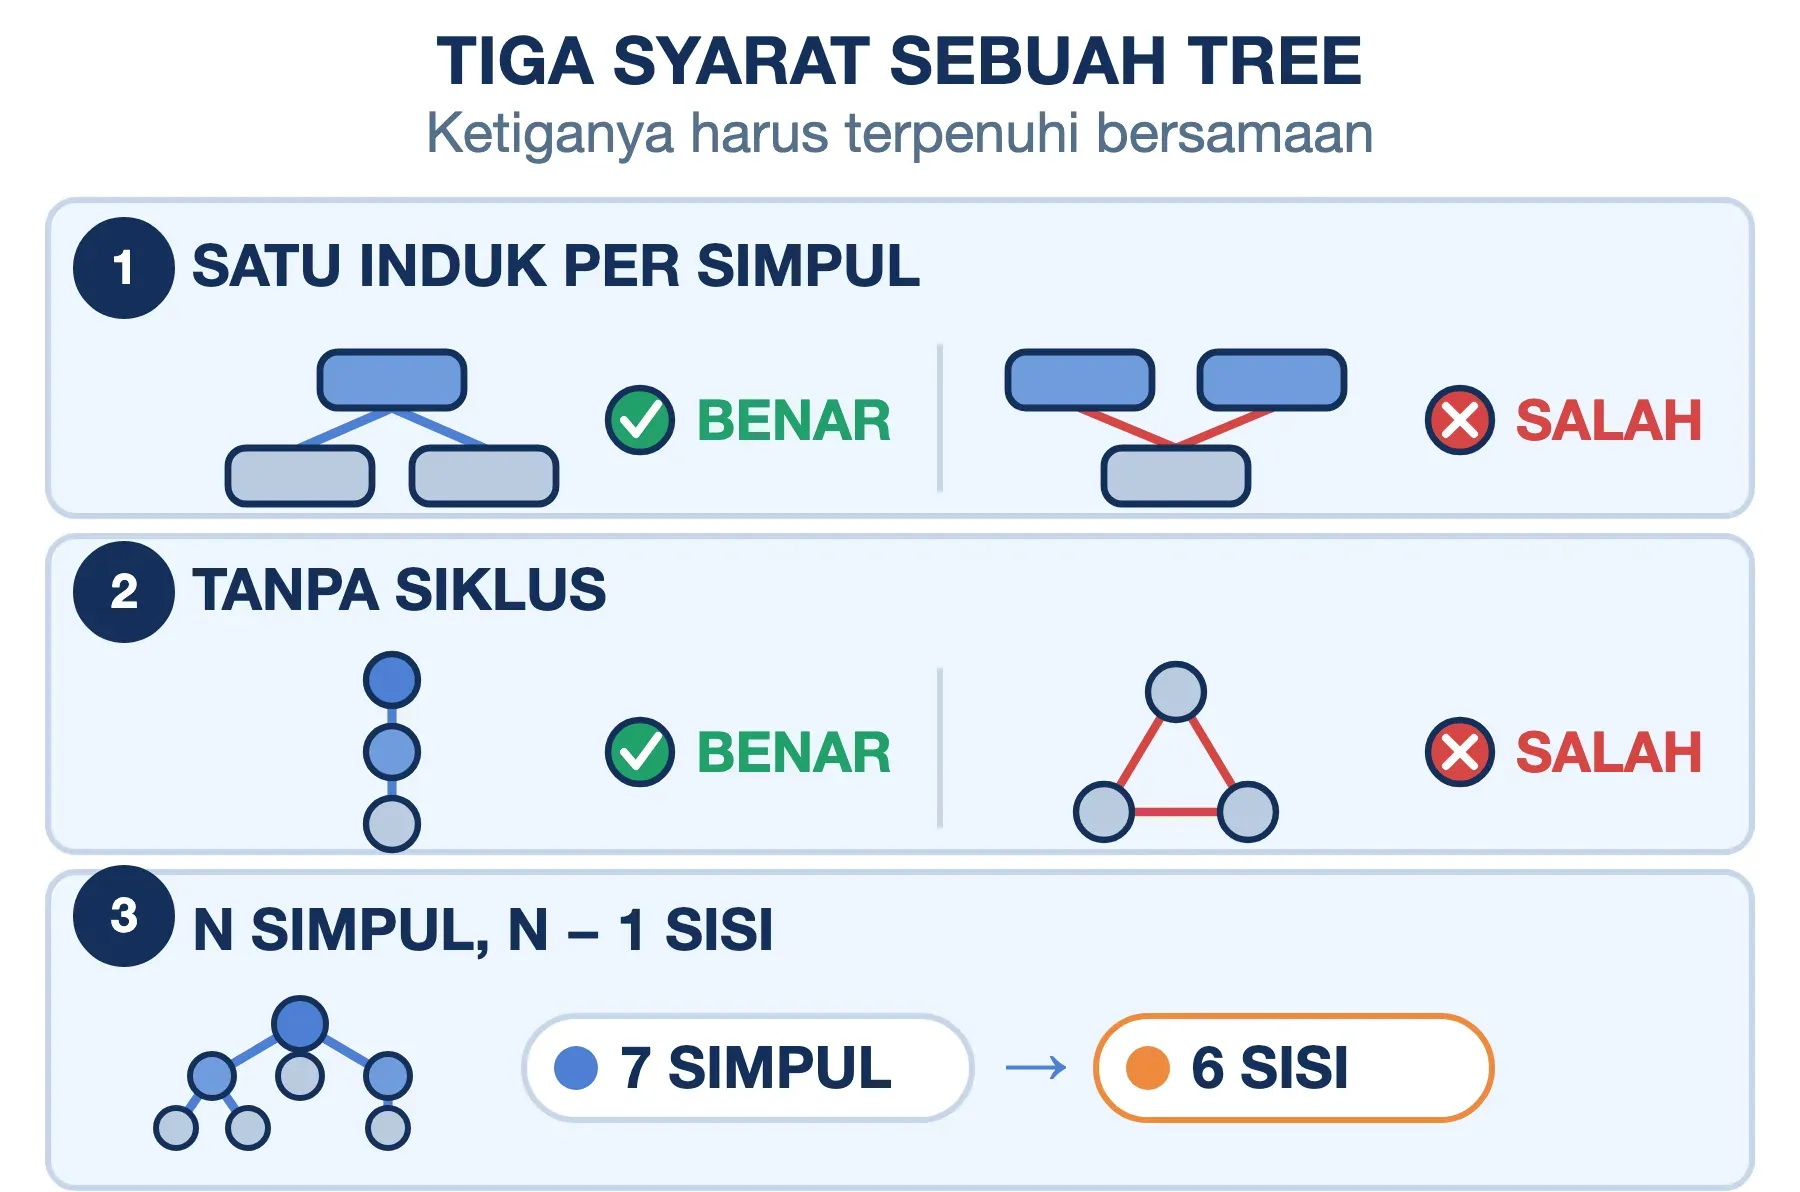
Kalau gambar Anda punya N simpul tetapi sisinya lebih dari N−1, pasti ada siklus atau ada simpul berinduk dua. Kalau sisinya justru kurang dari N−1, berarti ada bagian yang terlepas dan gambar itu menjadi forest (hutan) — kumpulan beberapa tree, bukan satu tree.
Ciri utama struktur data tree, jika harus diringkas satu kalimat, adalah hubungan induk-anak satu arah dari satu akar tunggal tanpa jalur yang berputar. Ketiga syarat itu sekaligus menjadi karakteristik yang membedakannya dari struktur data lain.
Istilah pada Tree: Root, Parent, Child, Sibling, Leaf, dan Edge
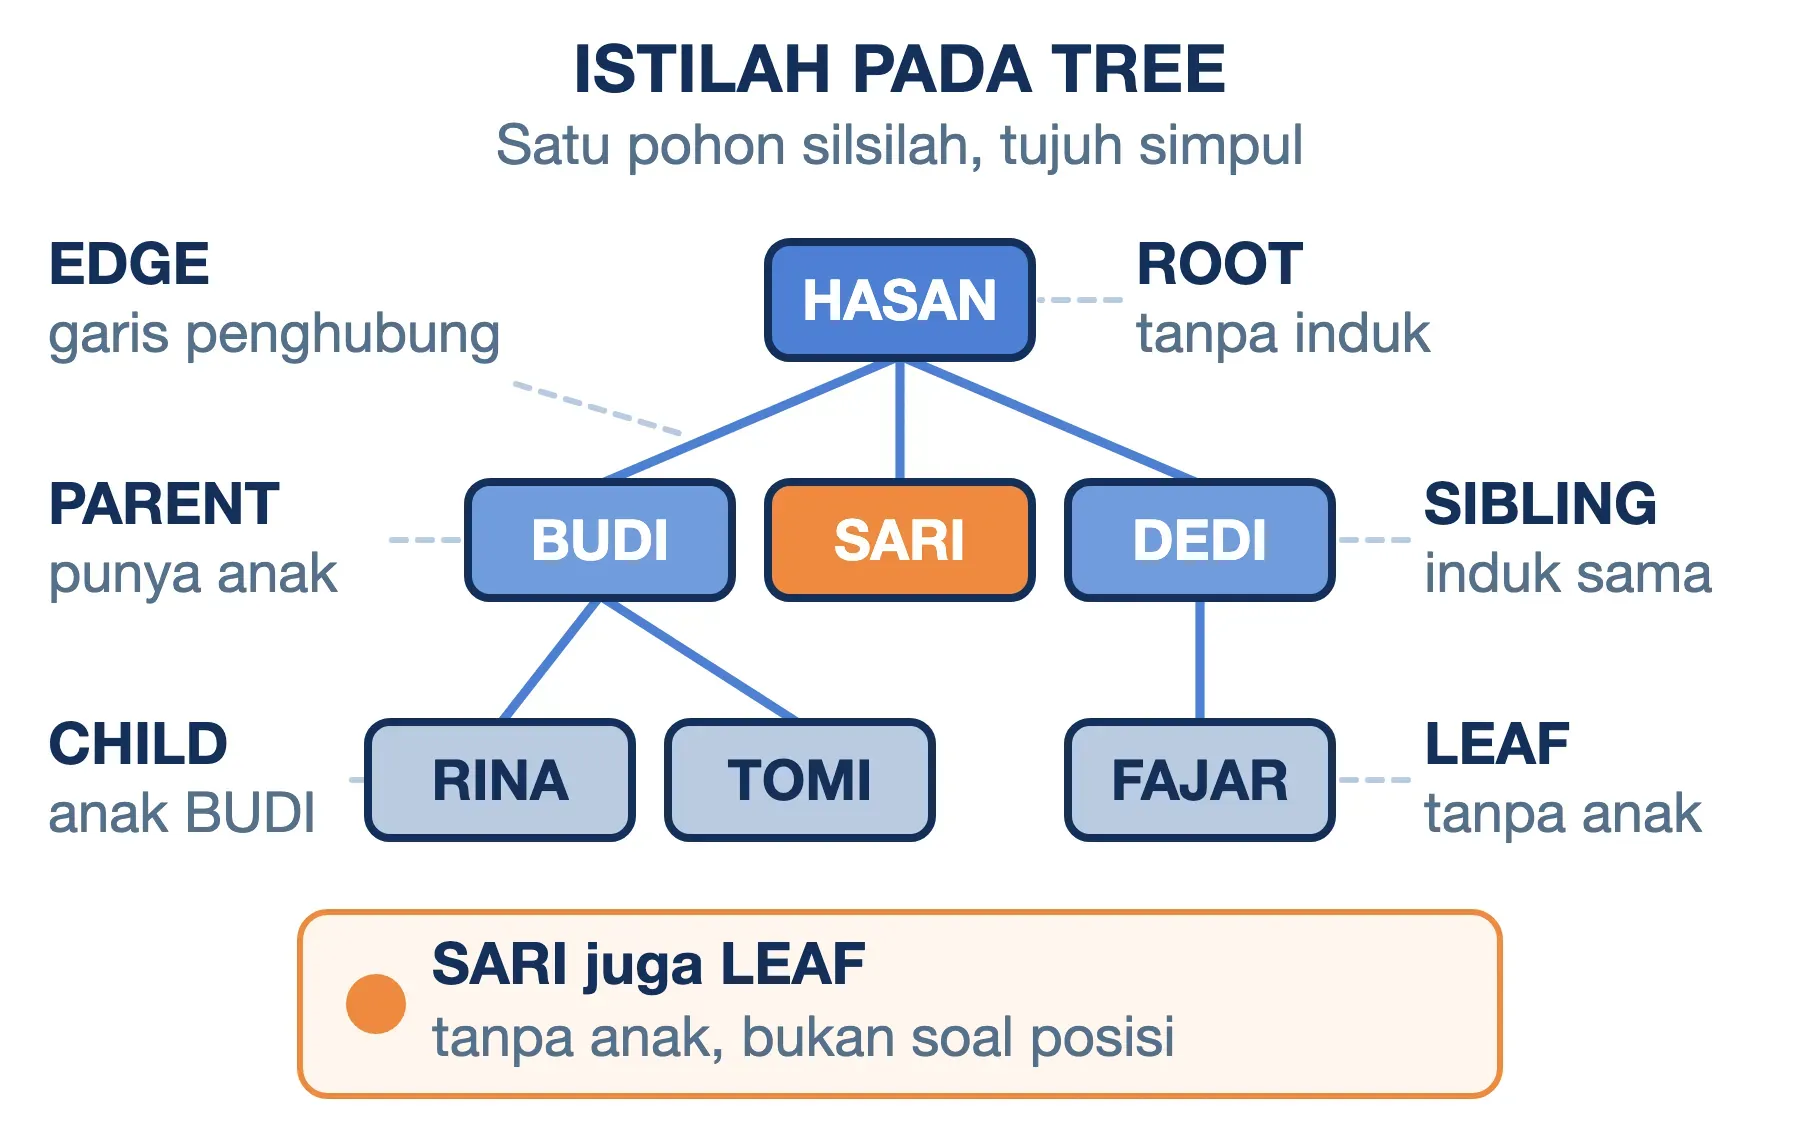
Komponen sebuah tree sebetulnya hanya dua: simpul sebagai wadah data, dan sisi sebagai penghubungnya. Sisanya adalah nama untuk peran yang dimainkan sebuah simpul terhadap simpul lain. Seluruh istilah di bawah ini lebih mudah diingat kalau dipetakan ke satu pohon acuan yang sama, jadi kita pakai silsilah tujuh simpul yang baru disebutkan.
| Istilah | Artinya | Pada pohon acuan |
|---|---|---|
| Node (simpul) | Elemen yang menyimpan data | Hasan, Budi, Sari, Dedi, Rina, Tomi, Fajar |
| Edge (sisi) | Penghubung dua simpul; mewakili hubungan, bukan data | Hasan–Budi, Budi–Rina, dan 4 sisi lain |
| Root (akar) | Simpul puncak, diibaratkan akar pohon; tanpa induk | Hasan |
| Parent (induk) | Simpul satu tingkat di atasnya | Budi adalah parent Rina |
| Child (anak) | Simpul satu tingkat di bawahnya | Rina dan Tomi child dari Budi |
| Sibling (saudara) | Simpul yang berinduk sama | Budi, Sari, Dedi saling bersaudara |
| Leaf (daun) | Simpul yang tidak punya anak sama sekali | Sari, Rina, Tomi, Fajar |
| Internal node | Simpul yang punya minimal satu anak | Hasan, Budi, dan Dedi |
| Degree (derajat) | Jumlah anak sebuah simpul | Hasan berderajat 3, Budi 2, Sari 0 |
| Ancestor (leluhur) | Semua simpul di jalur ke root | Ancestor Fajar: Dedi dan Hasan |
| Descendant (keturunan) | Semua simpul di bawahnya | Descendant Budi: Rina dan Tomi |
| Subtree (subpohon) | Satu simpul beserta keturunannya | Subtree Budi: Budi, Rina, Tomi |
Perhatikan bahwa Sari masuk daftar leaf meskipun letaknya di baris kedua, bukan di baris paling bawah. Status leaf ditentukan oleh ada atau tidaknya anak, bukan oleh posisi vertikalnya pada gambar. Ini kekeliruan yang paling sering muncul saat menjawab soal tentang leaf.
Istilah lain yang kadang ikut ditanyakan adalah successor dan predecessor. Pada konteks penelusuran, successor sebuah simpul adalah simpul berikutnya menurut urutan penelusuran yang dipakai, dan predecessor adalah simpul sebelumnya. Keduanya bergantung pada metode penelusuran, bukan pada bentuk pohonnya.
Level, Kedalaman, dan Tinggi: Tiga Angka yang Sering Tertukar
Tiga istilah ini terdengar mirip dan sering dipakai bergantian, padahal dua di antaranya dihitung dari arah yang berlawanan.
- Level adalah jarak sebuah simpul dari root, dihitung dalam jumlah sisi yang dilewati. Root berada di level 0.
- Depth (kedalaman) nilainya sama dengan level. Root berkedalaman 0, dan Rina pada pohon acuan berkedalaman 2.
- Height (tinggi) adalah panjang jalur terpanjang dari sebuah simpul turun ke leaf. Semua leaf bertinggi 0, karena tidak ada jalur turun dari sana.
Kuncinya begini: kedalaman dihitung dari atas ke bawah, tinggi dihitung dari bawah ke atas. Sebuah simpul bisa berkedalaman 2 dan bertinggi 0 sekaligus, dan Rina adalah contohnya.
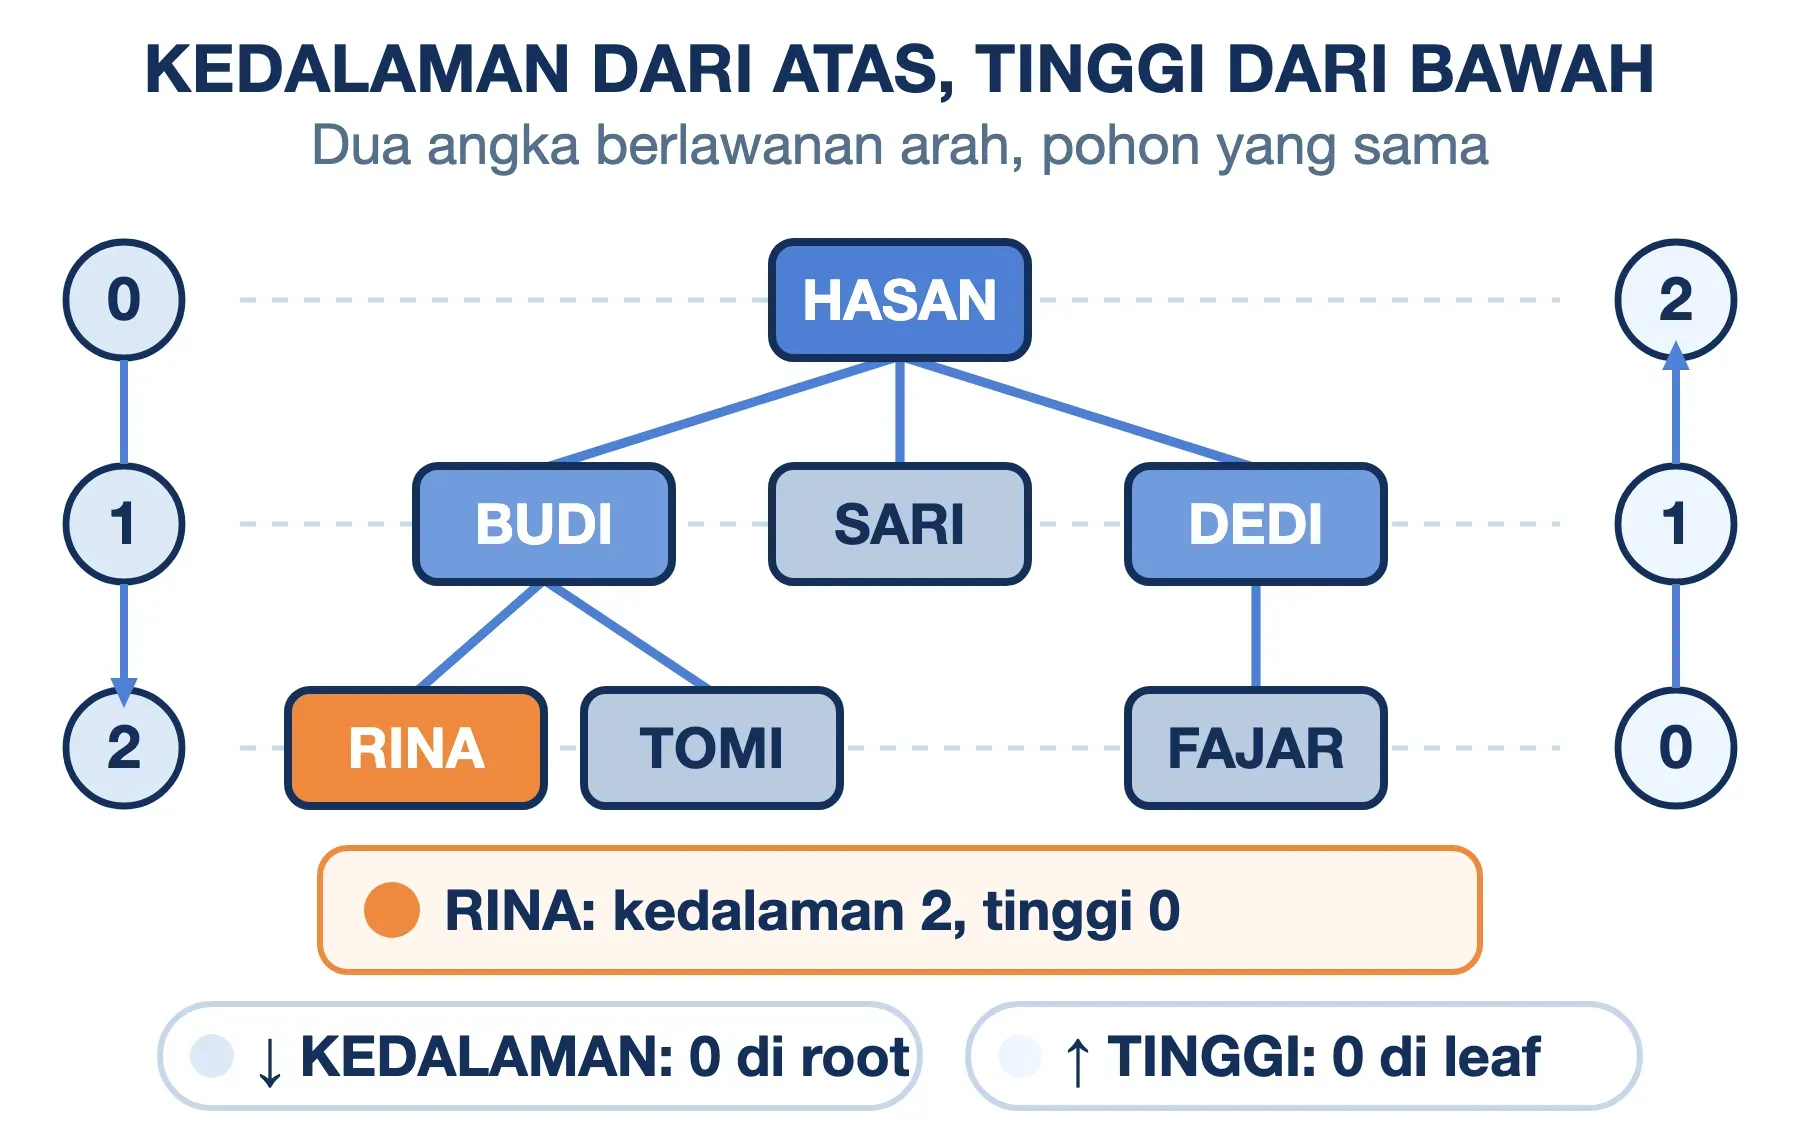
Tinggi sebuah tree sama dengan tinggi root-nya. Pada pohon acuan, jalur terpanjang dari Hasan ke bawah adalah Hasan → Budi → Rina, yang melewati dua sisi. Jadi tinggi pohon itu 2, dan level maksimumnya juga 2. Level maksimum yang terdapat pada tree memang disebut tinggi atau height dari tree tersebut.
Sebagian materi ajar mulai menghitung level dari 1, sehingga root berada di level 1 dan pohon acuan tadi dinyatakan bertinggi 3. Perbedaannya hanya soal titik mula penghitungan. Konvensi yang dipakai spesifikasi dan pustaka standar adalah root di level 0, dan angka itulah yang dipakai di seluruh artikel ini.
Satu angka lagi yang kadang diminta adalah width (lebar), yaitu jumlah simpul pada satu level. Pohon acuan punya lebar 1 di level 0, lebar 3 di level 1, dan lebar 3 di level 2.
Jenis Struktur Data Tree dan Dua Pembagian Dasarnya
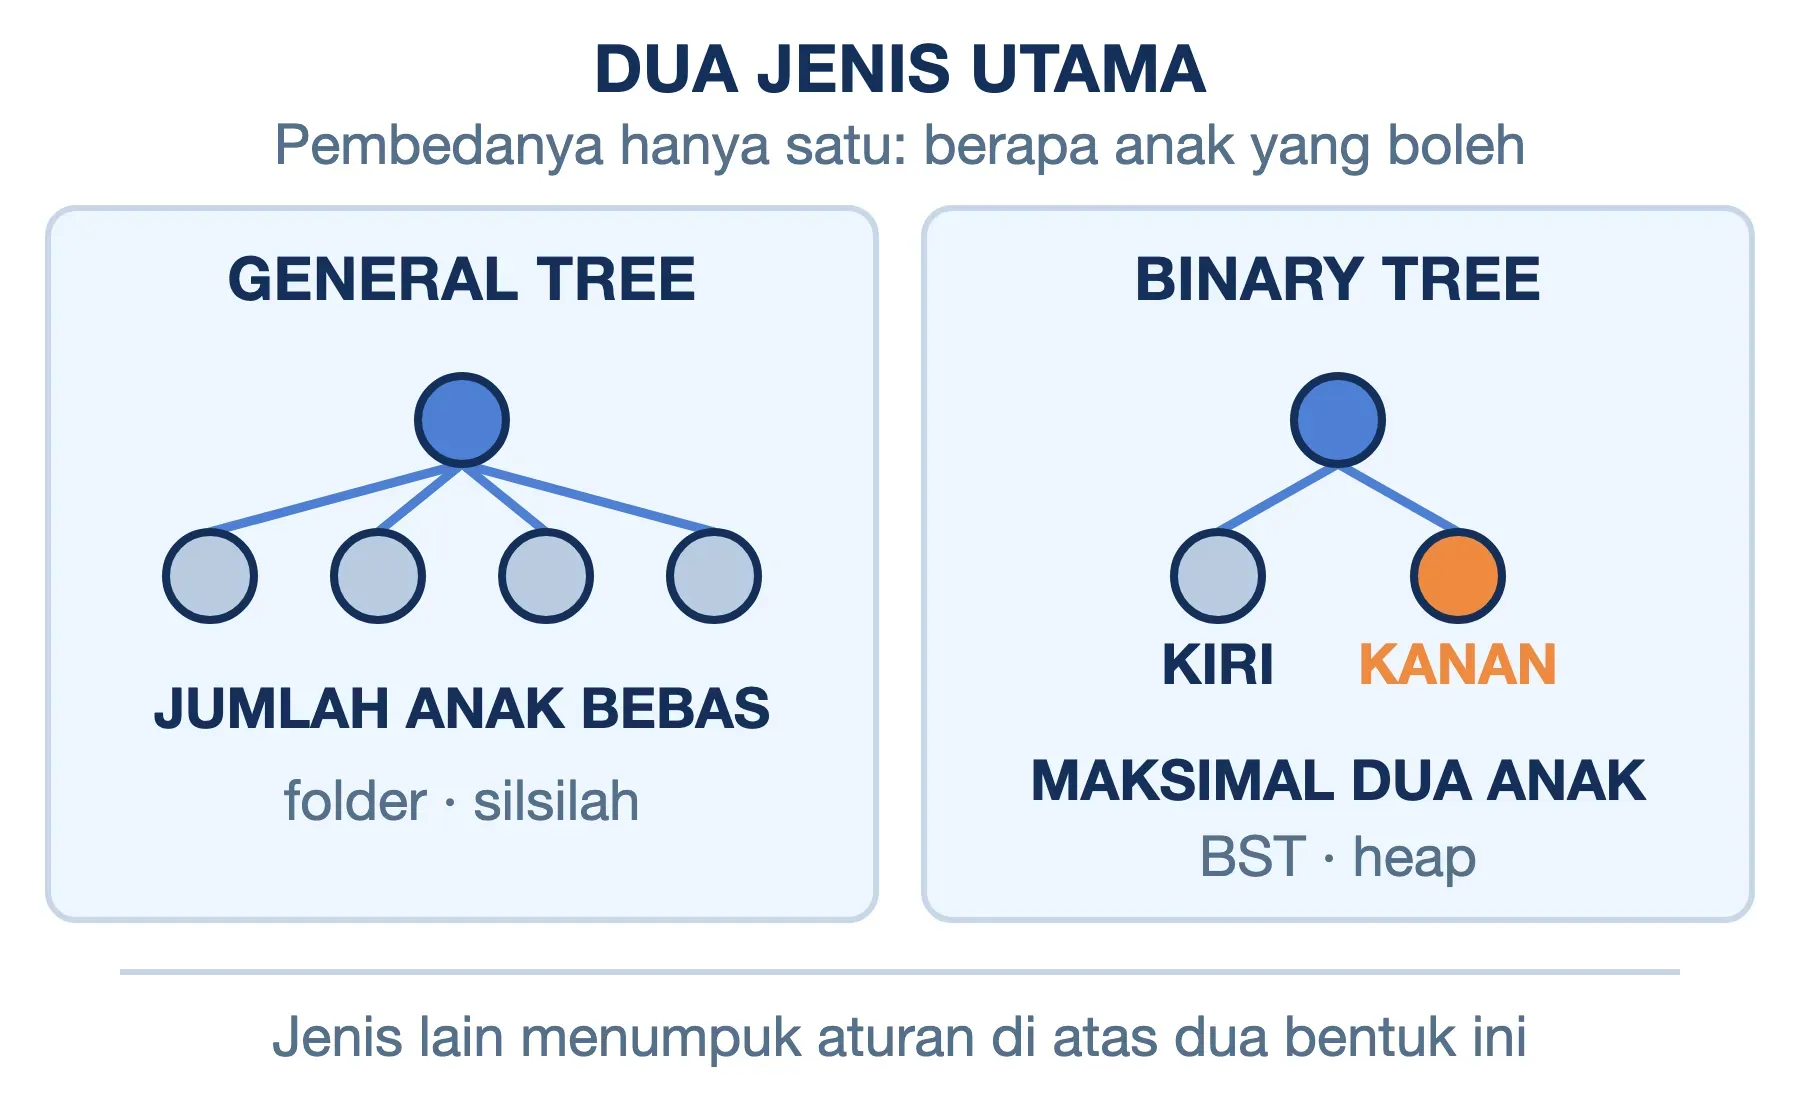
Pembagian yang paling dasar bersandar pada satu pertanyaan: berapa banyak anak yang boleh dimiliki satu simpul? Jawaban atas pertanyaan itu membelah tree menjadi dua jenis utama.
General tree membebaskan jumlah anak. Satu simpul boleh punya satu anak, boleh punya sepuluh, boleh tidak punya sama sekali. Folder di komputer, silsilah keluarga, dan bagan struktur organisasi semuanya general tree. Varian yang membatasi jumlah anak maksimal N disebut N-ary tree.
Binary tree membatasi jumlah anak maksimal dua, dan kedua posisinya dibedakan secara tegas menjadi anak kiri dan anak kanan. Pembatasan inilah yang memungkinkan aturan-aturan tambahan dipasang di atasnya.
Pembagian setelah itu tidak lagi soal jumlah anak, melainkan soal aturan tambahan yang ditumpuk pada bentuk dasarnya. Karena aturannya bisa dikombinasikan, penomoran seperti "empat klasifikasi tree" berbeda-beda antar materi ajar. Yang konsisten adalah nama variannya, bukan jumlahnya.
Binary Tree dan Tiga Bentuk Khususnya
Di dalam binary tree sendiri ada tiga bentuk yang punya nama sendiri. Full binary tree mewajibkan setiap simpul punya nol atau dua anak, tidak boleh satu. Complete binary tree mengisi semua level penuh kecuali level terakhir, yang harus terisi rapat dari kiri. Perfect binary tree atau binary tree sempurna mengisi semua level tanpa kecuali, sehingga jumlah simpulnya selalu 2 pangkat tinggi dikurangi 1.
Binary Search Tree
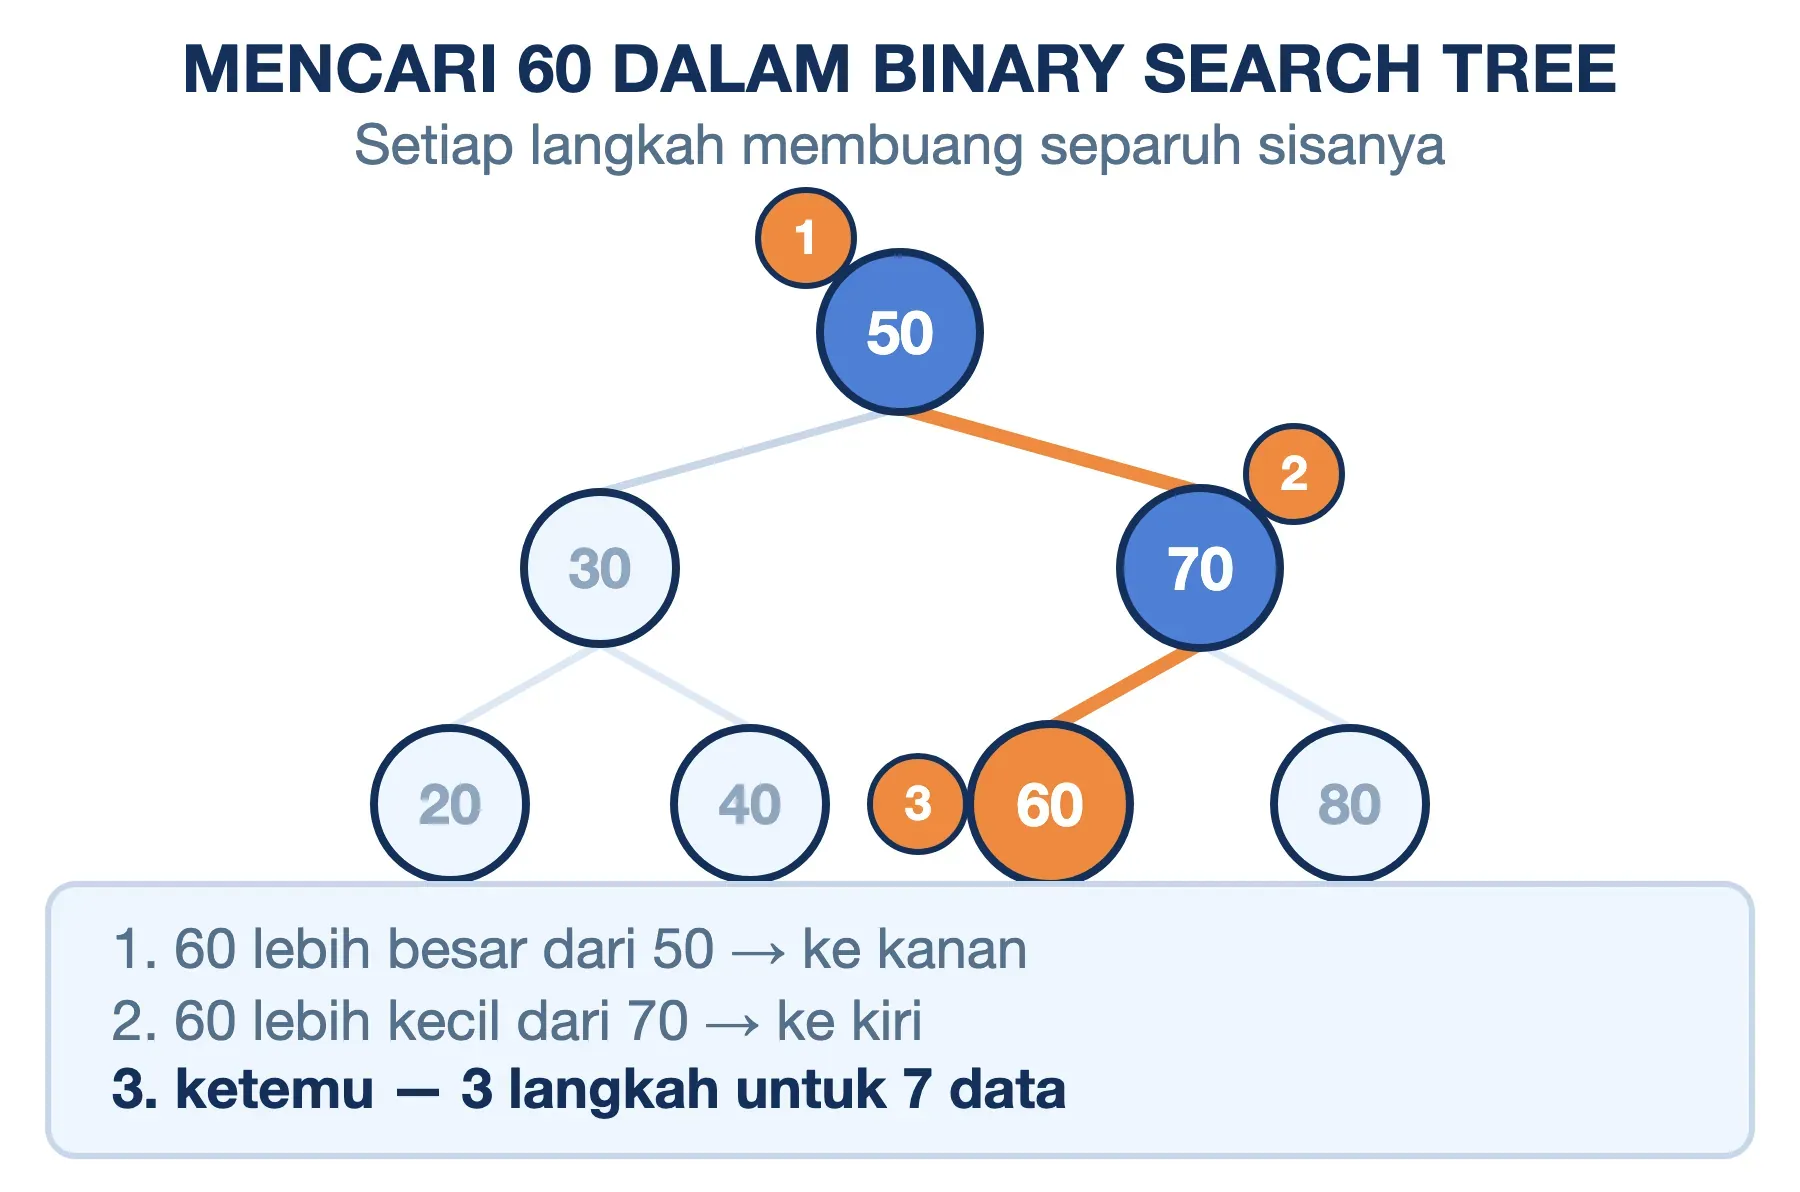
Binary search tree atau BST menambahkan satu aturan pada binary tree: seluruh nilai di subtree kiri harus lebih kecil dari nilai simpulnya, dan seluruh nilai di subtree kanan harus lebih besar. Aturan ini yang membuat pencariannya cepat.
Ambil BST berisi 50 di akar, dengan 30 dan 70 sebagai anaknya, lalu 20, 40, 60, dan 80 di baris bawah. Untuk mencari 60, kita mulai dari 50 dan melihat bahwa 60 lebih besar, jadi belok kanan ke 70. Di 70 kita melihat 60 lebih kecil, jadi belok kiri dan langsung menemukannya. Tiga perbandingan untuk tujuh data, bukan tujuh.
Balanced Tree: AVL dan Red-Black Tree
Balanced tree adalah BST yang memeriksa keseimbangannya sendiri setiap kali data masuk atau keluar, lalu menata ulang cabangnya kalau terlalu berat ke satu sisi. Dua varian yang paling banyak dipakai adalah AVL tree dan red-black tree.
Ini bukan konsep di atas kertas. Dokumentasi Java menjelaskan kelas java.util.TreeMap sebagai "A Red-Black tree based NavigableMap implementation". Di sana tertulis jaminan "guaranteed log(n) time cost" untuk operasi containsKey, get, put, dan remove. Kata "guaranteed" itu persis buah dari penyeimbangan otomatis.
B-Tree dan B+Tree
B-tree melonggarkan batas dua anak dan membiarkan satu simpul menampung banyak kunci sekaligus. Bentuk ini dirancang untuk data yang tinggal di disk, bukan di memori. Satu simpul bisa dibuat sebesar satu halaman disk, sehingga satu kali baca disk langsung memuat banyak kunci.
Inilah struktur yang dipakai index pada hampir semua database relasional. Pada MySQL, ukuran halaman InnoDB bawaan adalah 16.384 byte atau 16 KB. Kalau satu halaman sebesar itu memuat sekitar 1.000 kunci, B-tree setinggi tiga tingkat sudah menjangkau sekitar satu miliar baris.
Heap
Heap adalah complete binary tree dengan aturan vertikal: pada min-heap, nilai setiap induk tidak boleh lebih besar dari nilai anak-anaknya. Akibatnya nilai terkecil selalu berada di akar dan bisa diambil tanpa pencarian.
Modul heapq pada Python menuliskan invariannya secara eksplisit sebagai heap[k] <= heap[2*k+1] dan heap[k] <= heap[2*k+2]. Perhatikan bahwa indeksnya berupa angka, bukan penunjuk. Heap disimpan di dalam sebuah array atau list biasa, dan posisi anak dihitung dari indeks induknya.
Perbedaan heap dan binary search tree sering diminta dijelaskan. Keduanya binary tree, tetapi arah aturannya berbeda: BST mengurutkan ke kiri dan kanan sehingga seluruh isinya terurut, sedangkan heap hanya menjamin hubungan induk-anak secara vertikal. Heap tahu siapa yang terkecil, BST tahu urutan lengkapnya.
Trie
Trie atau prefix tree menyimpan teks dengan cara memecahnya per huruf, satu huruf per simpul. Jalur dari akar ke sebuah simpul membentuk satu awalan kata, sehingga seluruh kata yang berawalan sama berbagi cabang yang sama. Struktur ini yang menopang saran otomatis pada kotak pencarian.
Cara Menelusuri Tree: Preorder, Inorder, Postorder, dan Per Level
Menyimpan data di dalam tree baru berguna kalau kita bisa mengunjungi seluruh simpulnya secara teratur. Kegiatan itu disebut traversal (penelusuran), dan urutannya ditentukan oleh kapan simpul induk dikunjungi relatif terhadap anak-anaknya.
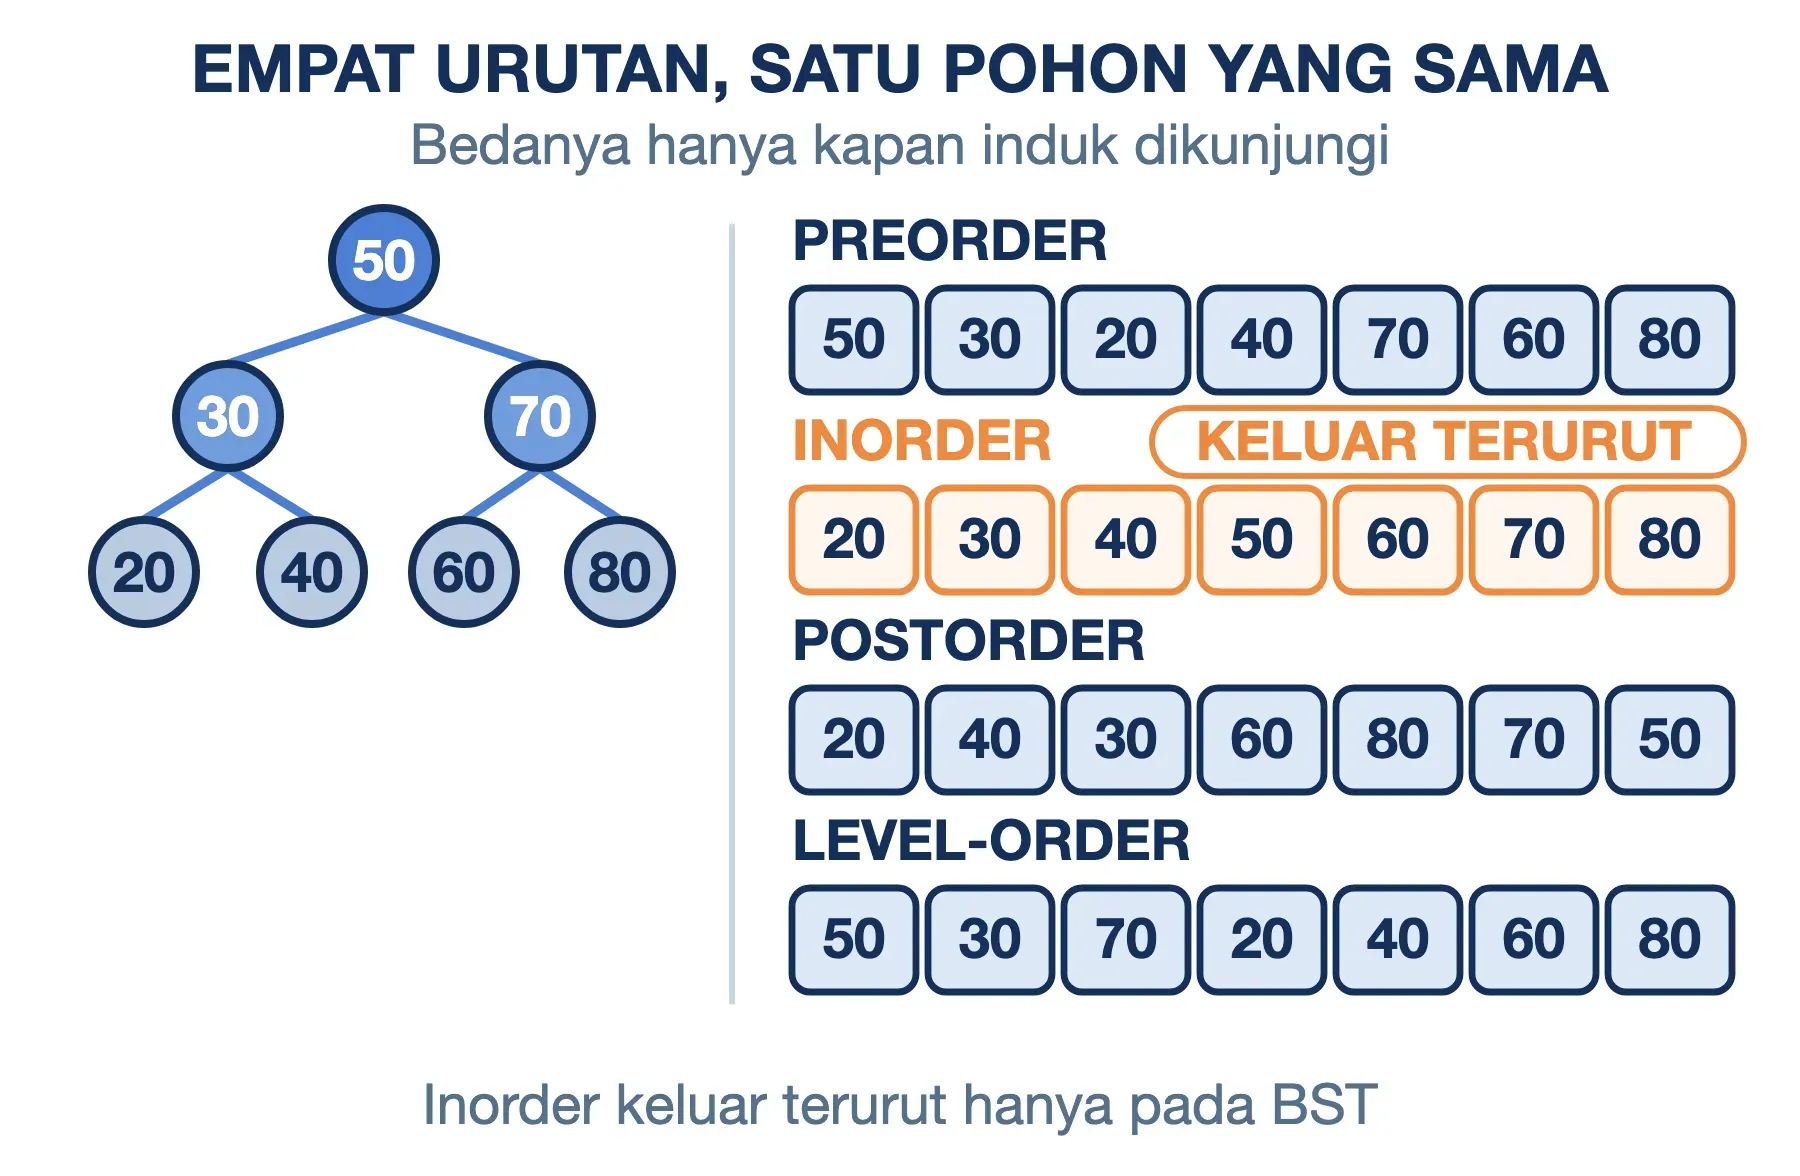
Kita pakai BST yang sama: 50 di akar, 30 dan 70 di bawahnya, lalu 20, 40, 60, dan 80.
| Penelusuran | Urutan kunjungan | Hasil pada BST acuan |
|---|---|---|
| Preorder | simpul → kiri → kanan | 50, 30, 20, 40, 70, 60, 80 |
| Inorder | kiri → simpul → kanan | 20, 30, 40, 50, 60, 70, 80 |
| Postorder | kiri → kanan → simpul | 20, 40, 30, 60, 80, 70, 50 |
| Level-order | baris demi baris dari atas | 50, 30, 70, 20, 40, 60, 80 |
Perhatikan baris inorder: angkanya keluar terurut dari kecil ke besar tanpa proses pengurutan tambahan. Sifat itu hanya berlaku pada binary search tree, dan itulah alasan perintah ORDER BY pada kolom berindeks bisa dilayani database tanpa mengurutkan ulang.
Keempat urutan itu bukan sekadar latihan. Masing-masing punya pemakaian yang khas, dan memilih yang salah membuat hasilnya keliru:
- Preorder untuk menyalin atau mengekspor struktur: Induk harus sudah ada sebelum anaknya dibuat, jadi induk wajib dikunjungi lebih dulu.
- Inorder untuk mengeluarkan isi BST secara terurut: Hanya urutan ini yang menghasilkan deret terurut.
- Postorder untuk menghapus atau menghitung ukuran: Perintah seperti
duharus menyelesaikan seluruh isi subfolder sebelum bisa melaporkan ukuran foldernya. - Level-order untuk mencari yang terdekat: Karena menyapu baris demi baris, urutan ini menemukan simpul terdekat dari akar lebih dulu.
Tiga urutan pertama bekerja dengan cara memanggil dirinya sendiri pada tiap subtree, sebuah pola algoritma yang disebut rekursi. Level-order berbeda, karena ia membutuhkan antrean untuk mengingat simpul mana yang harus dikunjungi berikutnya.
Contoh Struktur Data Tree: Silsilah dan Organisasi Kelas
Dua contoh berikut bisa Anda gambar sendiri dalam beberapa menit, dan keduanya memenuhi ketiga syarat tree.
Silsilah keluarga
Pohon acuan kita sepanjang artikel ini sebetulnya sebuah silsilah. Hasan menjadi root karena ia generasi tertua yang dicatat. Budi, Sari, dan Dedi berada di level 1 sebagai anak-anaknya, lalu Rina dan Tomi di level 2 sebagai anak Budi, dengan Fajar sebagai anak Dedi.
Silsilah keluarga menjadi contoh yang bagus karena syarat "satu induk per simpul" langsung terasa masuk akal saat menggunakan tree untuk memetakannya. Kalau silsilahnya diperluas hingga mencakup kedua orang tua setiap orang, bentuknya berhenti menjadi tree — setiap orang jadi punya dua induk, dan syarat pertama gugur.
Struktur organisasi kelas
Susunlah dari jabatan tertinggi ke bawah. Ketua kelas menjadi root. Wakil ketua, sekretaris, dan bendahara berada di level 1. Lalu seksi kebersihan dan seksi keamanan ditempatkan di level 2 di bawah wakil ketua.
Bagan kepengurusan memang contoh yang dipakai Buku Siswa Informatika Kelas IX untuk memperkenalkan tree. Gambar 2.2 di buku itu menyusun Ketua, Wakil Ketua, Bendahara, dua Koordinator bidang, lalu lima Divisi.
Hitung hasilnya: enam simpul dan lima garis. Sesuai rumus N−1, jadi gambar itu sah sebagai tree. Kalau Anda menambahkan garis dari sekretaris ke seksi kebersihan supaya terlihat "saling berkoordinasi", jumlah garisnya menjadi enam dan gambar itu berubah menjadi graph.
Folder di komputer
Contoh teknis yang paling dekat dengan pekerjaan sehari-hari. Pada Linux, Filesystem Hierarchy Standard menetapkan / sebagai akar tunggal, dengan direktori wajib seperti /bin, /etc, /usr, dan /var sebagai anaknya. Setiap berkas di dalam sistem punya tepat satu jalur dari akar.
Contoh Tree dalam Kehidupan Sehari-hari
Bentuk tree muncul di banyak tempat tanpa disebut namanya:
- Daftar isi buku: bab sebagai level 1, subbab sebagai level 2.
- Menu bertingkat di aplikasi: satu menu induk membuka beberapa submenu.
- Bagan pertandingan sistem gugur: juara sebagai root, peserta babak pertama sebagai leaf.
- Klasifikasi makhluk hidup: kingdom turun sampai spesies, tepat satu induk per tingkat.
Perbedaan Struktur Data Tree dan Graph
Tree dan graph sering dibandingkan seolah dua pilihan yang sederajat. Hubungannya sebenarnya bertingkat: tree adalah graph yang diberi pembatasan. Setiap tree adalah graph, tetapi tidak setiap graph adalah tree.
| Pembanding | Tree | Graph |
|---|---|---|
| Arah hubungan | Selalu dari induk ke anak | Boleh satu arah, boleh dua arah |
| Jumlah induk | Tepat satu, kecuali root | Bebas: nol atau banyak |
| Siklus | Tidak boleh ada | Boleh ada |
| Titik mula | Satu root yang pasti | Tidak ada titik mula khusus |
| Jumlah sisi untuk N simpul | Tepat N−1 | Antara 0 sampai N(N−1)/2 |
| Keterhubungan | Semua simpul pasti tersambung | Boleh terpisah beberapa kelompok |
| Contoh | Folder, silsilah, nama domain | Peta jalan, jaringan pertemanan |
Cara paling cepat memeriksanya adalah menghitung sisi, seperti pada bagian syarat di atas. Jika sebuah gambar punya N simpul, semuanya tersambung, dan sisinya tepat N−1, gambar itu pasti tree. Begitu ada satu sisi tambahan, siklus terbentuk dan statusnya berubah menjadi graph.
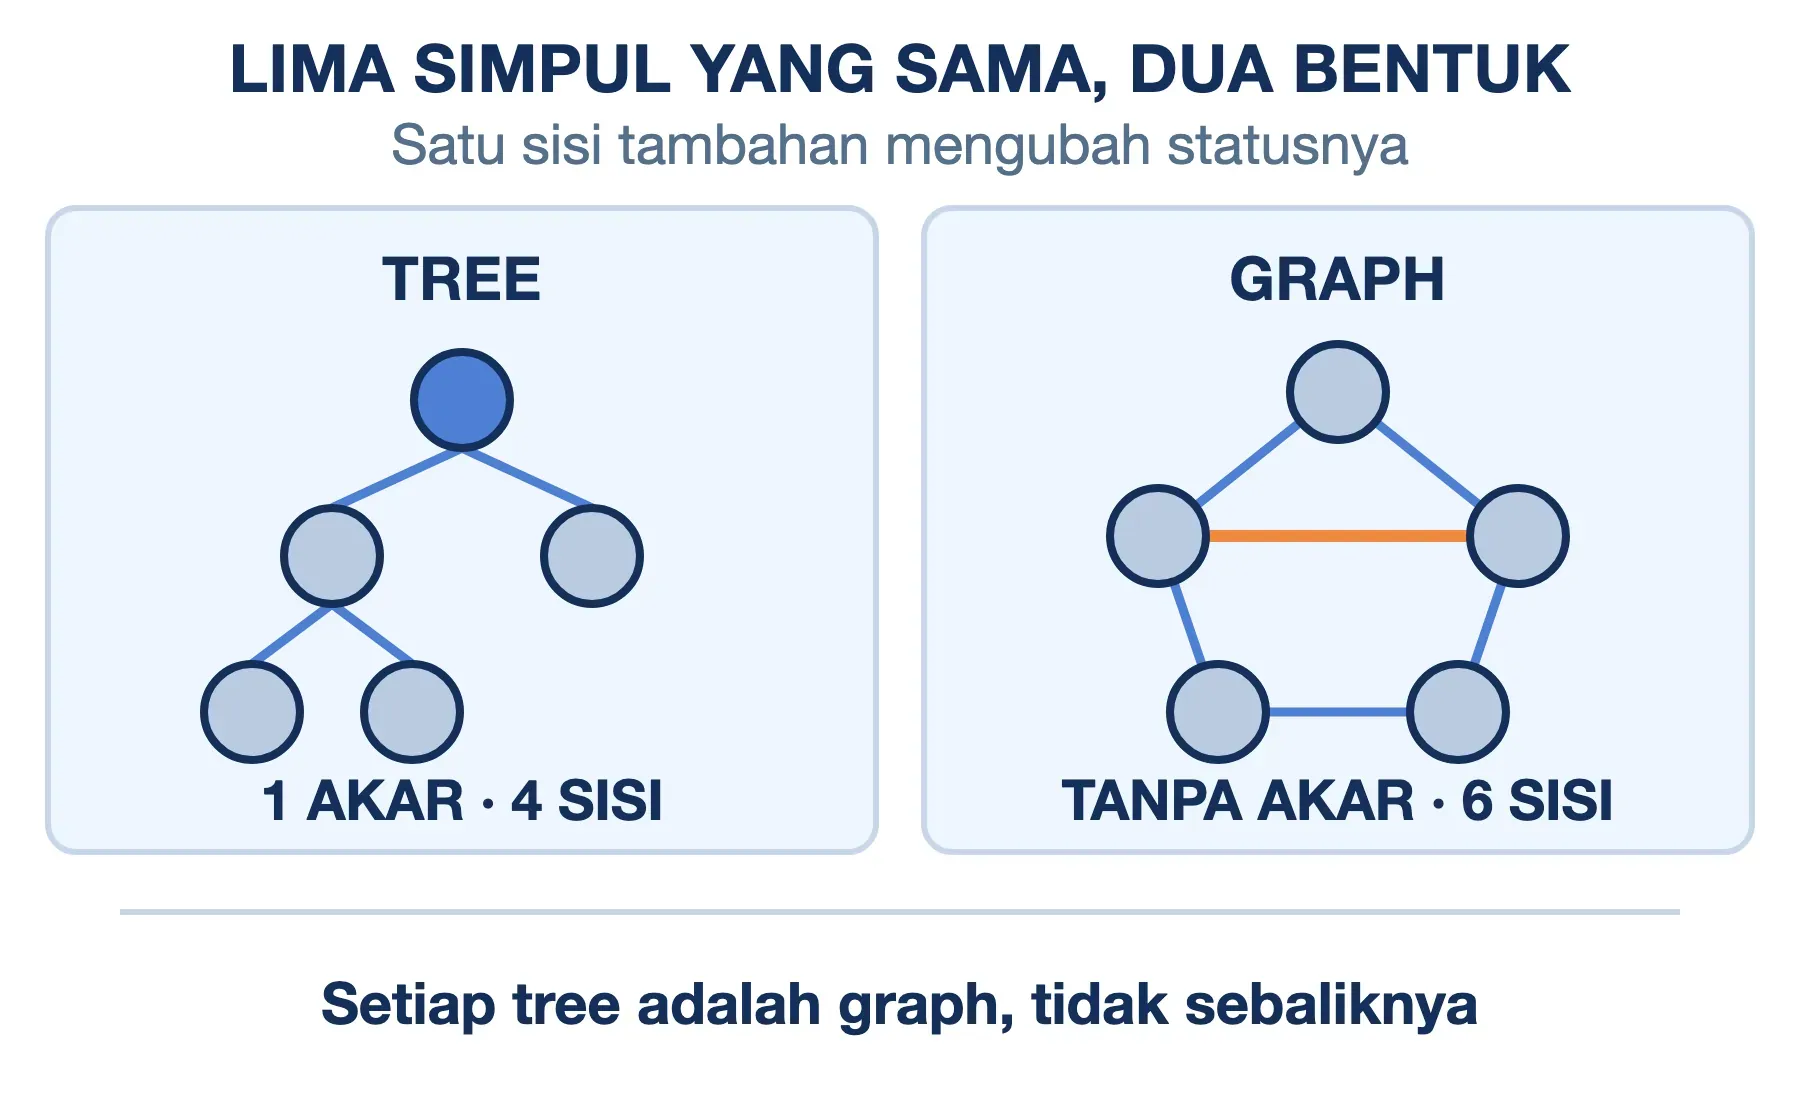
Perbedaan bentuk ini berujung pada perbedaan pemakaian. Tree menjawab pertanyaan tentang kepemilikan dan tingkatan, seperti "berkas ini ada di dalam folder apa". Graph menjawab pertanyaan tentang jalur dan hubungan bebas, seperti "rute mana yang terpendek dari A ke B".
Tree di Balik Perkakas yang Anda Pakai Hari Ini
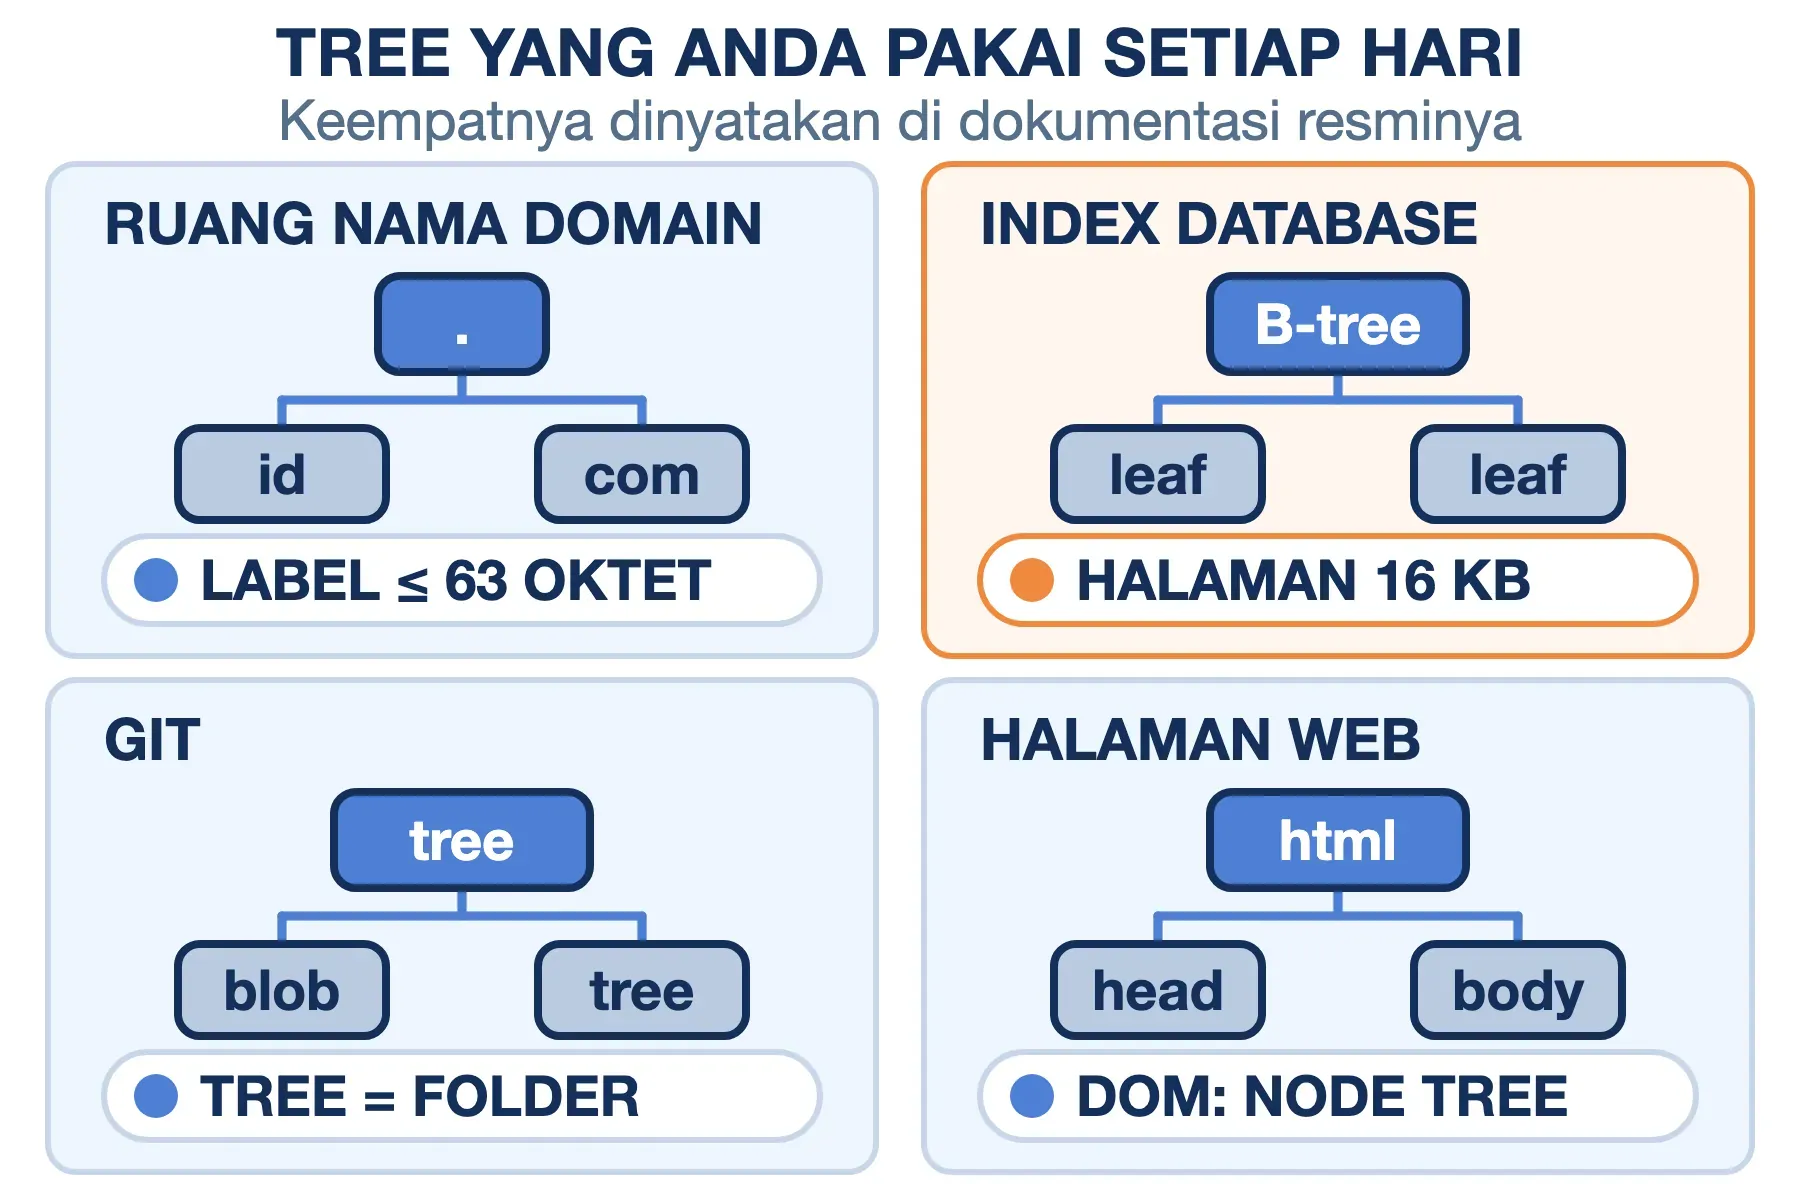
Contoh penggunaan tree paling meyakinkan bukan yang dikarang, melainkan yang bisa diperiksa. Bagian ini memakai kutipan dari dokumentasi resmi masing-masing sistem, supaya implementasinya bisa Anda buktikan sendiri.
- Ruang nama domain. RFC 1034 menyatakan langsung: "The domain name space is a tree structure". Root-nya adalah label dengan panjang nol. Setiap simpul punya label sepanjang 0 sampai 63 oktet, dan total satu nama domain dibatasi 255 oktet. Karena setiap label memakai minimal satu oktet panjang plus satu oktet isi, batas itu berarti maksimal sekitar 127 tingkat. Nama sebuah simpul, menurut RFC itu, adalah "the list of the labels on the path from the node to the root of the tree". Inilah sebabnya DNS dibaca dari kanan ke kiri.
- Index database. MySQL mencatat bahwa B-tree index bisa dipakai untuk operator
=,>,>=,<,<=, danBETWEEN, ditambahLIKEselama teksnya tidak dimulai dengan karakter wildcard. Hash index hanya melayani=dan<=>. Bentuk pohon yang terurutlah yang membuat rentang nilai bisa dilayani, dan hash table tidak punya keunggulan itu. - Git. Pro Git menjelaskan bahwa isi repositori disimpan sebagai tree dan blob object. Perbandingannya ditulis begini: "trees corresponding to UNIX directory entries and blobs corresponding more or less to inodes or file contents". Isi sebuah tree object bisa Anda lihat langsung dari terminal:
git cat-file -p master^{tree}Keluarannya berisi baris-baris mode, tipe, hash, dan nama berkas. Baris bertipe tree berarti subfolder, dan baris bertipe blob berarti berkas.
- Halaman web. DOM Living Standard mendefinisikan halaman sebagai node tree, dengan aturan root yang ditulis secara rekursif: "The root of an object is itself, if its parent is null, or else it is the root of its parent". Setiap elemen HTML yang Anda tulis menjadi satu simpul, dan JavaScript memanipulasi halaman dengan menelusuri pohon itu. Format bersarang seperti XML mengikuti pola yang sama.
- Sistem berkas modern. Dokumentasi Btrfs menyebutkan bahwa "Aside from the superblock, Btrfs consists entirely of several trees". Pohon-pohon itu antara lain root tree, extent tree, chunk tree, fs tree, dan checksum tree. Simpul dalam menyimpan penunjuk ke simpul berikutnya, dan simpul di level nol menyimpan datanya.
- Kompresi berkas. RFC 1951, spesifikasi di balik format
.zipdan.gz, menjelaskan kode Huffman sebagai pohon biner. Kode untuk sebuah simbol adalah "the sequence of 0's and 1's on the edges leading from the root to the leaf labeled with that symbol". Dekompresi berarti menuruni pohon itu satu bit sekaligus.
Fungsi dan Keunggulan Tree, Diukur dengan Angka
Kalau harus disebutkan dua fungsi utamanya, jawabannya: menyimpan hubungan bertingkat antardata, dan mempercepat pencarian dengan memangkas kemungkinan pada setiap langkah. Dari dua kegunaan itu, tree digunakan untuk apa pun yang punya tingkatan — dari susunan folder sampai index database.
Pemangkasan itu bisa dihitung, bukan sekadar diklaim. Pada binary search tree yang seimbang, setiap perbandingan membuang separuh sisa data. Untuk 1.000 data cukup 10 langkah, untuk 1 juta data cukup 20 langkah, dan untuk 1 miliar data cukup 30 langkah.
Bandingkan dengan memeriksa daftar berbaris satu per satu. Untuk 1 juta data, rata-rata dibutuhkan 500.000 pemeriksaan sebelum data yang dicari ditemukan. Artinya tree yang seimbang menyelesaikan pekerjaan yang sama dengan sekitar 25.000 kali lebih sedikit langkah.
Dari dua fungsi itu turun beberapa kelebihan yang manfaatnya terasa saat dipakai:
- Hierarki tersimpan apa adanya: Hubungan induk-anak menjadi bagian dari strukturnya, bukan catatan tambahan yang harus dijaga sendiri.
- Biaya pencarian tumbuh sangat lambat: Menaikkan jumlah data seribu kali lipat hanya menambah sekitar 10 langkah.
- Menyisipkan data tidak menggeser data lain: Berbeda dengan array yang harus menggeser seluruh elemen sesudah titik sisip, tree hanya mengubah beberapa penunjuk.
- Isinya bisa dikeluarkan terurut kapan saja: Cukup satu penelusuran inorder pada BST.
- Ukurannya tumbuh sesuai kebutuhan: Tidak ada kapasitas yang harus ditetapkan lebih dulu.
Kelemahan Tree dan Hal yang Perlu Anda Pertimbangkan
Angka 20 langkah untuk 1 juta data tadi berlaku dengan satu syarat penting: pohonnya seimbang. Kalau syarat itu tidak dipenuhi, keunggulan tree hilang seluruhnya. Kekurangan berikut ini yang paling sering menggigit di praktik.
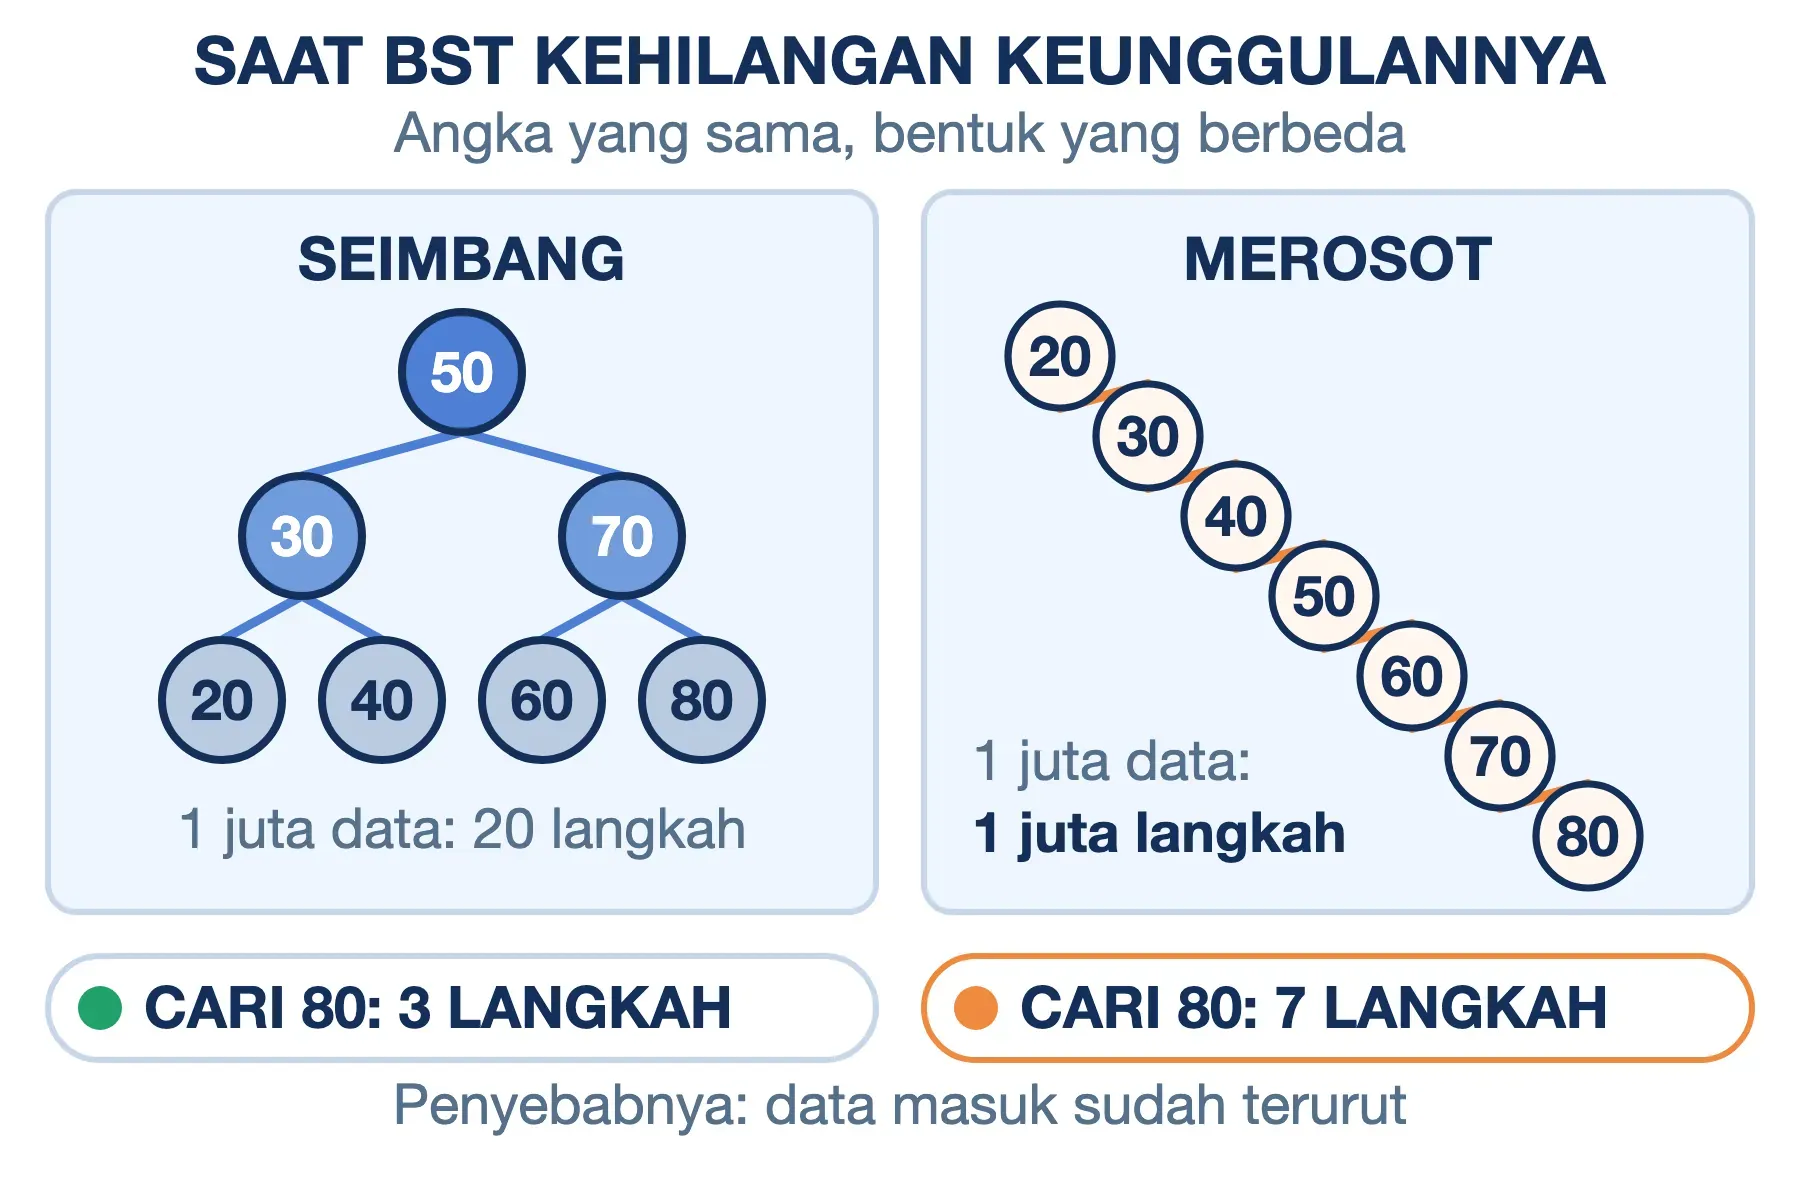
- BST bisa merosot menjadi rantai lurus. Masukkan angka 20, 30, 40, 50, 60, 70, 80 ke BST kosong secara berurutan. Setiap angka baru selalu lebih besar dari sebelumnya, sehingga selalu ditaruh di kanan. Hasilnya bukan pohon bercabang, melainkan rantai sepanjang tujuh simpul yang bentuknya identik dengan linked list. Pada 1 juta data terurut, pencarian yang seharusnya 20 langkah berubah menjadi 1 juta langkah. Inilah alasan AVL tree dan red-black tree diciptakan.
- Setiap simpul membawa biaya penunjuk. Satu simpul binary tree menyimpan nilainya plus dua alamat untuk anak kiri dan anak kanan. Pada data bernilai kecil, alamat-alamat itu bisa memakan memori lebih besar daripada datanya sendiri. Array tidak punya beban ini karena letak elemennya dihitung dari indeks.
- Penyeimbangan ulang menambah pekerjaan saat menulis. Balanced tree memeriksa dan menata ulang cabang setiap kali data masuk atau keluar. Pencariannya memang terjamin cepat, tetapi penulisannya lebih mahal daripada BST biasa.
- Tidak ada akses langsung ke posisi tertentu. Mengambil elemen ke-500 dari sebuah array selesai dalam satu langkah karena alamatnya dihitung. Pada tree, mencapai simpul tertentu selalu berarti menuruni jalur dari akar.
- Lebih rumit ditulis dan diperiksa. Operasi penghapusan pada BST punya tiga kasus berbeda, tergantung simpul yang dihapus punya nol, satu, atau dua anak. Kesalahan pada kasus ketiga tidak selalu langsung terlihat.
Jadi kapan sebaiknya tidak memakai tree? Kalau yang Anda butuhkan hanya mencari berdasarkan kunci yang persis dan urutan tidak dipedulikan, hash table lebih tepat. Rata-rata ia selesai dalam satu langkah, jauh di bawah 20 langkah tree. Kalau datanya memang tidak bertingkat dan jumlahnya sudah diketahui, array lebih hemat memori dan lebih sederhana.
Cara Membuat Struktur Data Tree Pertama Anda
Urutan tiga langkah di bawah ini sengaja menempatkan gambar sebelum kode, karena kesalahan bentuk jauh lebih mudah ditemukan di kertas daripada di dalam program.
Langkah #1: Gambar dulu di kertas, lalu hitung sisinya
Tulis satu simpul di puncak, lalu turunkan cabangnya. Setelah selesai, hitung jumlah simpul dan jumlah garisnya. Kalau garisnya bukan tepat satu lebih sedikit dari simpulnya, perbaiki gambarnya sebelum melanjutkan.
Kegiatan memecah masalah besar menjadi bagian bertingkat seperti ini adalah bentuk praktis dari berpikir komputasional.
Langkah #2: Terjemahkan gambarnya menjadi kode
Untuk general tree, bentuk paling sederhana adalah memetakan setiap simpul ke daftar anaknya. Contoh berikut memakai Python dan pohon acuan kita:
pohon = {
    "Hasan": ["Budi", "Sari", "Dedi"],
    "Budi":  ["Rina", "Tomi"],
    "Dedi":  ["Fajar"],
    "Sari":  [],
    "Rina":  [],
    "Tomi":  [],
    "Fajar": [],
}
Simpul yang daftarnya kosong adalah leaf. Root-nya adalah satu-satunya nama yang tidak pernah muncul sebagai anak siapa pun, yaitu Hasan.
Langkah #3: Uji dengan penelusuran
Cara tercepat memastikan strukturnya benar adalah mencetaknya bertingkat. Fungsi berikut menelusuri secara preorder dan memberi satu tingkat indentasi per level:
def telusuri(simpul, level=0):
    print("  " * level + simpul)
    for anak in pohon[simpul]:
        telusuri(anak, level + 1)

telusuri("Hasan")
Keluarannya menggambarkan ulang pohon Anda dalam bentuk teks:
Hasan
  Budi
    Rina
    Tomi
  Sari
  Dedi
    Fajar
Kalau ada nama yang tidak muncul, berarti nama itu belum terhubung ke akar. Kalau programnya berjalan tanpa henti sampai kehabisan memori, berarti ada siklus di dalam data Anda — syarat kedua terlanggar.
Pertanyaan yang Sering Diajukan
Struktur data tree dapat dibedakan menjadi dua jenis utama, yaitu apa?
General tree dan binary tree. General tree membebaskan jumlah anak setiap simpul, sedangkan binary tree membatasinya maksimal dua yaitu anak kiri dan anak kanan. Pembeda keduanya semata jumlah anak yang diizinkan.
Apa saja 4 klasifikasi struktur data tree?
Rincian yang paling sering dipakai adalah binary tree, binary search tree, balanced tree (AVL dan red-black), serta B-tree. Perlu diperhatikan bahwa jumlah empat ini konvensi materi ajar, bukan standar formal — sebagian materi memasukkan heap atau trie, sebagian memisahkan B-tree dan B+tree. Yang aman dihafal adalah nama variannya beserta aturan masing-masing.
Fungsi utama dari leaf dalam struktur data tree adalah apa?
Leaf adalah simpul tanpa anak, sehingga fungsinya menandai ujung cabang tempat penelusuran berhenti. Pada struktur seperti B-tree index dan pohon Huffman, leaf juga menjadi tempat data atau simbol sebenarnya disimpan, sementara simpul di atasnya hanya berisi penunjuk arah.
Simpul paling atas pada struktur data tree disebut apa?
Root atau akar. Root adalah satu-satunya simpul yang tidak punya induk, dan setiap tree hanya boleh punya satu root. Semua jalur di dalam tree bermula dari sana.
Level maksimum yang terdapat pada tree disebut apa?
Tinggi atau height dari tree tersebut, yang nilainya sama dengan tinggi root-nya. Kalau jalur terpanjang dari akar ke daun melewati dua sisi, tinggi pohon itu 2 dengan konvensi root di level 0.
Edge dalam struktur data tree adalah apa?
Edge atau sisi adalah garis yang menghubungkan dua simpul dan mewakili hubungan induk-anak di antaranya. Edge tidak menyimpan data. Tree dengan N simpul selalu punya tepat N−1 edge.
Tree termasuk struktur data linear atau non-linear?
Non-linear. Pada struktur linear setiap elemen punya paling banyak satu penerus, sedangkan satu simpul tree boleh punya beberapa anak. Karena itu tree bersama graph masuk kelompok struktur data non-linear.
Berapa jumlah sisi pada tree yang punya 10 simpul?
Sembilan. Jumlah sisi sebuah tree selalu N−1, karena setiap simpul selain root menyumbang tepat satu sisi ke induknya. Rumus ini berlaku untuk semua jenis tree, baik binary maupun general.
Apakah tree disebut dalam Capaian Pembelajaran Informatika?
Tidak. Dokumen Capaian Pembelajaran Informatika dari BSKAP tidak memuat kata "tree" maupun "pohon" sama sekali. Frasa "struktur data" hanya muncul tiga kali di sana, seluruhnya pada Fase F untuk kelas XI dan XII.
Materi tree di jenjang SMP datang dari Buku Siswa Informatika Kelas IX. Letaknya di sub-bab "A. Struktur Data" pada Bab 2 Berpikir Komputasional, halaman 27, dan dibahas berpasangan dengan graf. Buku itu juga menyebutkan bahwa kelas VII dan VIII lebih dulu membahas list dan stack. Jadi soal bertema tree di tingkat SMP bersumber dari buku teks, bukan dari rumusan capaian pembelajarannya.
Kesimpulan
Struktur data tree menyimpan data secara bertingkat dari satu akar tunggal, dengan tiga syarat yang harus dipenuhi bersamaan: setiap simpul punya tepat satu induk kecuali root, tidak ada jalur yang berputar, dan N simpul terhubung oleh tepat N−1 sisi. Syarat ketiga bisa Anda hitung sendiri untuk memeriksa gambar apa pun.
Pakailah tree ketika datanya memang bertingkat, atau ketika Anda butuh pencarian yang tetap cepat meski datanya membesar. Untuk satu juta data, angkanya 20 langkah — dengan catatan pohonnya seimbang. Kalau urutan tidak penting dan pencariannya hanya berdasarkan kunci persis, hash table lebih tepat. Kalau datanya datar dan jumlahnya sudah diketahui, array lebih hemat.
Semoga artikel ini membantu.