Hal pertama yang dipelajari siapa pun saat mulai menulis kode adalah variabel — sebuah nama yang menampung satu nilai. Selama datanya sedikit, cara ini sudah memadai.
Persoalannya muncul begitu datanya bertambah. Sebuah sekolah dengan 1.000 siswa tidak mungkin ditulis sebagai siswa1, siswa2, sampai siswa1000. Program juga kehilangan kemampuan menyapu seluruh data sekaligus, mencarinya, atau mengurutkannya. Yang dibutuhkan bukan seribu wadah terpisah, melainkan satu wadah yang menampung seribu nilai dengan aturan penataan yang jelas.
Wadah semacam itulah yang disebut struktur data. Struktur data adalah cara menata sekumpulan data di dalam memori komputer supaya bisa diakses dan diolah secara efisien. Setiap kali Anda menekan Ctrl+Z atau membuka folder bertingkat, ada struktur data yang sedang bekerja di belakangnya.
Struktur Data Adalah Cara Menata Data agar Bisa Diolah
Pengertian struktur data secara lengkap: metode penyusunan dan penyimpanan data di memori sebuah sistem komputer sehingga sekumpulan nilai dapat dikelola sebagai satu kesatuan. Setiap struktur membawa aturannya sendiri untuk menambah, membaca, mengubah, dan menghapus isi.
Kalau pertanyaannya dipersempit menjadi apa yang dimaksud dengan struktur data pada praktik sehari-hari, jawabannya ada pada satu kata: menata, bukan menyimpan. Menyimpan hanya soal meletakkan nilai di suatu tempat. Menata berarti menentukan hubungan antarnilai — mana yang berdekatan, mana yang menunjuk ke mana, dan lewat jalur apa sebuah nilai dapat ditemukan kembali.
Konsep struktur data selalu punya dua lapis yang perlu Anda bedakan sejak awal:
- Bentuk logis: gambaran di kepala programmer — deretan, tumpukan, antrean, pohon bercabang. Lapis ini disebut abstract data type (tipe data abstrak), yaitu perilaku yang dijanjikan tanpa memedulikan cara membuatnya.
- Penyimpanan fisik: cara data benar-benar diletakkan di memori, yaitu berurutan rapat dalam satu blok atau tersebar dan disambung dengan penunjuk alamat.
Definisi struktur data baru terasa konkret begitu kedua lapis itu dibedakan. Satu bentuk logis bisa punya beberapa penyimpanan fisik: antrean dapat dibangun di atas deretan rapat maupun rantai bersambung. Perilakunya sama, kecepatannya berbeda.
Bedanya Struktur Data, Tipe Data, dan Algoritma
Tiga istilah ini sering tertukar, padahal lapisannya berbeda.
Tipe data menjawab "satu nilai ini berbentuk apa?". Bilangan bulat, bilangan desimal, teks, atau benar/salah. Ia mengatur satu nilai tunggal.
Struktur data menjawab "banyak nilai ini disusun bagaimana?". Ia bekerja satu tingkat di atas tipe data: sebuah deretan bilangan bulat, sebuah antrean teks, sebuah pohon berisi angka.
Algoritma menjawab "nilai-nilai itu diolah dengan urutan langkah apa?". Algoritma adalah prosedurnya, struktur data adalah bahan yang diprosesnya. Penjelasan sisi yang satu lagi ada di artikel pengertian algoritma.
Hubungan keduanya dirumuskan Niklaus Wirth pada judul bukunya tahun 1976, Algorithms + Data Structures = Programs.
Perlu diperhatikan bahwa pilihan struktur data sering menentukan algoritma mana yang bisa dipakai. Pencarian biner hanya dapat berjalan kalau datanya tersimpan berurutan dan bisa diakses lewat nomor indeks. Pada rantai bersambung, algoritma itu kehilangan syaratnya.
Struktur Data Linear dan Non-Linear: Dasar Pembagiannya
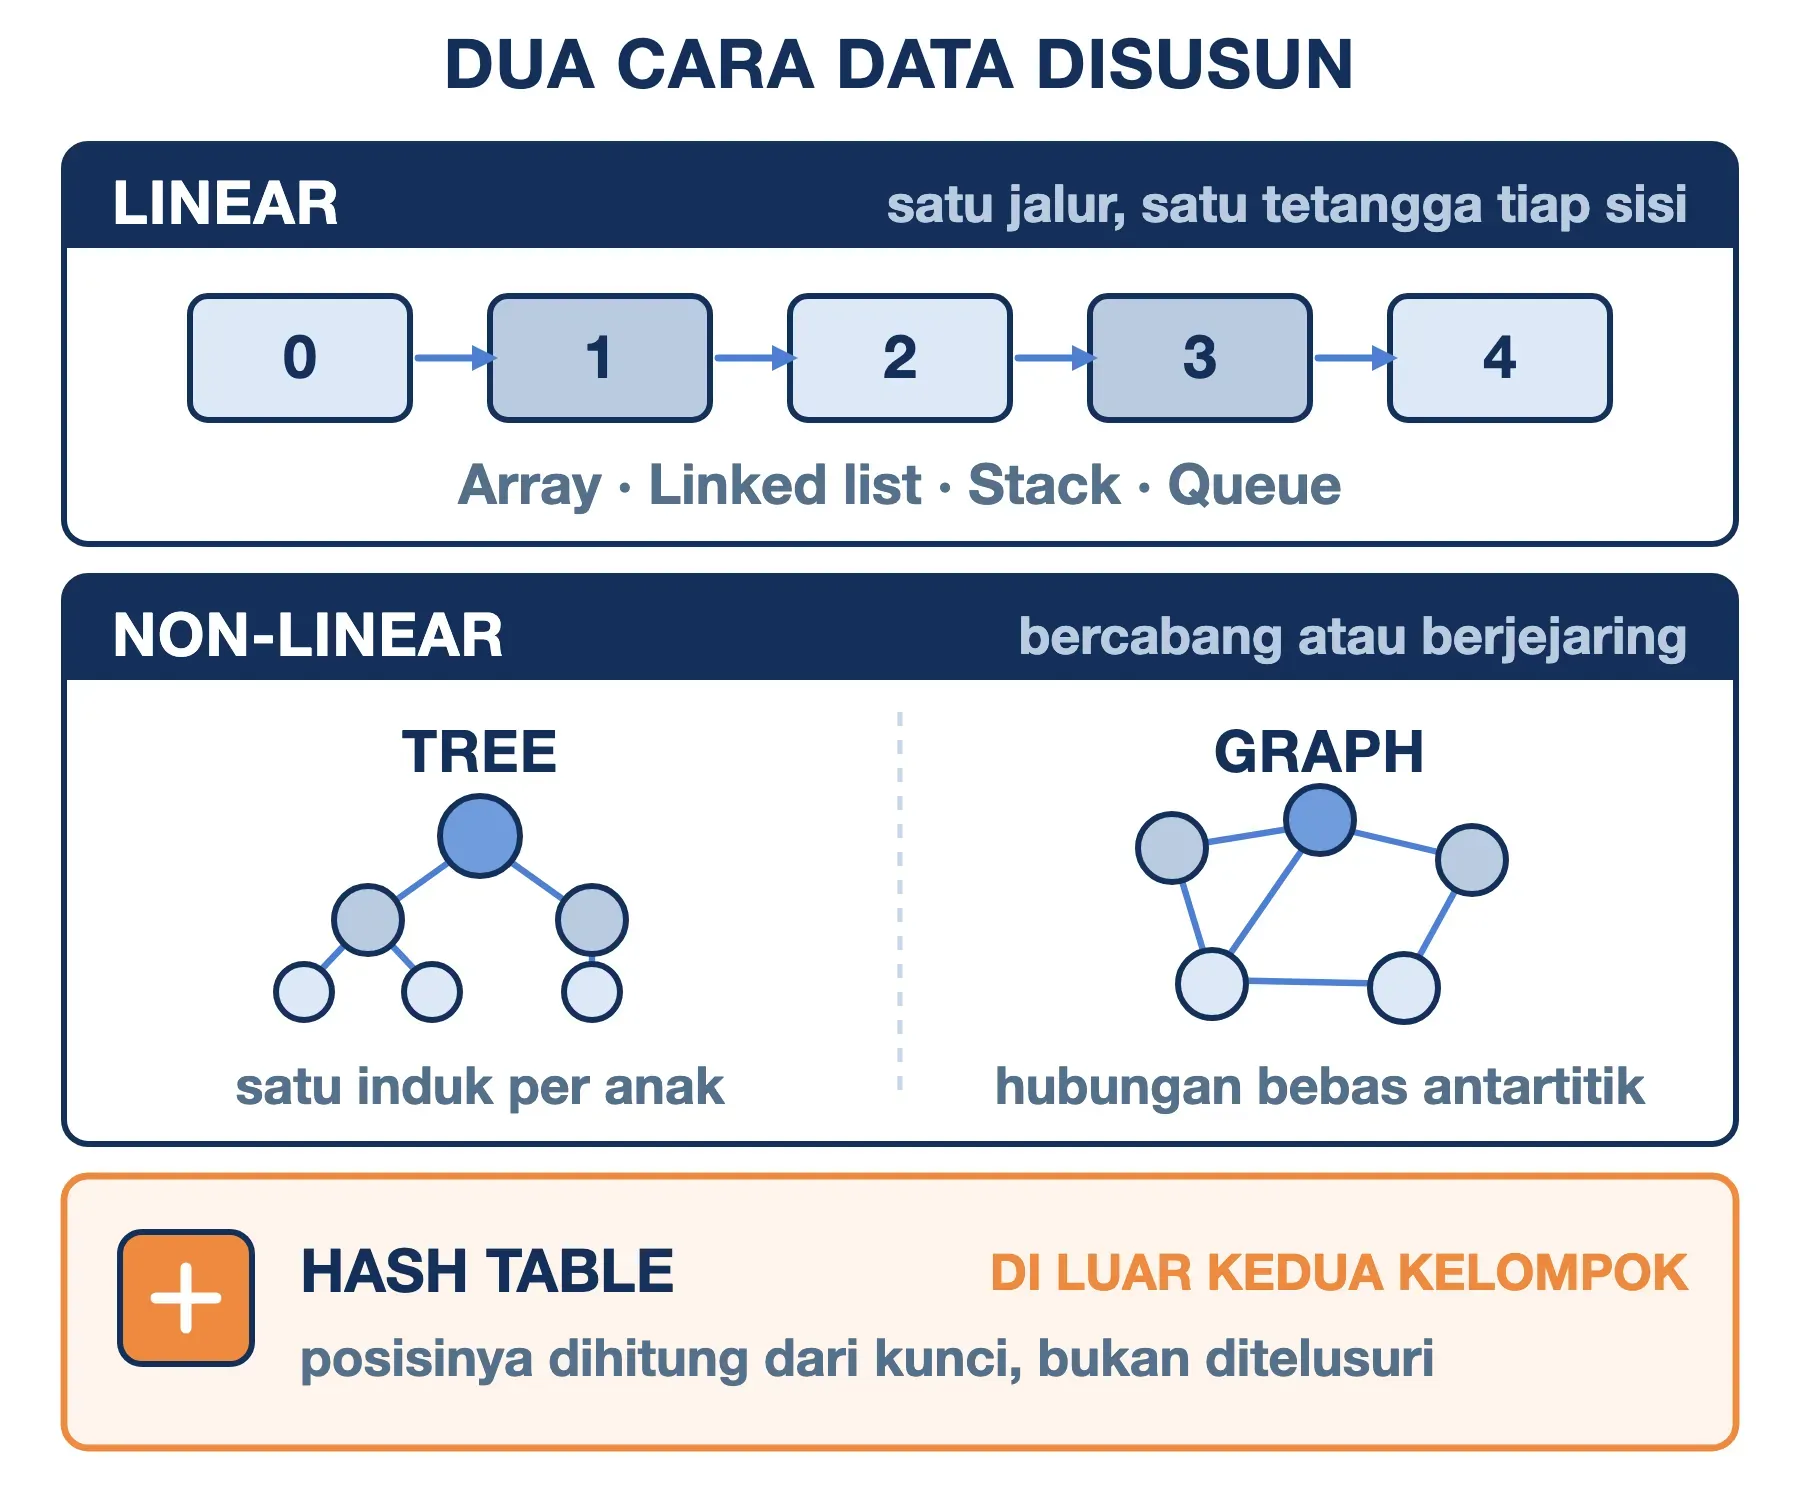
Jenis struktur data paling sering dibagi menurut satu pertanyaan: apakah setiap elemen hanya punya satu tetangga sebelum dan satu tetangga sesudahnya?
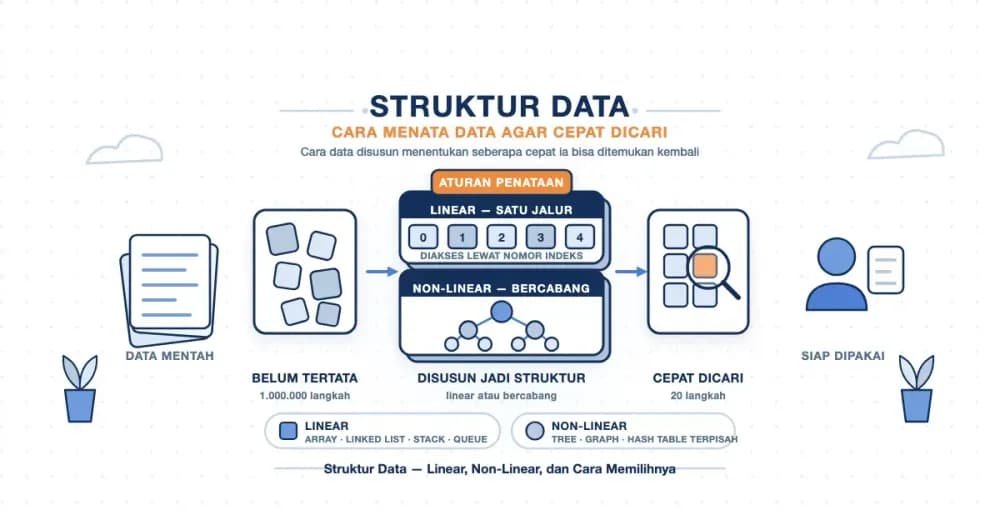
Struktur data linear menyusun elemen dalam satu jalur tunggal. Dari satu elemen, Anda hanya bisa maju atau mundur. Contoh struktur data linear adalah array, linked list (sering disebut list atau daftar), stack, dan queue.
Struktur data non-linear — ditulis juga "non-linier", "nonlinier", atau "nonlinear" di banyak buku ajar — menyusun elemen secara bercabang atau berjejaring. Satu elemen bisa terhubung ke banyak elemen sekaligus, dan tidak ada urutan tunggal yang wajib diikuti. Tree dan graph adalah dua wakilnya.
Ada satu struktur yang tidak masuk rapi ke kedua kelompok, yaitu hash table. Ia tidak menyusun elemen dalam jalur maupun cabang, melainkan menghitung posisi setiap nilai dari kuncinya.
Struktur data juga dikategorikan lewat dua sudut lain, dan masing-masing menjawab pertanyaan berbeda:
- Primitif dan majemuk: struktur data primitif — disebut juga sederhana atau dasar — menampung satu nilai tunggal seperti bilangan bulat, karakter, atau nilai benar/salah. Struktur data majemuk (kompleks) menyusun banyak nilai sekaligus, dan semua yang dibahas selanjutnya di artikel ini masuk kelompok itu.
- Statis dan dinamis: struktur data statis punya ukuran tetap yang ditentukan sejak awal, misalnya array berukuran tetap. Struktur data dinamis bisa tumbuh dan menyusut saat program berjalan, misalnya linked list.
Satu anggota kelompok majemuk yang perlu Anda kenal adalah record (rekaman). Isinya beberapa nilai bertipe berbeda yang diperlakukan sebagai satu kesatuan — misalnya satu baris data siswa yang memuat nama, umur, dan nilai sekaligus.
Empat Struktur Data Linear yang Paling Sering Dipakai
Empat tipe struktur data berikut sama-sama menyusun elemen dalam satu jalur, tetapi memberi Anda kemampuan yang berbeda.
Array
Array (larik) adalah deretan elemen bertipe sama yang disimpan rapat berurutan di memori dan diakses lewat nomor indeks, umumnya dimulai dari 0. Ciri utama array adalah letaknya yang rapat dan ukuran tiap elemennya yang seragam. Berkat itu komputer dapat menghitung alamat elemen ke-500 secara langsung, tanpa melewati 499 elemen sebelumnya. Inilah yang membuat array menjadi struktur data paling umum sekaligus paling sederhana. Harganya dibayar saat menyisipkan elemen di tengah, karena semua elemen sesudahnya harus digeser satu posisi.
Linked List
Linked list (senarai berantai) menyimpan tiap elemen dalam sebuah node berisi dua hal: nilainya, dan penunjuk (pointer) ke alamat node berikutnya. Node-nya tidak perlu bersebelahan di memori, karena rantai penunjuk itulah yang menjaga urutannya.
Kegunaan utamanya adalah menyisipkan dan menghapus data tanpa menggeser apa pun — cukup mengubah dua penunjuk. Konsekuensinya, tidak ada akses langsung: mencari elemen ke-500 berarti menyusuri 499 node sebelumnya.
Stack
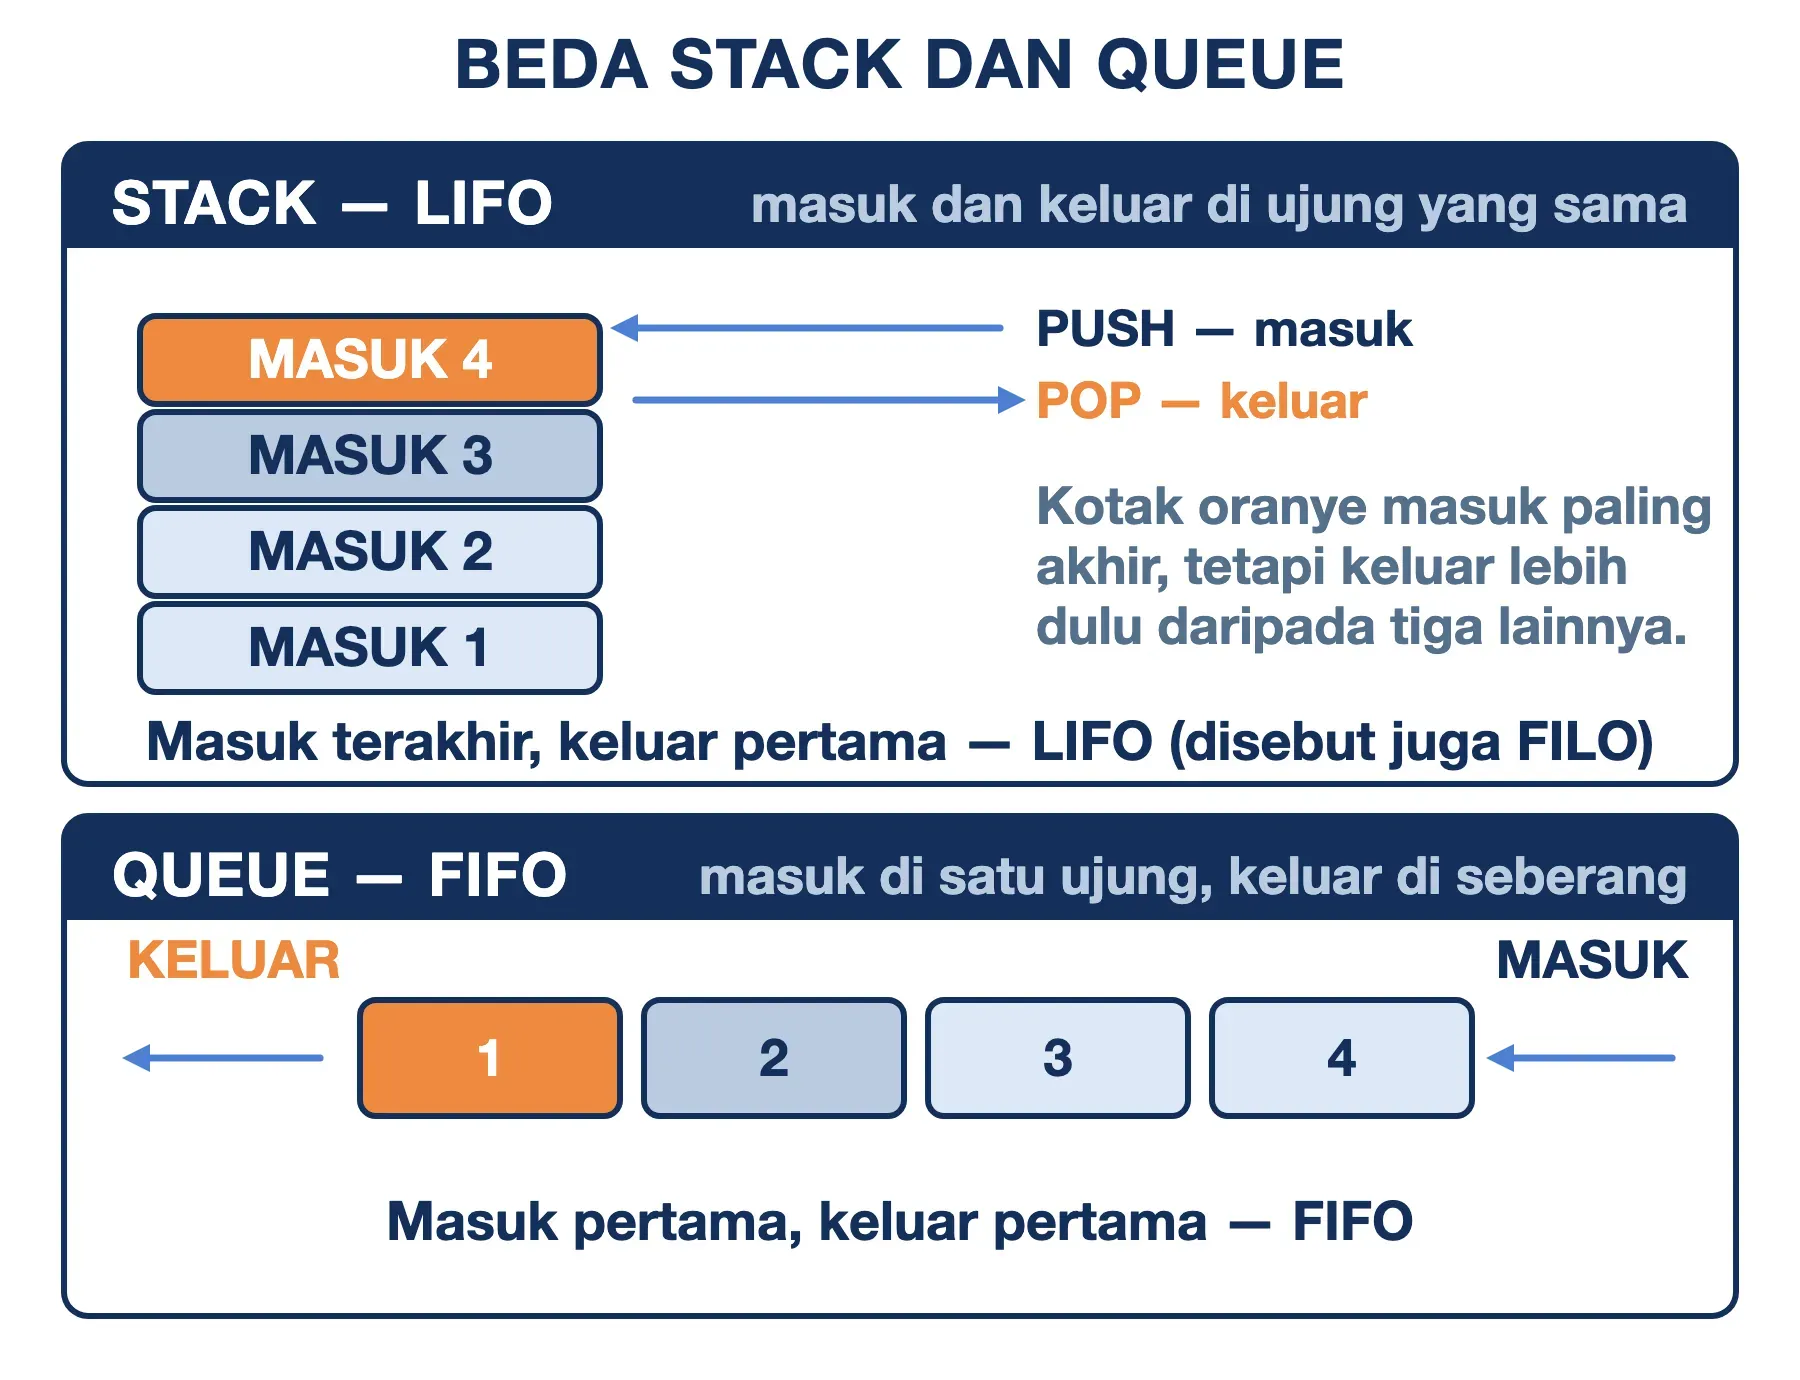
Stack (tumpukan) hanya mengizinkan penambahan dan pengambilan data di satu ujung yang sama, yang disebut puncak. Elemen yang masuk terakhir adalah yang keluar pertama. Prinsip ini dikenal sebagai LIFO (Last In First Out), disebut juga FILO (First In Last Out) — keduanya menggambarkan perilaku yang sama. Dua operasi dasarnya bernama push dan pop.
Dokumentasi resmi Python menyebutkan bahwa list bawaannya dapat dipakai langsung sebagai stack, dengan append() sebagai push dan pop() sebagai pop.
Queue
Queue (antrean) bekerja sebaliknya: data masuk lewat satu ujung dan keluar lewat ujung seberangnya. Elemen yang masuk pertama keluar pertama, prinsip yang disebut FIFO (First In First Out). Perilakunya persis seperti antrean di loket.
Queue dipakai setiap kali urutan kedatangan harus dihormati: antrean cetak, antrean tugas di server, atau antrean pesan antaraplikasi. Queue juga menjadi mesin penelusuran BFS (Breadth First Search), yaitu cara menyusuri tree atau graph tingkat demi tingkat.
Tree, Graph, dan Hash Table: Saat Data Tidak Cukup Berbaris
Tree
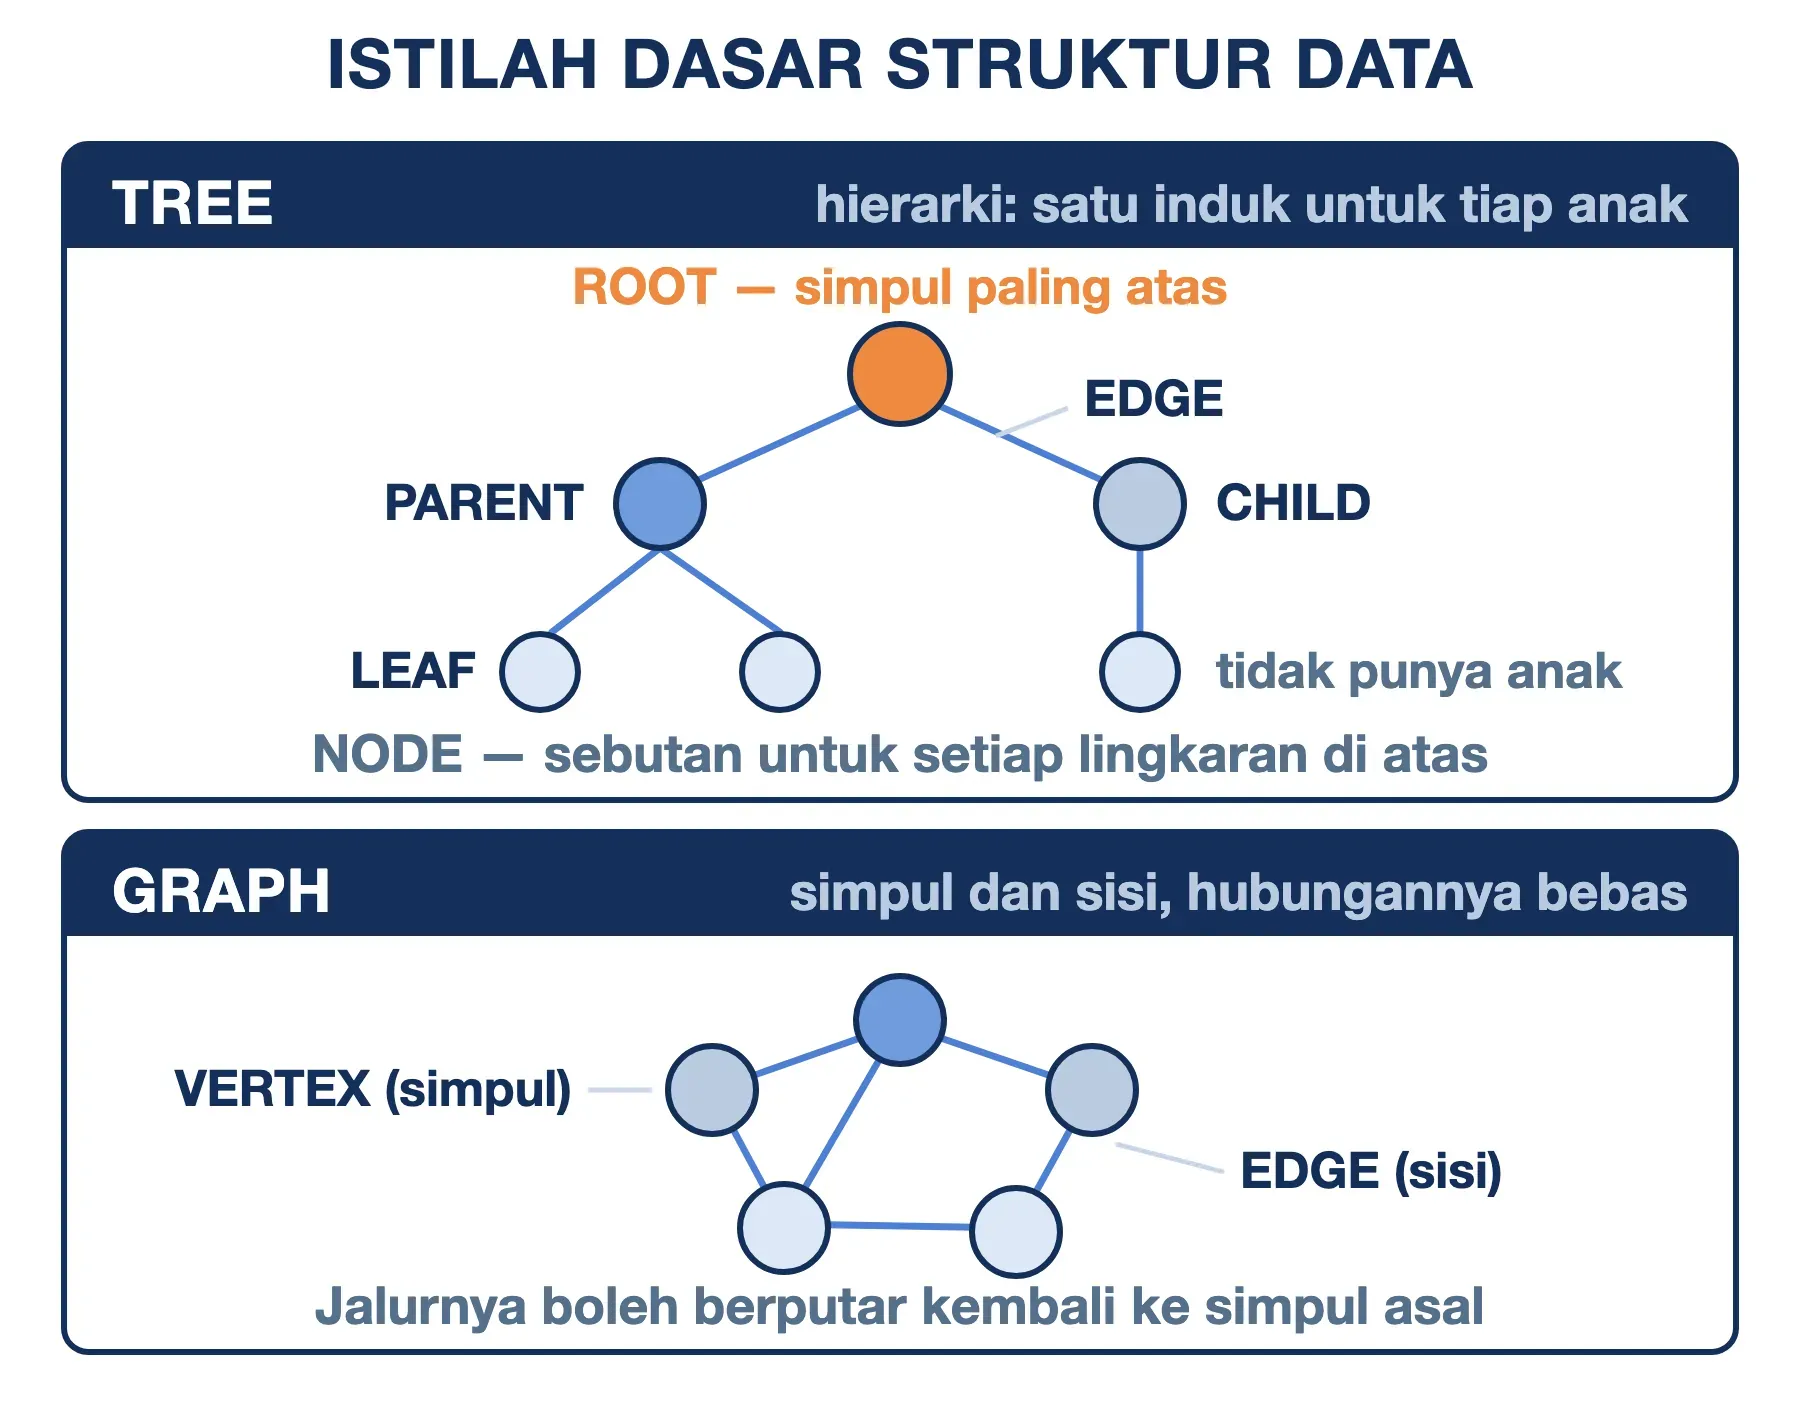
Tree (pohon) menyusun data secara hierarkis. Ciri utamanya: satu simpul induk boleh punya beberapa simpul anak, tetapi setiap anak hanya punya satu induk, dan tidak ada jalur yang berputar kembali. Struktur inilah yang paling umum dipakai ketika data bersifat majemuk non-linier. Contoh yang paling mudah dibayangkan adalah silsilah keluarga dan bagan struktur organisasi; contoh teknisnya susunan folder di komputer Anda dan hierarki nama domain di DNS.
Varian yang paling sering dibahas adalah binary search tree, yang menjaga satu aturan: nilai lebih kecil ke cabang kiri, nilai lebih besar ke cabang kanan. Aturan itu memangkas separuh kemungkinan pada setiap langkah pencarian.
Graph
Graph (graf) adalah struktur data yang terdiri dari simpul dan sisi. Simpul (vertex) mewakili entitas, sisi (edge) mewakili hubungan antarentitas. Berbeda dengan tree, graph membebaskan bentuk hubungannya: satu simpul boleh terhubung ke simpul mana pun, hubungannya boleh satu atau dua arah, dan jalurnya boleh berputar. Peta jalan adalah contohnya, dengan persimpangan sebagai simpul dan ruas jalan sebagai sisi.
Hash Table
Hash table (tabel hash) memetakan sebuah kunci ke sebuah nilai. Kuncinya diproses fungsi hash yang menghasilkan angka, dan angka itu menunjuk langsung ke lokasi penyimpanan nilainya. Karena posisinya dihitung dan bukan dicari, pengambilan data rata-rata selesai dalam satu langkah, berapa pun banyaknya data. Dua kunci berbeda bisa menghasilkan angka yang sama, peristiwa yang disebut tabrakan (collision).
Node, Simpul, Sisi, Root, dan Leaf: Istilah yang Sering Ditanyakan
Istilah berikut muncul di hampir semua materi struktur data, dan paling sering tertukar satu sama lain.
| Istilah | Artinya | Contoh |
|---|---|---|
| Node (simpul) | Elemen dasar penyimpan data; berisi nilai plus penunjuk ke node lain | Kotak berisi 7 dan alamat kotak berikutnya |
| Edge (sisi) | Penghubung dua simpul; mewakili hubungan, bukan data | Ruas jalan antara dua persimpangan |
| Root (akar) | Simpul paling atas, diibaratkan akar pohon; satu-satunya yang tanpa induk | Folder C:\ di Windows |
| Parent & child | Simpul di atas dan di bawahnya, satu tingkat | Documents adalah child dari C:\ |
| Leaf (daun) | Simpul tanpa anak; ujung cabang tempat penelusuran berhenti | Berkas laporan.pdf di folder terdalam |
| Degree | Jumlah anak sebuah simpul | Folder berisi 3 subfolder |
Dua istilah yang paling sering keliru dipertukarkan adalah node dan root. Semua root adalah node, tetapi hanya satu node dalam sebuah tree yang berstatus root. Begitu pula leaf, yang tetap node namun tanpa anak.
Fungsi Struktur Data, Diukur dengan Angka
Setelah memahami apa itu struktur data dan jenis-jenis struktur data di atas, pertanyaan berikutnya adalah seberapa besar pengaruhnya. Hampir semua penjelasan berhenti pada kata "efisien", padahal kata itu baru berarti kalau diganti dengan bilangan.
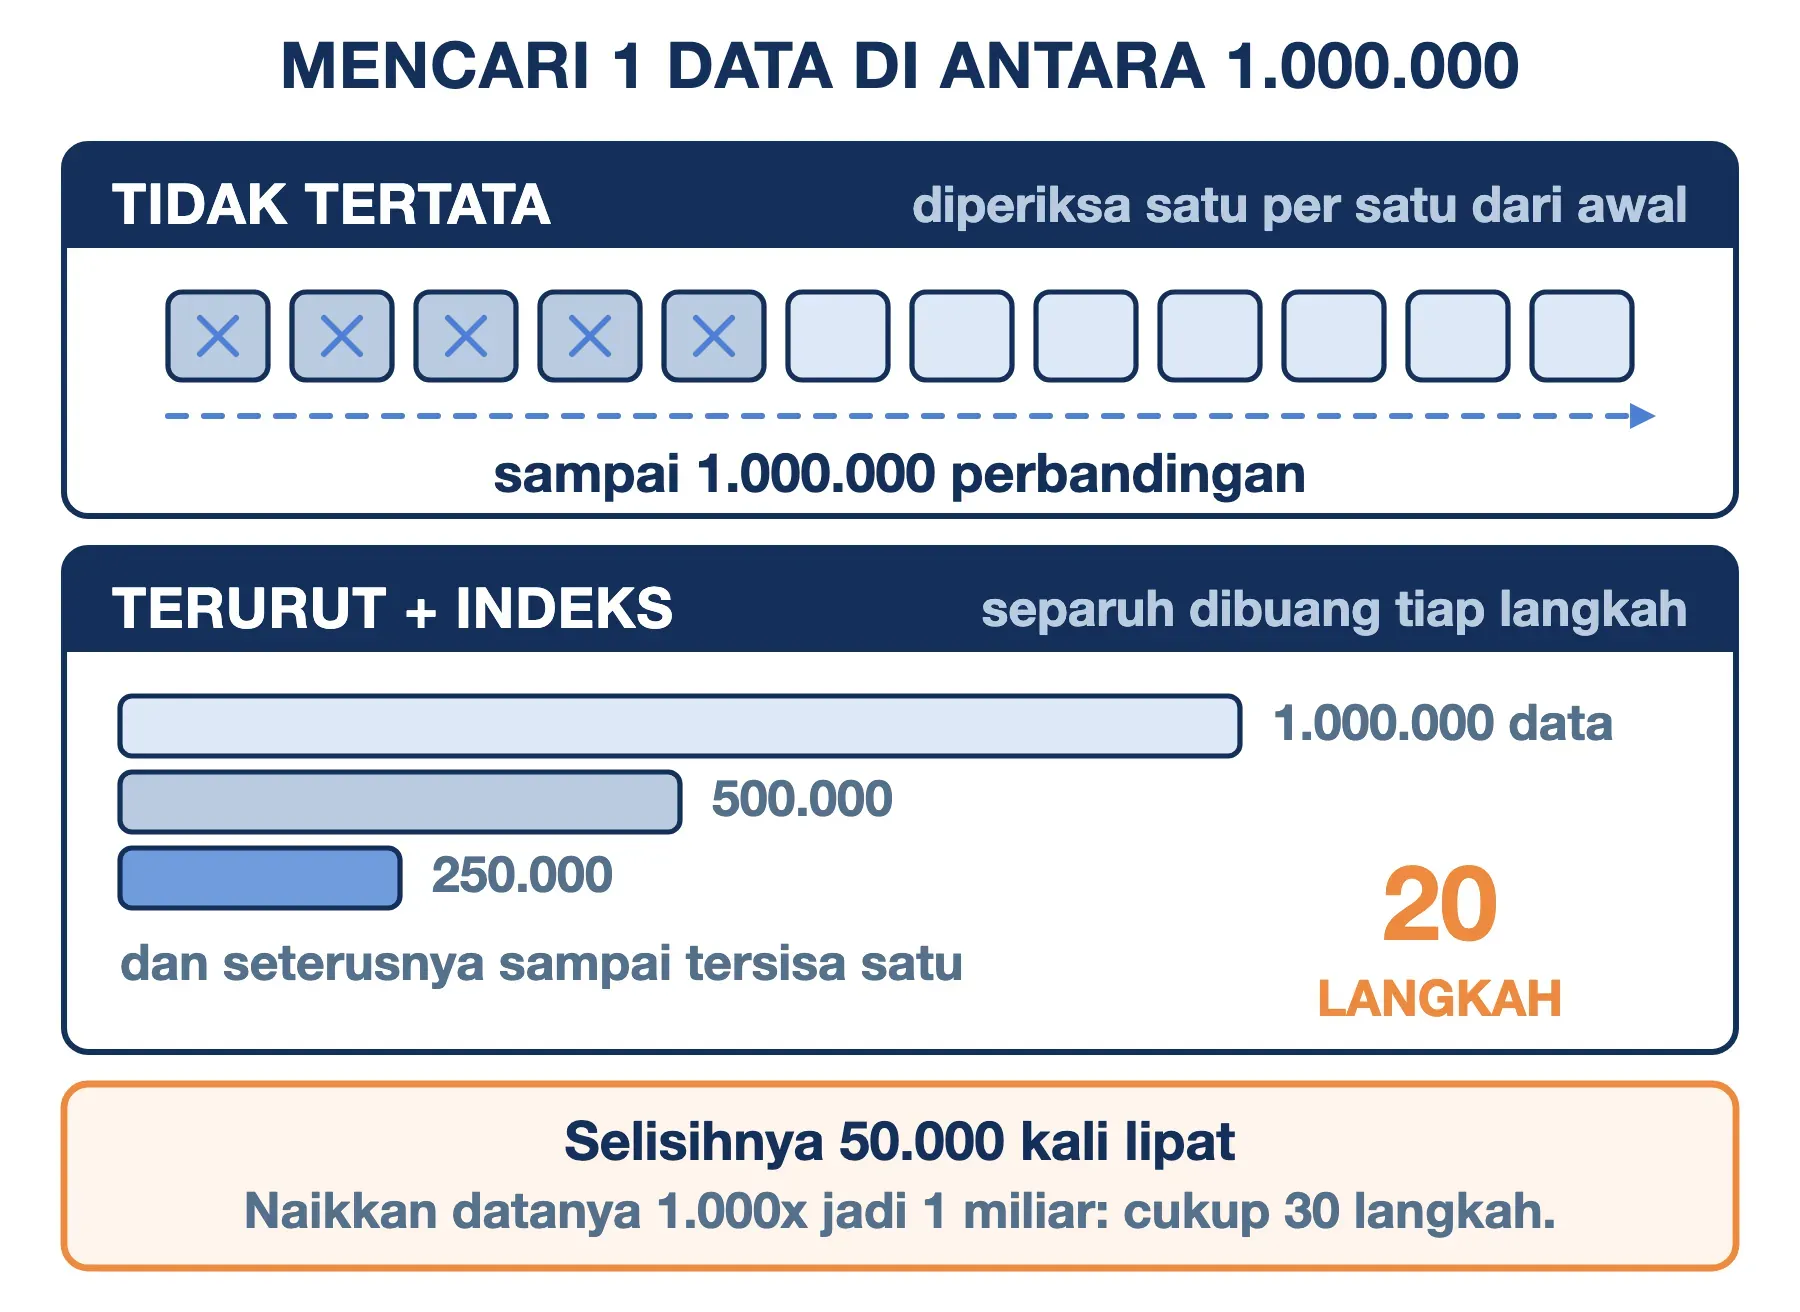
Bayangkan 1.000.000 data pelanggan. Tanpa penataan khusus, satu-satunya cara mencari seorang pelanggan adalah memeriksanya satu per satu dari awal — pada kasus terburuk 1.000.000 perbandingan.
Sekarang simpan data yang sama dalam keadaan terurut dan bisa diakses lewat indeks. Pencarian biner menjadi mungkin: periksa elemen tengah, buang separuh yang tidak mungkin, lalu ulangi. Jumlah langkahnya adalah logaritma basis dua dari jumlah data, yaitu 20 langkah — selisih 50.000 kali lipat untuk data yang sama persis.
Yang lebih penting adalah bagaimana selisih itu tumbuh. Naikkan datanya seribu kali lipat menjadi 1.000.000.000, dan pencarian biner hanya bertambah menjadi 30 langkah, sementara pencarian satu per satu bertambah menjadi satu miliar.
Dari sini terlihat struktur data digunakan untuk tiga hal:
- Menekan jumlah operasi yang harus dikerjakan: penataan yang tepat mengubah pekerjaan sebesar jumlah data menjadi sebesar logaritmanya.
- Menjaga performa saat data tumbuh: program tetap responsif ketika datanya bertambah seribu kali lipat.
- Menghemat memori dan menjaga kode terkelola: satu wadah beraturan jelas lebih mudah dirawat daripada ratusan variabel terpisah, dan itu berpengaruh langsung pada biaya pengembangan perangkat lunak.
Struktur Data di Balik Perkakas yang Anda Pakai Setiap Hari
Contoh penerapan struktur data dalam kehidupan sehari-hari lebih dekat daripada yang biasanya dibayangkan.
- Tombol Undo adalah stack. Perubahan ditumpuk di atas perubahan sebelumnya, dan Ctrl+Z mengambil yang paling atas.
- Antrean cetak adalah queue. Dokumen yang dikirim lebih dulu dicetak lebih dulu.
- Susunan folder dan nama domain adalah tree. Keduanya bercabang turun dari satu akar.
- Rute peta dan daftar pertemanan adalah graph. Keduanya perlu hubungan bebas antartitik, bukan hierarki.
- Kamus di bahasa pemrograman adalah hash table.
dictpada Python danHashMappada Java memakai prinsip yang sama.
Contoh yang paling menjelaskan datang dari database. Index pada MySQL disimpan dalam struktur B-tree, varian tree yang setiap simpulnya menampung banyak nilai sekaligus. Pilihan ini terlihat aneh, karena hash table rata-rata lebih cepat.
Manual resmi MySQL menjawabnya dengan tegas. Hash index hanya bisa dipakai untuk perbandingan kesetaraan dengan operator = dan <=>. Ia tidak dapat melayani <, >, atau BETWEEN, dan tidak bisa memakai sebagian kunci dari kiri. B-tree bisa melakukan ketiganya. Artinya query yang mencari transaksi antara dua tanggal gagal memanfaatkan hash index, sementara B-tree menanganinya dengan menelusuri daun yang bersebelahan.
Inilah wujud nyata pemilihan struktur data: yang tercepat rata-rata bukan berarti yang paling tepat.
Hal yang Perlu Anda Pertimbangkan
Setiap struktur data membayar kecepatannya di satu sisi dengan kelemahan di sisi lain. Empat hal berikut justru menjadi sumber masalah di kode nyata.
- Linked list membayar memori lebih mahal daripada yang terlihat. Pada sistem 64-bit, satu penunjuk berukuran 8 byte, sementara satu bilangan bulat biasa hanya 4 byte. Tambahan memorinya lebih dari 100 persen sebelum menghitung padding.
- Janji satu langkah pada hash table hanya berlaku rata-rata. Pada kasus terburuk, pencarian merosot menjadi O(n), sama lambatnya dengan memeriksa satu per satu. Penyebabnya adalah banyak kunci yang jatuh ke posisi sama, entah karena fungsi hash yang buruk atau pola data yang seragam.
- Binary search tree bisa kehilangan keunggulannya sendiri. Kalau data dimasukkan dalam keadaan sudah terurut, pohonnya tumbuh lurus ke satu sisi dan berubah menjadi rantai. Pencarian yang seharusnya log n kembali menjadi n. Itulah alasan lahirnya pohon berimbang seperti AVL dan red-black tree.
- Struktur rumit untuk data kecil justru merugikan. Untuk daftar berisi 50 item, array sederhana hampir selalu menang. Keunggulan struktur canggih baru terasa pada volume besar, sementara biaya kerumitannya dibayar sejak baris kode pertama.
Empat Pertanyaan untuk Memilih Struktur Data
Pemilihan struktur data menjadi jauh lebih mudah kalau dibalik menjadi pertanyaan berurutan.
- Operasi mana yang paling sering dijalankan? Paling sering membaca lewat posisi berarti array. Paling sering menyisipkan dan menghapus di tengah berarti linked list.
- Apakah urutan keluar-masuknya penting? Yang terakhir masuk harus keluar pertama berarti stack. Yang pertama masuk keluar pertama berarti queue.
- Apakah datanya bercabang atau berjejaring? Hierarki dengan satu induk per anak berarti tree. Hubungan bebas antartitik berarti graph.
- Perlu jangkauan, atau cukup cocok persis? Mencari kunci yang persis sama paling cepat dengan hash table. Perlu jangkauan seperti "antara 10 dan 50" berarti tree.
Tabel berikut merangkum kompleksitas rata-rata lima struktur paling umum. BST di baris terakhir adalah binary search tree. Notasi O(n) berarti waktu kerjanya tumbuh sebanding jumlah data, O(log n) tumbuh jauh lebih lambat, dan O(1) tidak terpengaruh jumlah data sama sekali.
| Struktur | Akses | Cari | Sisip |
|---|---|---|---|
| Array | O(1) | O(n) | O(n) |
| Linked list | O(n) | O(n) | O(1) |
| Stack/queue | O(n) | O(n) | O(1) |
| Hash table | — | O(1) | O(1) |
| BST | O(log n) | O(log n) | O(log n) |
Angka di tabel itu adalah rata-rata, dan justru di situ jebakannya. Kelima struktur punya kasus terburuk yang sama, yaitu O(n) — termasuk hash table dan BST yang rata-ratanya paling cepat. Angka rata-rata saja tidak cukup untuk mengambil keputusan.
Cara Mulai Belajar Struktur Data untuk Pemula
Materi struktur data terasa berat kalau langsung dimulai dari kode.
Langkah #1: Pastikan logika dasarnya sudah kuat
Pahami dulu variabel, kondisional, dan perulangan. Fondasi berpikirnya dibahas di artikel berpikir komputasional.
Langkah #2: Gambar dulu sebelum menulis kode
Gambar array sebagai kotak bernomor, linked list sebagai kotak berpanah, tree sebagai cabang. Kesalahan pemahaman hampir selalu terlihat di gambar sebelum terlihat di kode.
Langkah #3: Bangun ulang dengan tangan
Tulis sendiri stack dan queue memakai array, meskipun bahasa yang Anda pakai sudah menyediakannya. Lalu selesaikan 5 sampai 10 soal untuk tiap struktur, misalnya membalik teks dengan stack.
Pertanyaan yang Sering Diajukan
Struktur data apa yang paling sederhana?
Array. Ia hanya butuh satu aturan, yaitu elemen disimpan berurutan rapat dan diakses lewat nomor indeks. Tidak ada penunjuk, cabang, atau perhitungan posisi.
Apa bedanya struktur data stack dan queue?
Perbedaannya hanya pada tempat data keluar. Stack memasukkan dan mengeluarkan data di ujung yang sama, sehingga yang masuk terakhir keluar pertama. Queue mengeluarkan di ujung seberang tempat masuknya, yaitu struktur data yang menerapkan prinsip FIFO.
Struktur data yang menggunakan urutan LIFO dan FILO adalah?
Stack — struktur data yang menerapkan prinsip LIFO. LIFO dan FILO adalah dua nama untuk perilaku yang sama, yaitu elemen terakhir yang dimasukkan menjadi elemen pertama yang dikeluarkan.
Struktur data majemuk non-linier yang paling umum adalah?
Tree. Ia menyusun data secara bercabang dari satu akar, dengan setiap simpul anak hanya memiliki satu induk. Graph juga non-linier, tetapi hubungannya lebih bebas.
Apa 3 kegunaan struktur data?
Pertama, menekan jumlah operasi untuk mencari atau mengurutkan data. Kedua, menjaga performa tetap stabil saat volume datanya bertambah. Ketiga, membuat kode lebih hemat memori sekaligus lebih mudah dirawat.
Apakah struktur data sama dengan database?
Tidak, tetapi keduanya berhubungan erat. Struktur data menata data di memori saat program berjalan, sedangkan database menyimpannya secara permanen. Database justru dibangun di atas struktur data, misalnya B-tree untuk index.
Struktur data dipelajari di kelas berapa?
Struktur data Informatika sudah muncul sejak SMP, dan porsinya bertambah tiap tahun. Buku terbitan Kemendikbudristek memuat sub-bab Struktur Data di ketiga kelasnya. Kelas VII memperkenalkan definisi beserta contoh array, antrean, linked list, pohon, dan graf. Kelas VIII membahas tumpukan (stack) lewat analogi tumpukan buku dan tumpukan piring. Kelas IX masuk ke tree dan graf. Di jenjang SMA, Capaian Pembelajaran Fase F untuk kelas XI dan XII menaikkannya ke perancangan struktur data yang kompleks dan abstrak.
Kesimpulan
Struktur data adalah cara menata sekumpulan data di memori supaya bisa diakses dan diolah secara efisien. Pembagian utamanya ada dua. Linear seperti array, linked list, stack, dan queue menyusun data dalam satu jalur, sedangkan non-linear seperti tree dan graph menyusunnya bercabang atau berjejaring.
Pemilihannya benar-benar berpengaruh ketika datanya besar dan operasinya berulang. Untuk daftar berisi puluhan item, array sederhana sudah lebih dari memadai.
Semoga artikel ini membantu.