Komputer hanya mengenal angka. Prosesor, RAM, dan hard disk menyimpan segala sesuatu sebagai deretan bit bernilai 0 dan 1. Namun, yang Anda lihat di layar adalah huruf, emoji, foto, dan video. Jarak antara deretan angka itu dan tampilan yang bermakna dijembatani oleh satu konsep: encoding.
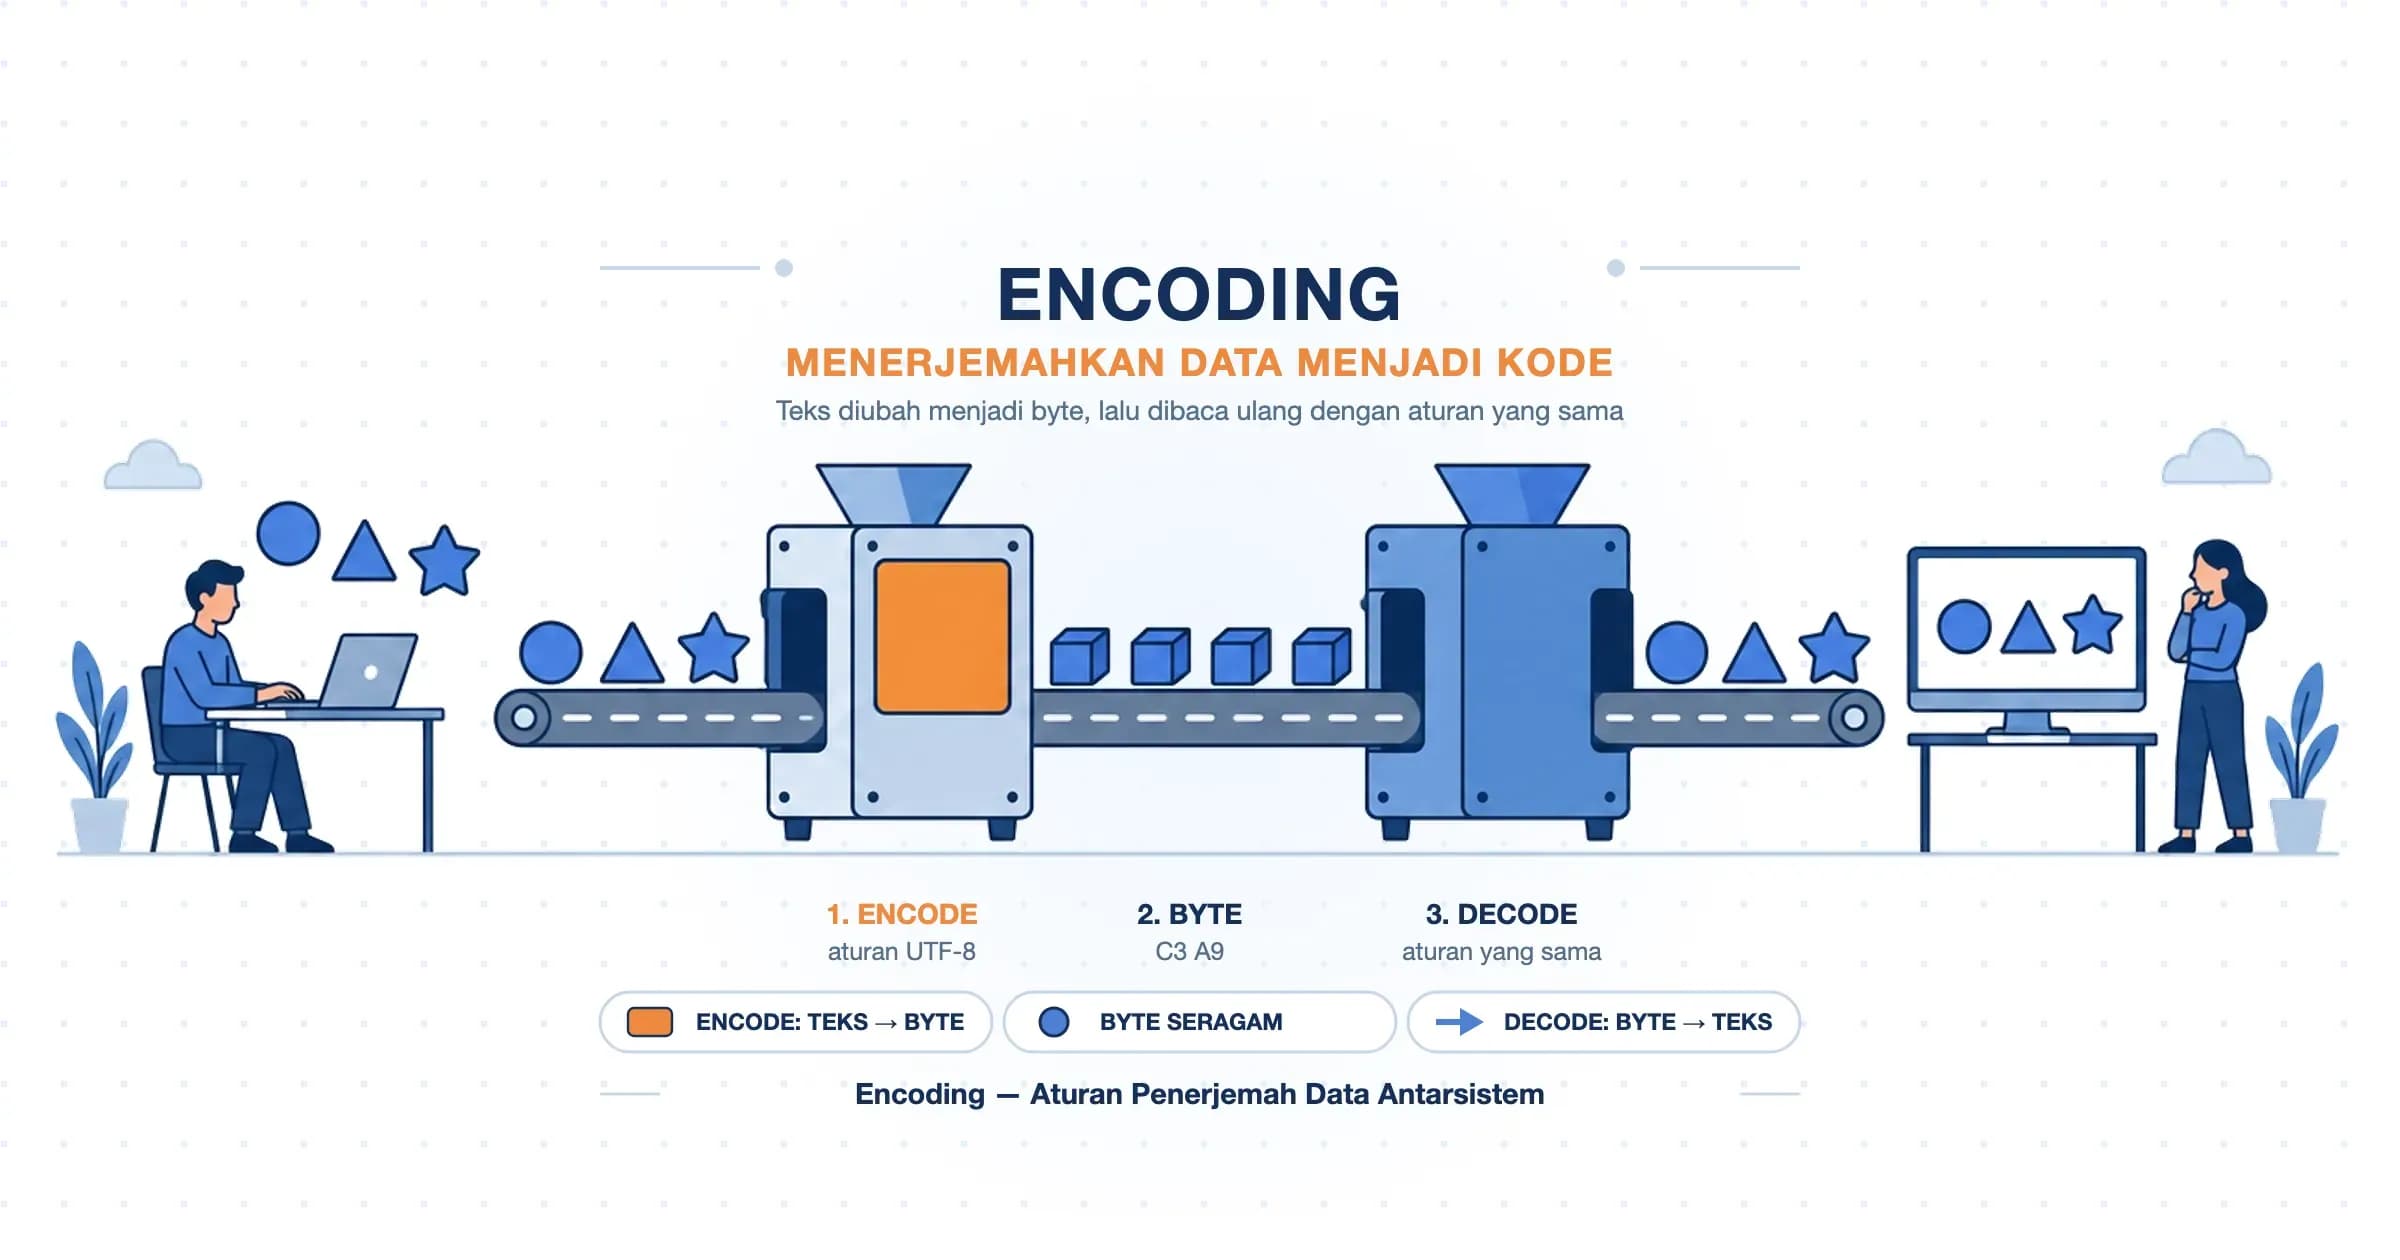
Encoding adalah proses mengubah data ke bentuk lain berdasarkan aturan yang disepakati. Tujuannya agar data bisa disimpan, dikirim, atau diproses oleh sistem lain. Konsep ini bekerja diam-diam di setiap halaman web yang Anda buka. Ia baru terasa ketika gagal, misalnya saat nama "Kafé" tiba-tiba tampil sebagai "Kafé".
Apa Itu Encoding?
Encoding adalah proses mengubah informasi ke dalam sistem kode tertentu agar bisa disimpan, dikirim, atau dibaca sistem lain. Dalam bahasa Indonesia, encoding artinya pengodean. Adapun encode adalah kata kerjanya, yaitu tindakan mengodekan. Program atau perangkat yang melakukannya disebut encoder.
Kata kuncinya adalah kesepakatan. Aturan encoding menentukan bahwa simbol tertentu diwakili oleh angka tertentu. Misalnya, pada tabel ASCII (American Standard Code for Information Interchange), huruf "A" diwakili angka 65. Di dalam memori, angka 65 itu tersimpan sebagai pola bit 01000001. Inilah sebabnya tipe data char di banyak bahasa pemrograman sebenarnya menyimpan angka.
Angka 65 sendiri tidak punya makna bawaan. Ia baru menjadi huruf "A" karena pengirim dan penerima memakai tabel yang sama. Kalau penerima memakai tabel berbeda, angka yang sama bisa ditampilkan sebagai simbol lain. Hampir semua masalah encoding berakar dari ketidakcocokan kesepakatan ini.
Encoding juga tidak hanya berlaku untuk teks. Gambar, suara, dan berkas biner pun dikodekan, masing-masing dengan tujuan berbeda.
Apa Itu Decoding dan Bedanya dengan Encoding?
Decoding adalah proses kebalikan dari encoding, yaitu mengubah data yang sudah dikodekan kembali ke bentuk yang bisa dipahami. Browser yang menerima deretan byte lalu menampilkannya sebagai huruf sedang melakukan decoding. Begitu pula pemutar video yang mengubah berkas MP4 menjadi gambar bergerak.
Jadi, encoding dan decoding adalah dua proses berpasangan: yang satu mengubah data menjadi kode, yang lain mengembalikannya. Keduanya hanya berhasil jika memakai aturan yang sama persis. Berikut perbedaan encoding dan decoding secara ringkas:
| Aspek | Encoding | Decoding |
|---|---|---|
| Arah | Bentuk asli → bentuk kode | Bentuk kode → bentuk asli |
| Pelaku umum | Pengirim, penyimpan, perekam | Penerima, pembaca, pemutar |
| Contoh teks | "é" → byte C3 A9 | byte C3 A9 → "é" |
| Contoh media | Kamera merekam ke H.264 | Pemutar video menampilkan H.264 |
| Kalau aturannya beda | — | Hasil rusak atau tidak terbaca |
Aturan encoding bersifat terbuka dan tidak memakai kunci rahasia. Siapa pun yang tahu nama aturannya bisa melakukan decoding.
Tiga Lapis Encoding yang Dilalui Satu Halaman Web
Sebuah kata yang Anda ketik di formulir website bisa melewati beberapa encoding berturut-turut sebelum sampai ke server. Supaya tidak tertukar, kami membaginya menjadi tiga lapis berdasarkan tujuannya.
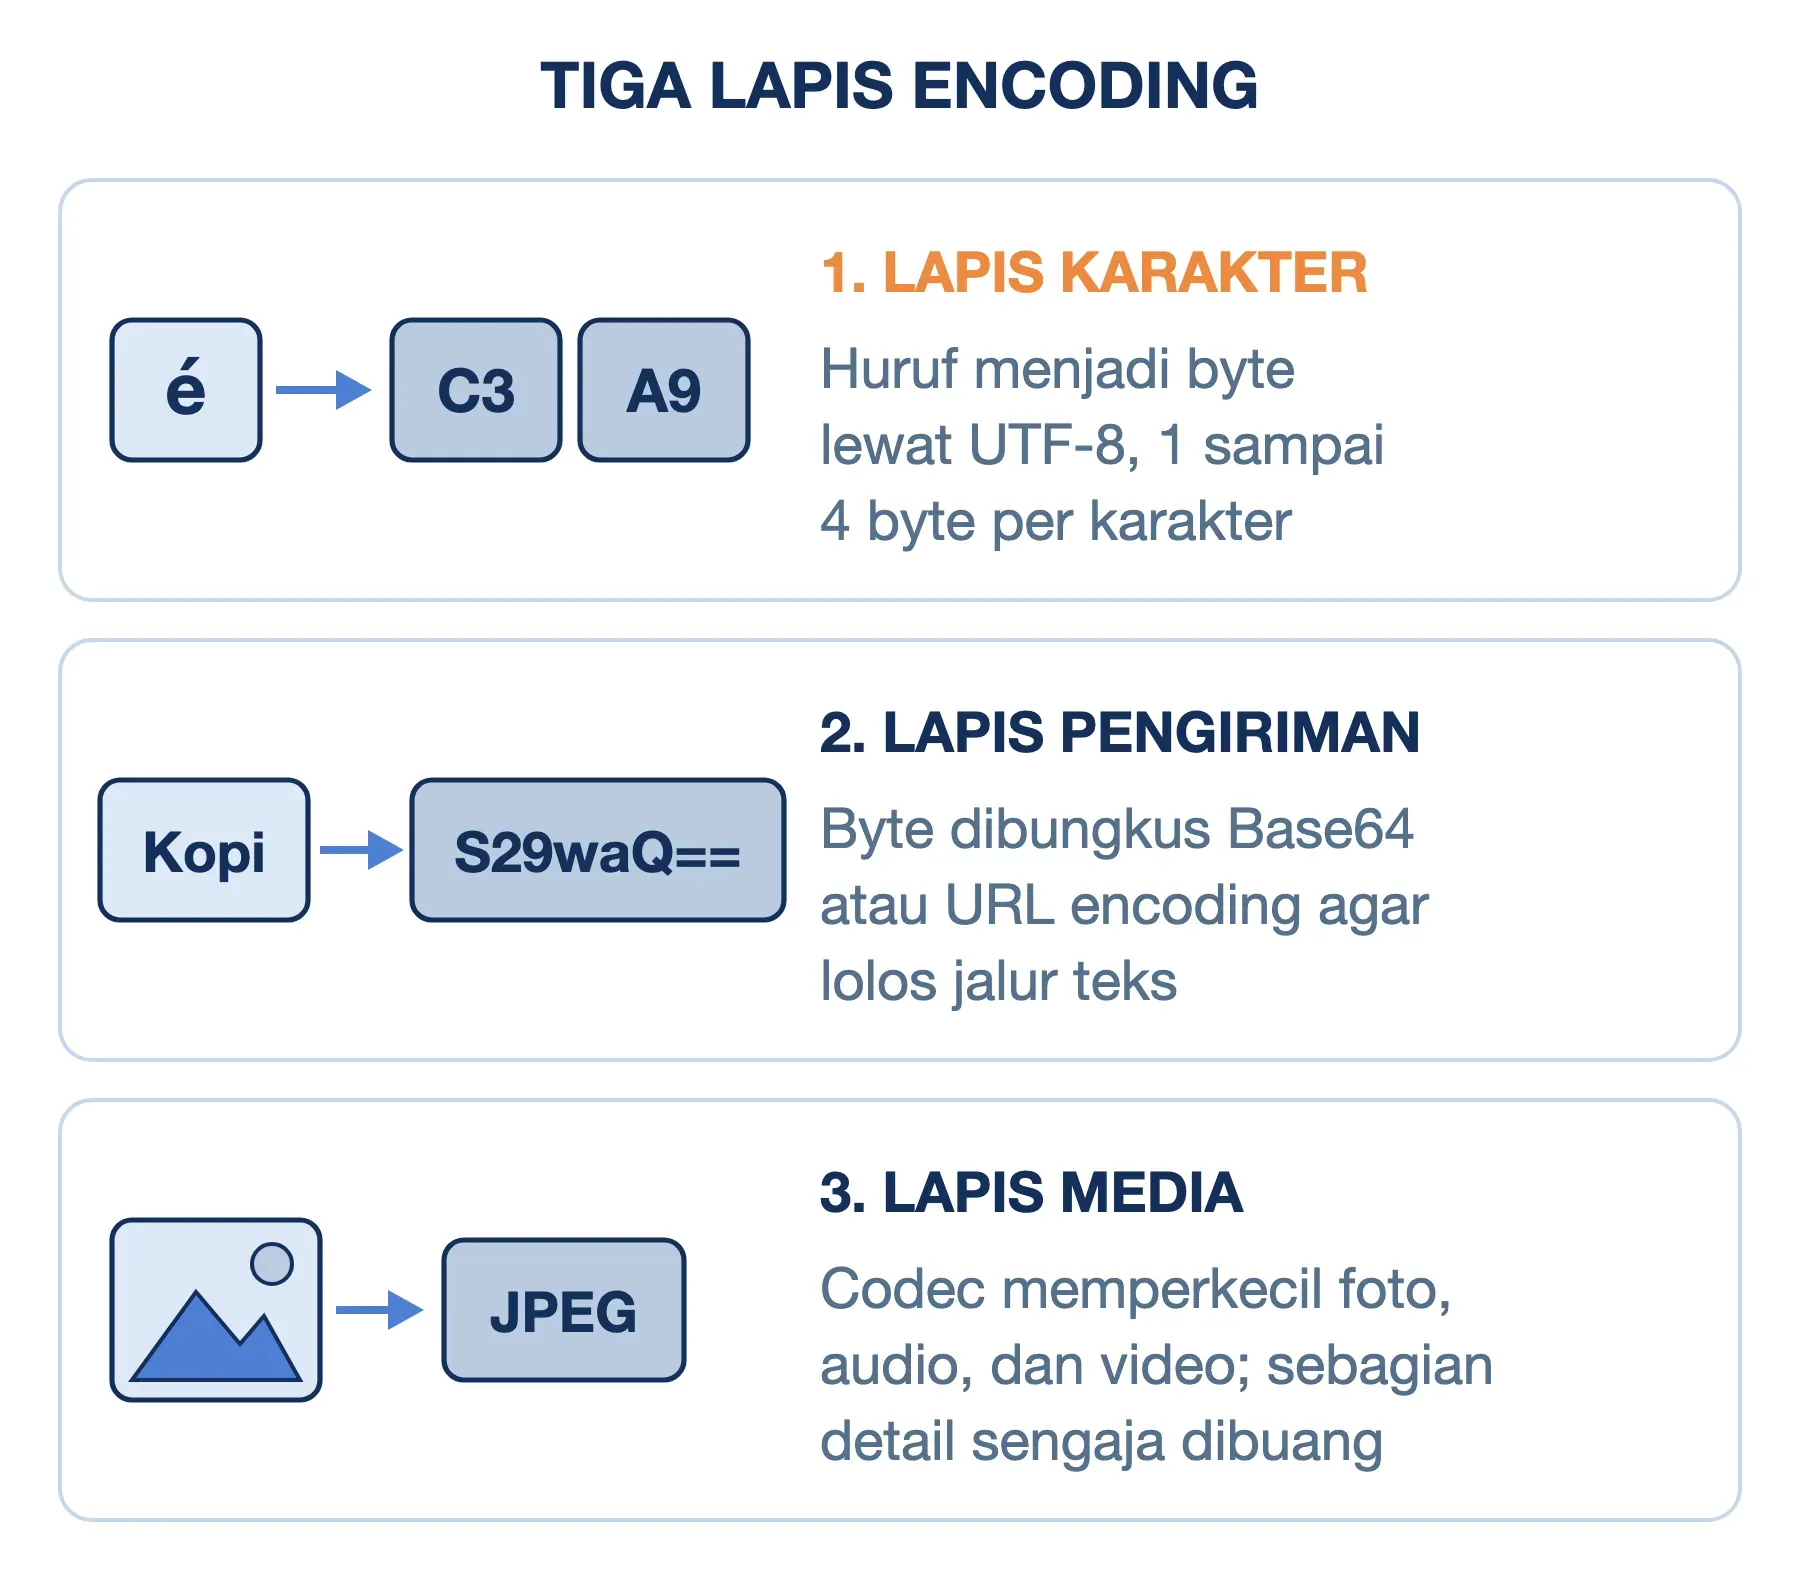
Lapis Karakter: ASCII, Unicode, dan UTF-8
Lapis pertama menjawab pertanyaan paling dasar: huruf ini disimpan sebagai angka berapa? Sistem yang mengatur jawaban ini disebut character encoding (pengodean karakter).
ASCII adalah standar awal yang hanya memuat 128 karakter. Jumlah itu cukup untuk huruf Latin tanpa aksen, angka, dan tanda baca bahasa Inggris. Huruf seperti "é", aksara Jawa, atau emoji tidak punya tempat di sana. Akibatnya, berbagai negara membuat tabel sendiri yang saling bertabrakan.
Unicode hadir sebagai daftar induk yang memberi nomor unik untuk setiap karakter di dunia. Unicode 18.0 yang dirilis 16 September 2026 sudah memuat 172.808 karakter. Nomor itu ditulis dengan format seperti U+0041 untuk "A" atau U+1F600 untuk emoji 😀.
Unicode bisa diibaratkan buku induk yang memberi setiap karakter nomor unik. UTF-8 adalah cara nomor itu ditulis ke dalam byte, sehingga keduanya tidak bisa saling menggantikan.
Unicode hanya daftar nomor, bukan cara menyimpannya. Cara menyimpan nomor tersebut menjadi byte diatur oleh UTF-8. Aturannya, yang ditetapkan dalam RFC 3629, memakai 1 sampai 4 byte per karakter:
- 1 byte: karakter ASCII, misalnya huruf Latin dan angka. Teks ASCII murni otomatis sudah sah sebagai UTF-8.
- 2 byte: huruf beraksen Eropa, Arab, Ibrani, dan sejenisnya.
- 3 byte: sebagian besar aksara Asia, termasuk aksara Jawa, Thai, Tionghoa, dan Jepang.
- 4 byte: emoji dan karakter langka di luar Basic Multilingual Plane (bidang karakter dasar).
Rancangan ini membuat UTF-8 hemat untuk teks Latin sekaligus mampu menampung semua aksara. Menurut W3Techs per 9 Oktober 2026, UTF-8 dipakai oleh 99,1% website. Standar WHATWG yang menjadi acuan browser bahkan mewajibkan UTF-8 untuk semua protokol dan format baru.
Lapis Pengiriman: Base64 dan URL Encoding
Lapis kedua muncul ketika data harus melewati jalur yang hanya menerima karakter tertentu. Tujuannya bukan menghemat ruang, melainkan memastikan data tiba dengan utuh.
Base64 mengubah data biner apa pun menjadi teks yang hanya berisi 64 karakter aman: A–Z, a–z, 0–9, +, dan /. Setiap 3 byte data dipecah menjadi empat potongan 6 bit, lalu tiap potongan diganti satu karakter. Jika data tidak habis dibagi tiga, sisa keluaran ditutup dengan tanda =. Diagram di bawah memperlihatkan prosesnya pada kata "Kop" yang pas tiga byte. Base64 dipakai untuk lampiran email, gambar yang ditanam langsung di HTML atau CSS, dan token JWT (memakai varian base64url).
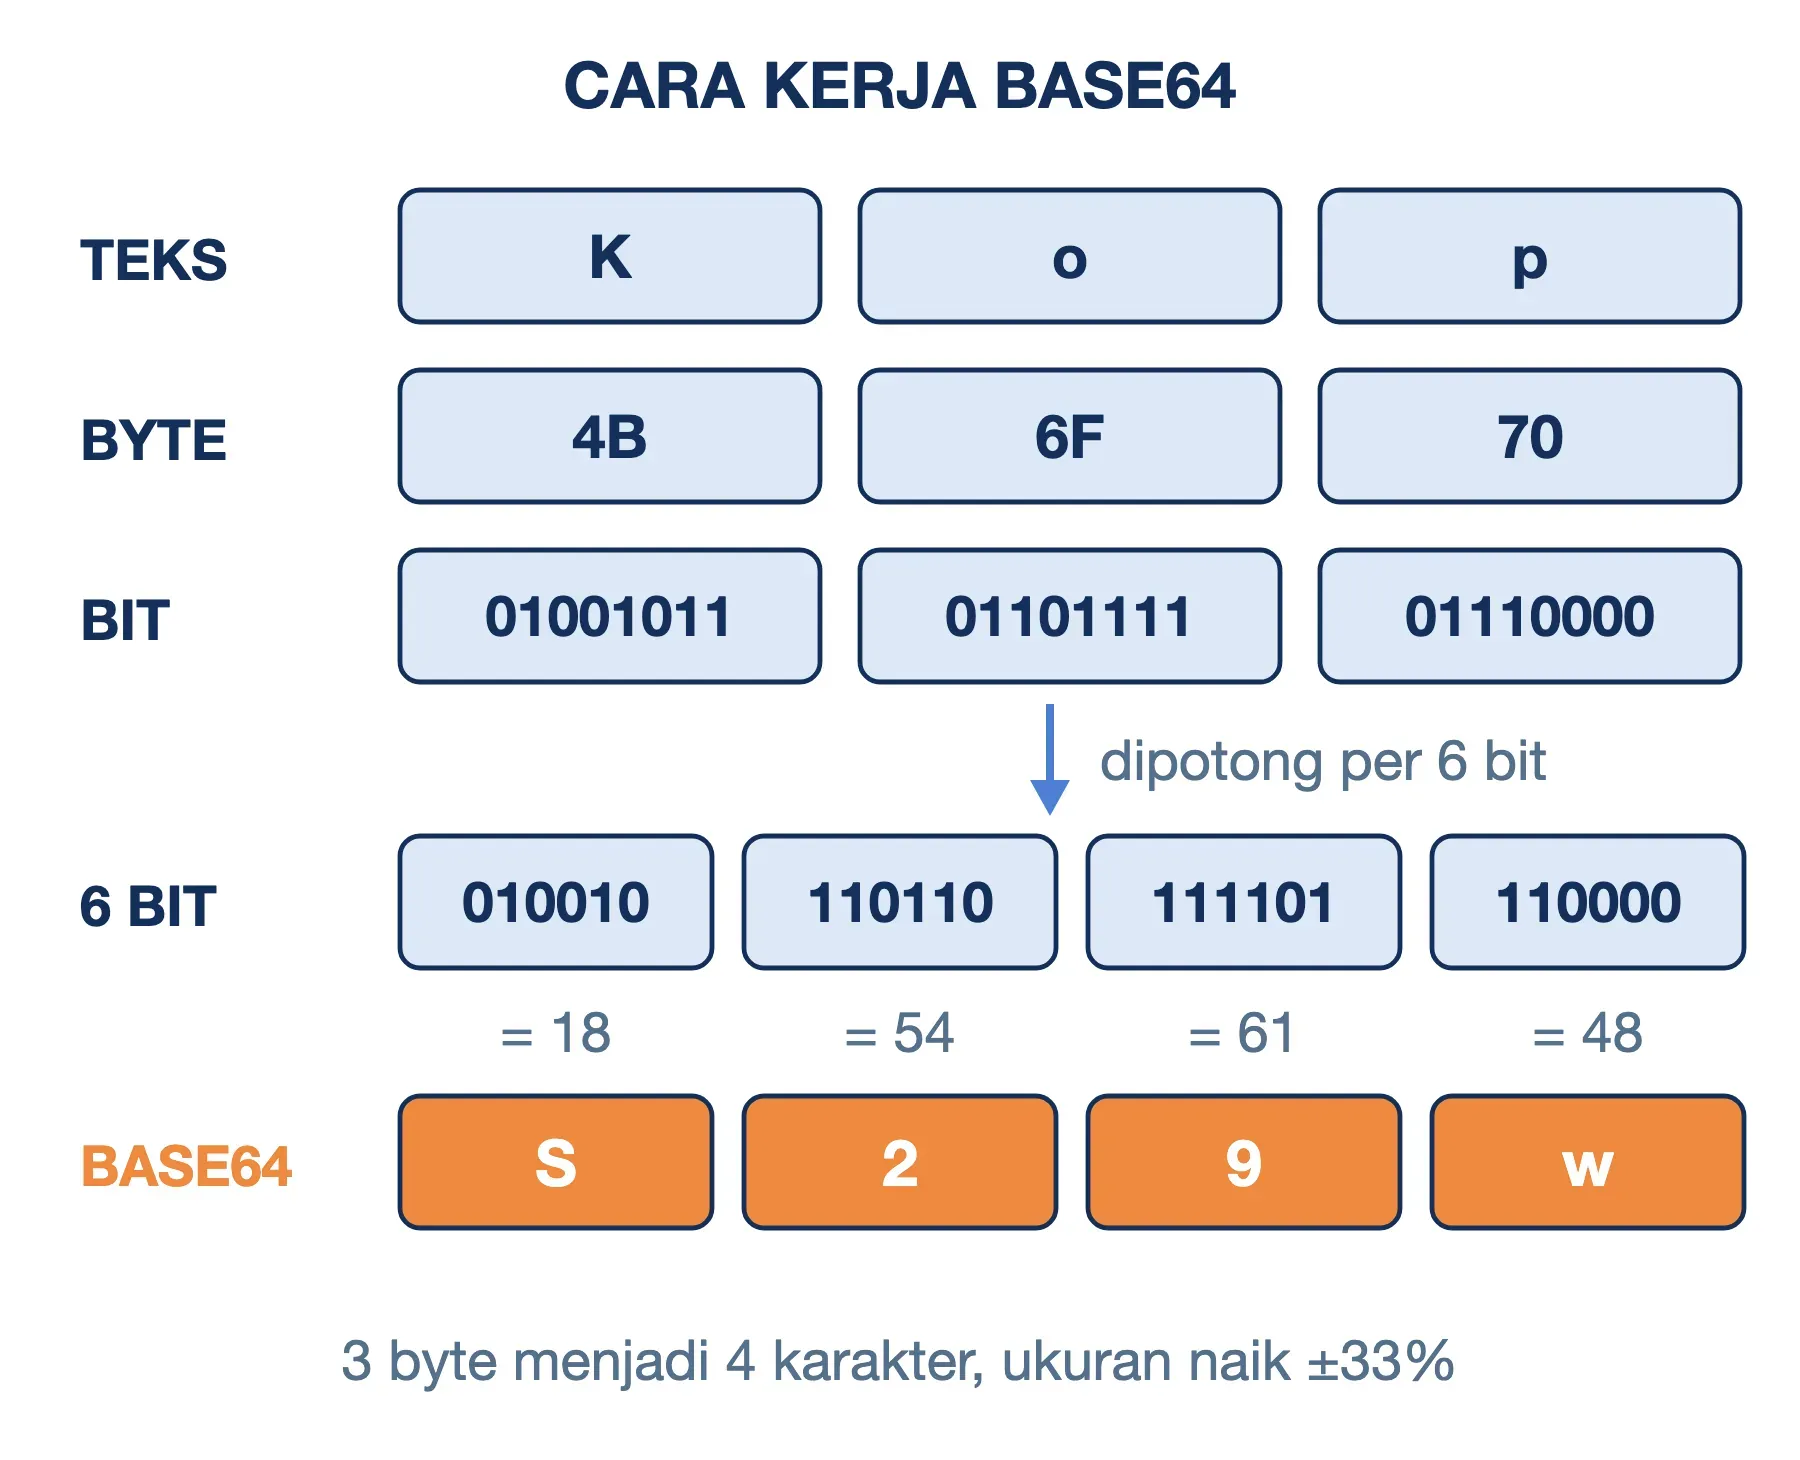
URL encoding atau percent-encoding menangani masalah lain. URL memberi makna khusus pada karakter seperti ?, &, /, dan #. Kalau karakter itu muncul sebagai bagian data, ia harus ditulis ulang menjadi tanda % diikuti dua digit heksadesimal. Spasi menjadi %20, dan & menjadi %26.
Huruf non-ASCII diubah ke byte UTF-8 dulu, sehingga "é" menjadi %C3%A9. Aturan ini dibahas lebih lanjut di artikel tentang struktur URL.
Lapis Media: Codec Gambar, Audio, dan Video
Lapis ketiga mengubah gambar, suara, dan video menjadi berkas yang ringkas. Alat yang melakukannya disebut codec (coder-decoder). Contohnya JPEG dan WebP untuk gambar, AAC dan MP3 untuk audio, serta H.264 dan HEVC untuk video.
Berbeda dengan dua lapis sebelumnya, encoding media umumnya bersifat lossy. Artinya, sebagian detail sengaja dibuang supaya ukuran berkas jauh lebih kecil. Encoding teks tidak boleh bersifat demikian, karena satu byte yang berubah saja bisa merusak satu kata.
Contoh Encoding yang Bisa Anda Uji Sendiri
Konsep encoding lebih mudah dipahami ketika Anda melihat byte-nya secara langsung. Tabel berikut berisi hasil uji yang kami jalankan dengan Python 3:
| Masukan | Jenis encoding | Hasil |
|---|---|---|
A | UTF-8 | 1 byte: 41 |
é | UTF-8 | 2 byte: C3 A9 |
€ | UTF-8 | 3 byte: E2 82 AC |
😀 | UTF-8 | 4 byte: F0 9F 98 80 |
Kopi | Base64 | S29waQ== |
kopi & teh | URL encoding | kopi%20%26%20teh |
Perhatikan bahwa satu karakter di layar tidak selalu sama dengan satu byte. Ini alasan kolom database atau batas karakter formulir kadang berperilaku di luar dugaan ketika diisi emoji.
Anda bisa mencobanya sendiri di terminal Linux atau macOS. Perintah berikut melakukan encoding kata "Kopi" ke Base64, lalu decoding kembali:
echo -n 'Kopi' | base64
echo 'S29waQ==' | base64 -d
Perintah pertama menghasilkan S29waQ==, sedangkan perintah kedua mengembalikan Kopi. Opsi -n penting, karena tanpa opsi itu echo ikut menyertakan karakter baris baru sehingga hasilnya berbeda.
Untuk melihat byte UTF-8 sebuah kata, Anda bisa memakai satu baris Python:
python3 -c "print('Kafé'.encode('utf-8'))"Keluarannya b'Kaf\xc3\xa9'. Tiga huruf pertama tetap satu byte, sedangkan "é" berubah menjadi dua byte C3 A9.
Encoding Bukan Pengaman Data
Karena hasilnya terlihat acak, encoding sering disangka sebagai cara mengamankan data. Anggapan ini keliru dan cukup berbahaya. Encoding tidak memakai kunci, sehingga siapa saja bisa membaliknya dalam hitungan detik.
Contoh paling nyata adalah autentikasi HTTP Basic. Browser mengirim nama pengguna dan kata sandi dalam bentuk Base64. Gabungan admin:rahasia hanya menjadi YWRtaW46cmFoYXNpYQ==, dan satu perintah base64 -d langsung membukanya kembali. Itu sebabnya autentikasi jenis ini hanya layak dipakai di atas HTTPS.
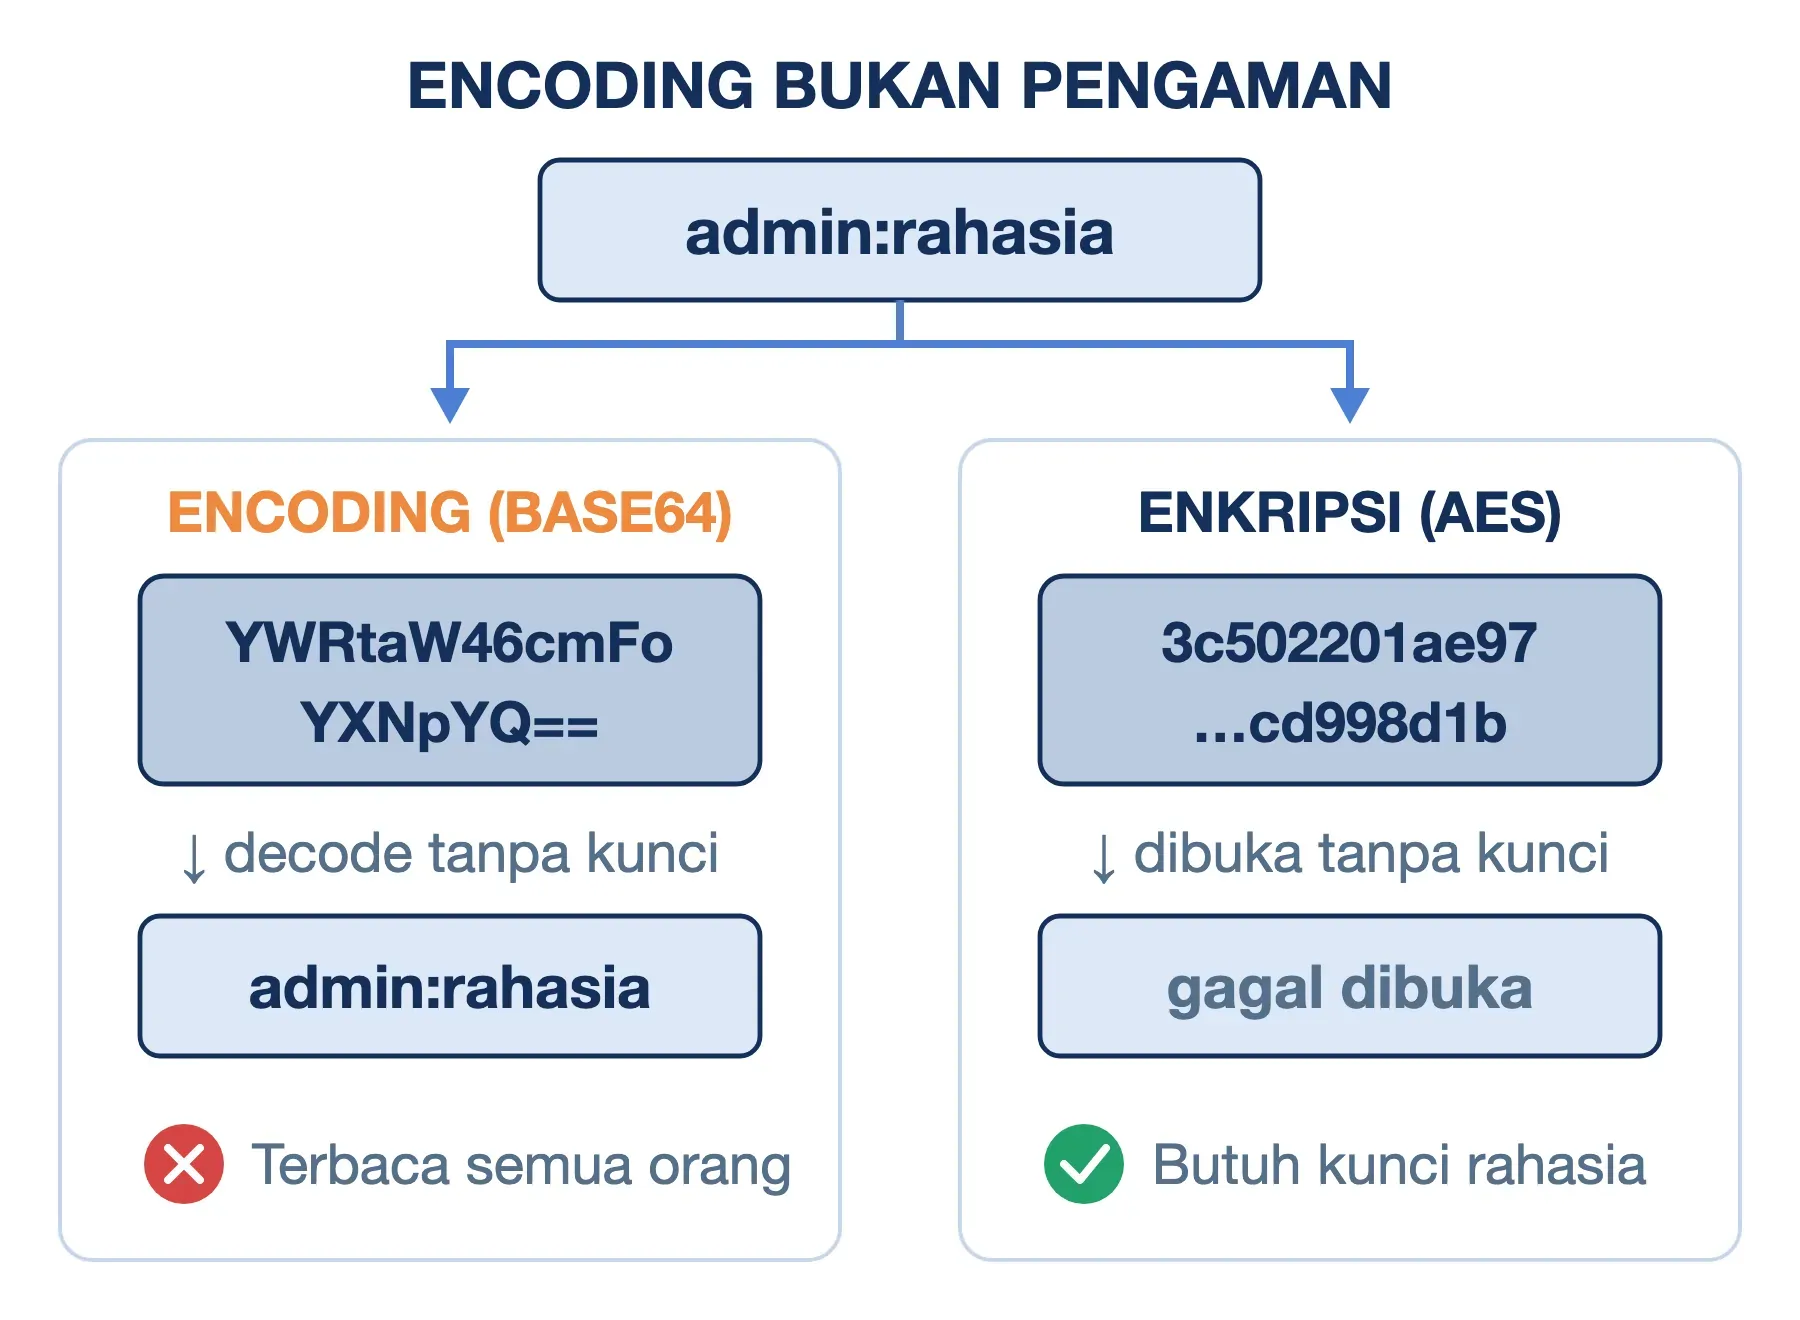
Spesifikasi Base64 sendiri, RFC 4648, menegaskan hal yang sama di bagian keamanannya. Base64 memang menyamarkan data secara visual, tetapi tidak memberi kerahasiaan apa pun. Dokumen itu mencatat insiden nyata: rekaman lalu lintas jaringan dibagikan tanpa sadar kata sandi di dalamnya terbaca.
Jadi, bedakan tujuannya. Encoding bertujuan agar data bisa dipakai oleh sistem lain. Enkripsi bertujuan agar data tidak bisa dibaca tanpa kunci. Kompresi bertujuan agar data lebih kecil. Satu data bisa melalui ketiganya sekaligus, tetapi fungsi masing-masing tidak bisa saling menggantikan.
Saat Encoding Tidak Cocok: Mojibake dan Tanda Tanya Hitam
Teks yang rusak karena salah encoding disebut mojibake, istilah dari bahasa Jepang yang berarti "karakter yang berubah". Gejalanya berbeda-beda, dan bentuk kerusakannya bisa membantu Anda menebak penyebabnya.
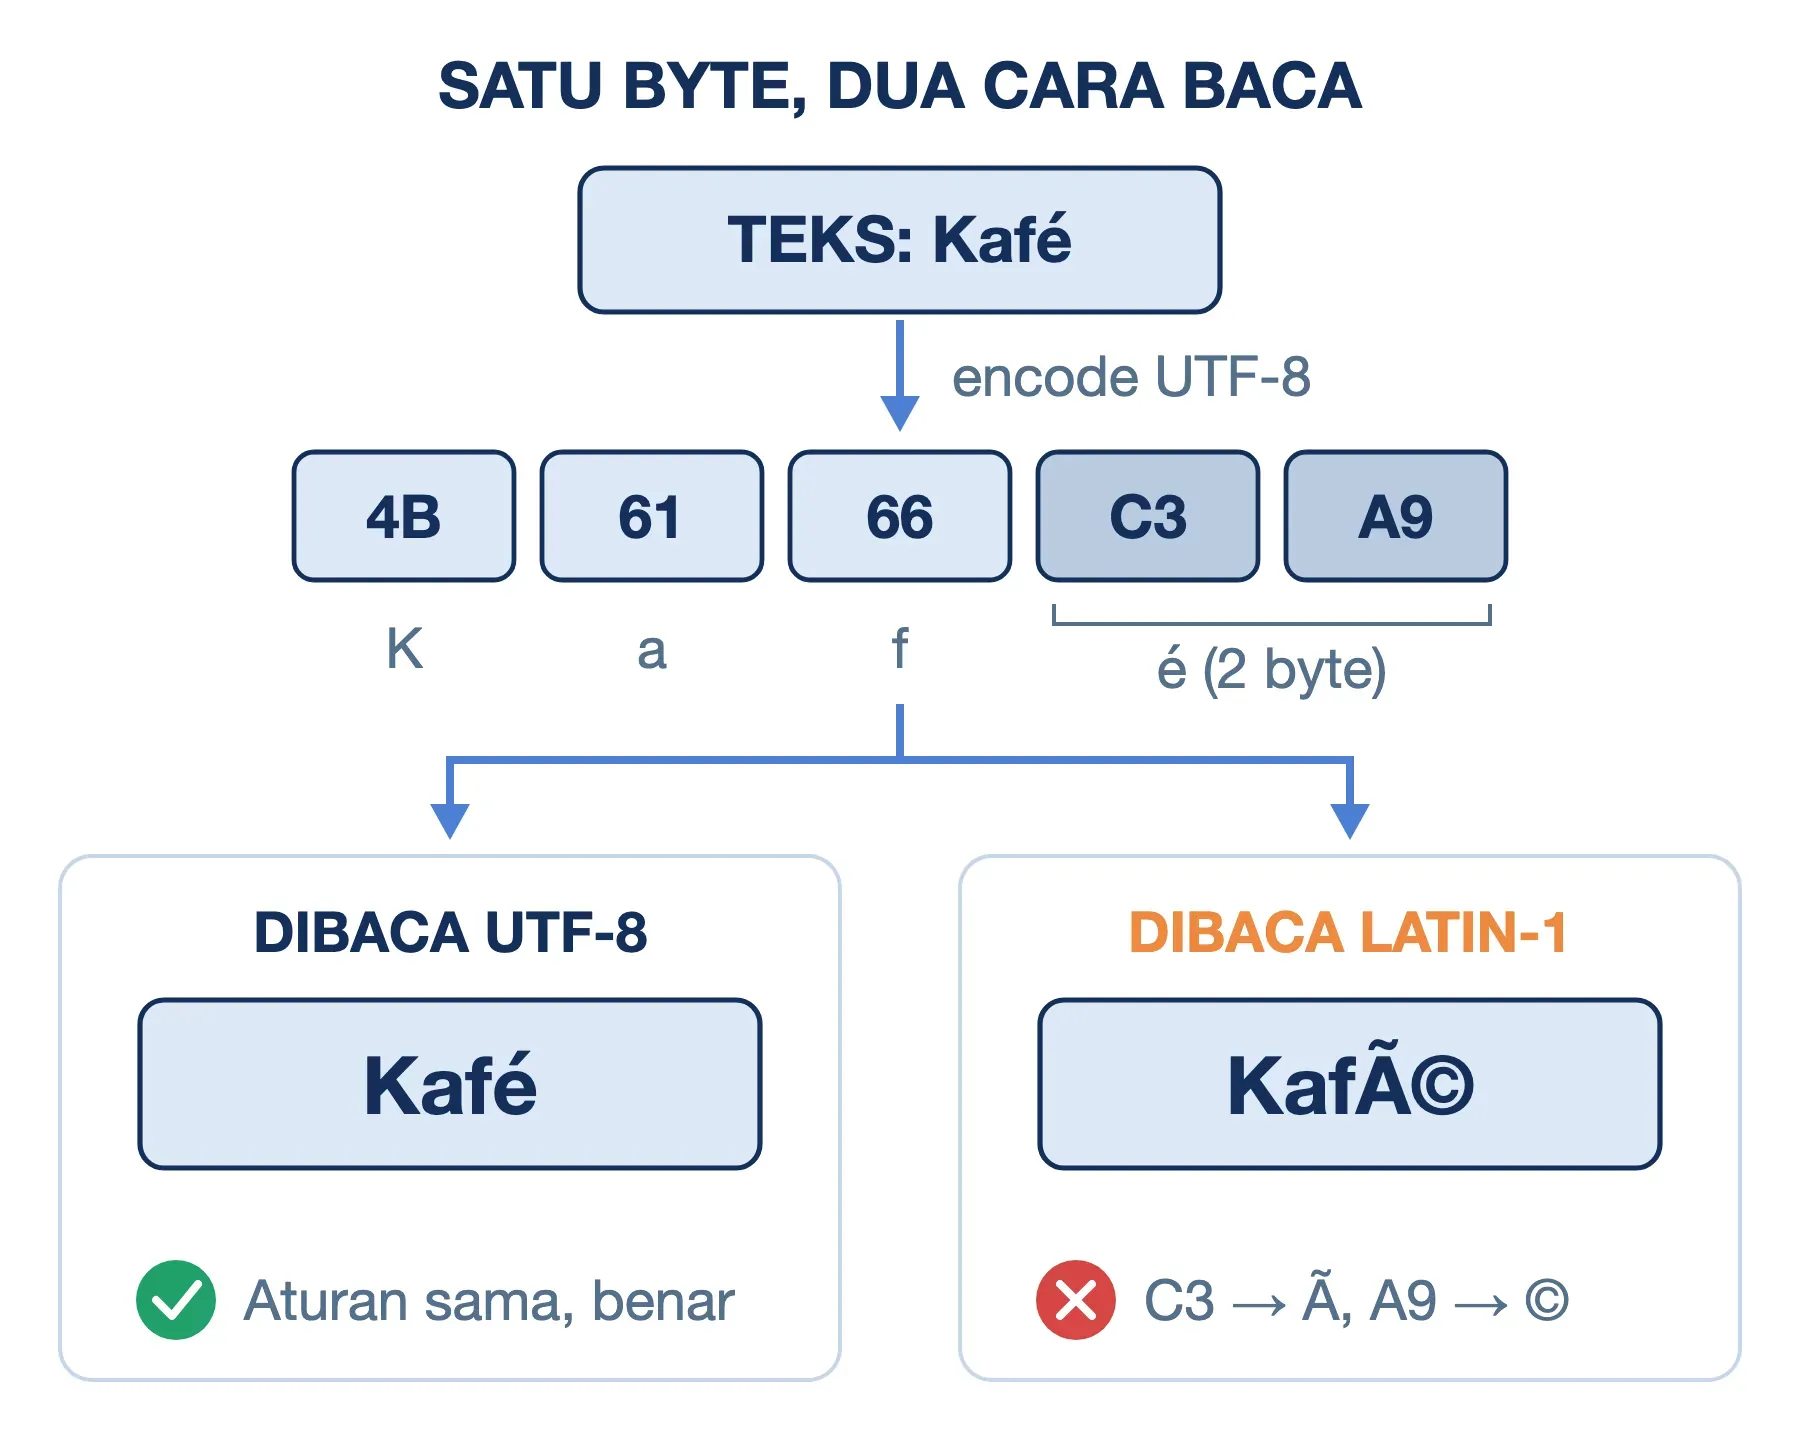
- "Kafé" menjadi "Kafé": Teks disimpan dalam UTF-8 tetapi dibaca sebagai Latin-1 atau Windows-1252. Dua byte
C3 A9dibaca sebagai dua karakter terpisah, yaitu "Ã" dan "©". Pola huruf "Ã" atau "Â" yang muncul di depan simbol aneh hampir selalu menandakan kasus ini. - "Kafé" menjadi "Kafé": Kesalahan yang sama terjadi dua kali. Teks yang sudah rusak disimpan ulang sebagai UTF-8 lalu dibaca salah lagi. Kerusakan ini disebut double encoding dan biasanya muncul setelah migrasi database.
- "Kafé" menjadi "Kaf�": Kebalikan dari kasus pertama. Teks disimpan dalam Latin-1, di mana "é" hanya satu byte
E9, lalu dibaca sebagai UTF-8. Byte itu tidak sah dalam UTF-8, sehingga diganti karakter pengganti�. - Emoji hilang atau menjadi "????": Sering terjadi di MySQL. Nama charset
utf8di MySQL ternyata hanya alias dariutf8mb3yang menampung maksimal 3 byte per karakter. Emoji yang butuh 4 byte akan ditolak atau berubah menjadi tanda tanya.
Kasus pertama dan kedua masih bisa dipulihkan karena byte aslinya tidak hilang, hanya salah dibaca. Kasus ketiga dan keempat lebih sulit, karena informasi aslinya sudah diganti sebelum disimpan.
Kelemahan dan Pertimbangan Encoding
Encoding menyelesaikan masalah kompatibilitas, tetapi membawa konsekuensi yang perlu Anda perhitungkan.
- Ukuran membengkak: Base64 mengubah 3 byte menjadi 4 karakter, sehingga ukurannya naik sekitar 33%. Berkas 3.000 byte menjadi 4.000 karakter. Ini sebabnya lampiran email terasa lebih besar dari berkas aslinya, dan data biner di dalam JSON sebaiknya dikirim terpisah jika ukurannya besar.
- Aksara non-Latin lebih boros: Di UTF-8, kata "Selamat pagi" butuh 12 byte. Teks beraksara Jawa dengan jumlah karakter separuhnya bisa butuh 18 byte, karena tiap karakternya memakai 3 byte.
- BOM yang menyusup: Beberapa editor menambahkan tiga byte
EF BB BF(Byte Order Mark) di awal berkas UTF-8. Di berkas PHP, tiga byte tak terlihat ini bisa memicu galat "headers already sent". - Encoding ganda: Data yang di-encode dua kali, misalnya
%20yang berubah menjadi%2520, tidak akan kembali ke bentuk asli dengan satu kali decoding. - Rasa aman palsu: Seperti dibahas sebelumnya, data yang tampak acak belum tentu terlindungi.
Rekomendasi Encoding untuk Website dan Aplikasi
Sebagian besar masalah encoding bisa dicegah dengan satu prinsip: pakai UTF-8 di semua lapisan, dari editor sampai database. Berikut pengaturan konkret yang kami sarankan:
- Berkas sumber: Simpan semua berkas HTML, CSS, JavaScript, dan PHP sebagai UTF-8 tanpa BOM. Editor seperti VS Code dan Notepad menampilkan pilihan ini di bilah status atau dialog simpan.
- Halaman HTML: Tulis
<meta charset="utf-8">sebagai elemen pertama di dalam<head>. Standar HTML mensyaratkan deklarasi ini berada dalam 1.024 byte pertama dokumen. - Header server: Pastikan header HTTP berbunyi
Content-Type: text/html; charset=utf-8. Header ini lebih diutamakan browser daripada tag meta. - Database: Pakai
utf8mb4di MySQL dan MariaDB, baik untuk database, tabel, kolom, maupun koneksinya. Hindariutf8, karena dokumentasi resmi MySQL sudah menandainya usang. - Data di dalam URL: Pakai fungsi bawaan bahasa pemrograman, seperti
encodeURIComponent()di JavaScript ataurawurlencode()di PHP. Untuk token, pakai varian base64url yang mengganti+dan/dengan-dan_. - Output ke halaman: Ubah karakter khusus seperti
<menjadi<tepat saat data ditampilkan. Langkah ini merupakan pertahanan utama terhadap serangan XSS.
Encoding dan Decoding dalam Komunikasi
Istilah encoding dan decoding juga dipakai di ilmu komunikasi, dengan makna yang sejajar. Encoding dalam komunikasi adalah proses pengirim menyusun gagasan menjadi simbol, seperti kata, gambar, nada suara, atau gerak tubuh. Decoding adalah proses penerima menafsirkan simbol itu menjadi makna. Karena itu, pengirim disebut encoder atau komunikator, sedangkan penerima disebut decoder atau komunikan.
Model yang paling sering dirujuk adalah teori encoding-decoding Stuart Hall. Ia menuliskannya pada 1973 di makalah Encoding and Decoding in the Television Discourse untuk Centre for Contemporary Cultural Studies, Universitas Birmingham. Hall berpendapat makna sebuah pesan bisa bergeser antara saat diproduksi dan saat diterima.
Hall membagi cara penonton membaca pesan menjadi tiga posisi:
- Dominan: Penerima memahami pesan persis seperti yang dimaksud pengirim.
- Negosiasi: Penerima menerima sebagian pesan, tetapi menyesuaikannya dengan pengalamannya sendiri.
- Oposisi: Penerima memahami maksud pesan, tetapi menolaknya dan menafsirkan dengan sudut pandang berlawanan.
Benang merahnya sama dengan encoding di komputer. Komunikasi berhasil kalau pengirim dan penerima berbagi kode yang sama. Bedanya, komputer akan menampilkan "é" ketika kodenya tidak cocok, sedangkan manusia akan salah paham.
Pertanyaan yang Sering Diajukan
Apa bedanya encode dan encoding?
Encode adalah kata kerja, yaitu tindakan mengodekan data. Encoding adalah prosesnya, dan juga dipakai untuk menyebut nama aturannya, misalnya "encoding UTF-8". Pasangannya adalah decode dan decoding.
Apakah Unicode sama dengan UTF-8?
Tidak. Unicode adalah daftar yang memberi nomor untuk setiap karakter, sedangkan UTF-8 adalah cara menyimpan nomor tersebut menjadi byte. Unicode juga bisa disimpan dengan UTF-16 atau UTF-32, tetapi UTF-8 yang paling umum dipakai di web.
Apa arti pesan "unknown encoding"?
Pesan ini muncul ketika program diminta memakai nama encoding yang tidak dikenalnya. Contohnya, Python menampilkan LookupError: unknown encoding: utf8mb4 karena utf8mb4 adalah nama charset MySQL, bukan nama codec Python. Solusinya, ganti dengan nama yang dikenali program tersebut, yaitu utf-8.
Apa contoh encoding dalam kehidupan sehari-hari?
Saat membuka halaman web, browser melakukan decoding teks UTF-8. Lampiran email dikirim dalam Base64, foto di ponsel disimpan sebagai JPEG, dan video streaming memakai H.264. Contoh di luar komputer adalah kode Morse, yang mengubah huruf menjadi rangkaian titik dan garis.
Apa itu one hot encoding?
One hot encoding adalah teknik di machine learning untuk mengubah data kategori menjadi angka. Setiap kategori menjadi satu kolom bernilai 0 atau 1. Misalnya warna merah, hijau, dan biru menjadi [1,0,0], [0,1,0], dan [0,0,1], sehingga model tidak menganggap satu warna lebih besar dari warna lain.
Dua istilah serumpun juga sering muncul. Label encoding memberi tiap kategori satu angka urut, misalnya merah = 0, hijau = 1, dan biru = 2. Positional encoding menandai urutan kata pada model transformer.
Kesimpulan
Encoding adalah aturan penerjemahan yang memungkinkan data berpindah antar sistem, sedangkan decoding membalik prosesnya dengan aturan yang sama. Di web, satu teks bisa melewati tiga lapis encoding: karakter (UTF-8), pengiriman (Base64 dan URL encoding), serta media (codec). Masing-masing lapis punya tujuan berbeda, dan tidak satu pun berfungsi sebagai pengaman data.
Untuk website dan aplikasi, pakai UTF-8 dari editor sampai database, termasuk utf8mb4 di MySQL. Kalau teks rusak muncul, kenali polanya terlebih dahulu: huruf "Ã" berarti UTF-8 dibaca sebagai Latin-1, sedangkan "�" berarti byte tidak sah dibaca sebagai UTF-8.
Semoga artikel ini membantu.