Setiap kali Anda berbelanja di minimarket, mesin kasir mencatat barang apa saja yang dibeli, jam berapa, dan berapa totalnya. Satu struk tidak bercerita banyak. Namun, jutaan struk yang terkumpul di database toko selama setahun menyimpan kebiasaan pembeli yang tidak akan terlihat kalau dibaca satu per satu. Barang apa yang hampir selalu dibeli bersamaan? Pelanggan mana yang mulai jarang datang?
Menjawab pertanyaan semacam itu tidak cukup dengan membuka tabel lalu menggulirnya. Di sinilah data mining berperan. Singkatnya, data mining adalah proses menggali pola, hubungan, dan kecenderungan yang tersembunyi di dalam data berjumlah besar, dengan bantuan statistik dan algoritma komputer. Di artikel ini kita akan membahas pengertian data mining dan posisinya di dalam proses yang lebih panjang. Setelah itu, kita lanjut ke tahapan, metode, contoh penerapan, dan aplikasi untuk mulai belajar.
Apa Itu Data Mining?
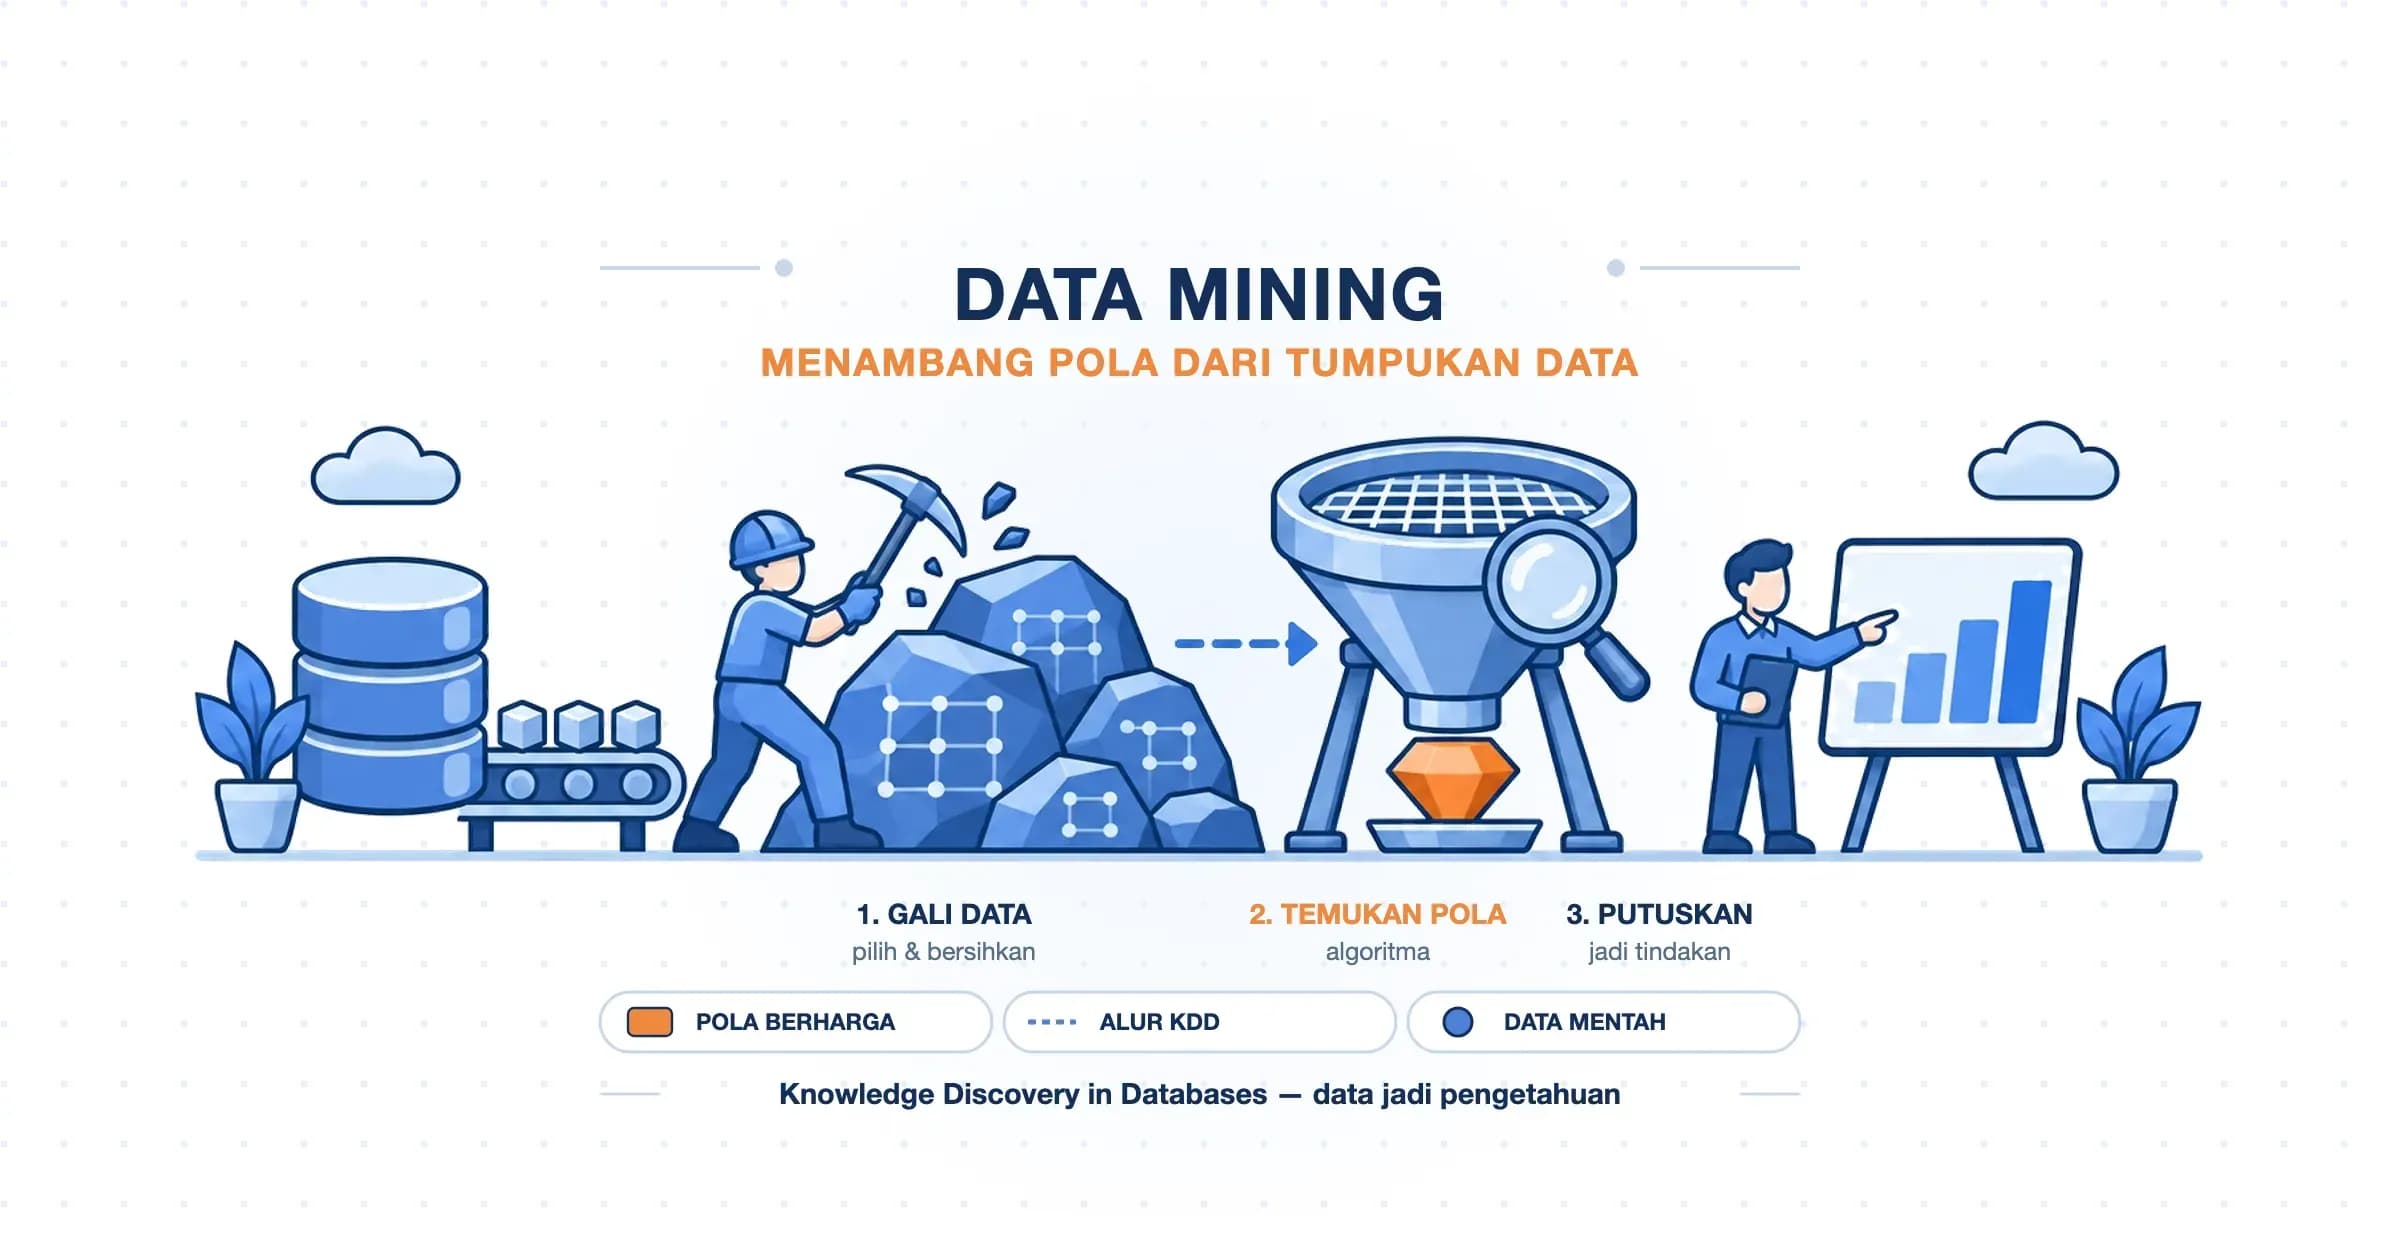
Data mining (penambangan data) adalah kegiatan mengolah kumpulan data besar untuk menemukan pola yang sebelumnya tidak diketahui dan bisa dipakai untuk mengambil keputusan. Polanya bisa berupa aturan ("pembeli A cenderung membeli B"), kelompok ("pelanggan terbagi menjadi tiga tipe"), atau model prediksi ("nasabah dengan ciri ini berisiko gagal bayar").
Kalau ditanya data mining artinya apa secara harfiah, istilah ini memang meminjam gambaran pertambangan. Data mentah ibarat bijih yang ditumpuk berton-ton, sedangkan pola yang bermanfaat ibarat emas yang kadarnya kecil. Pekerjaan utamanya bukan menyimpan bijih, melainkan memisahkan emas dari batu. Karena itu, konsep data mining selalu berangkat dari pertanyaan: informasi berharga apa yang belum terlihat dari data yang sudah ada?
Data mining berada di irisan beberapa bidang. Statistik menyumbang cara mengukur apakah sebuah pola cukup kuat. Machine learning menyumbang algoritma yang mampu belajar dari contoh. Ilmu database menyumbang cara menyimpan dan mengambil data dalam jumlah besar secara efisien.
Pengertian Data Mining Menurut Para Ahli
Rumusan para ahli berbeda redaksinya, tetapi intinya sama. Berikut dua definisi data mining yang paling sering dikutip di buku ajar:
- Jiawei Han, Micheline Kamber, dan Jian Pei (Data Mining: Concepts and Techniques, edisi ke-3, 2011): data mining adalah proses menemukan pola dan pengetahuan yang menarik dari data berjumlah besar.
- Usama Fayyad dan rekan (AI Magazine, 1996): data mining adalah penerapan algoritma tertentu untuk mengekstrak pola dari data, sebagai satu langkah di dalam proses KDD.
Jadi, yang dimaksud dengan data mining bukan sekadar mengolah data, melainkan menemukan sesuatu yang baru dan berguna dari data tersebut.
Kata "mining" di sini tidak berhubungan dengan crypto mining (penambangan aset kripto). Penambangan kripto adalah proses komputer memecahkan teka-teki matematika untuk memvalidasi transaksi blockchain, sedangkan data mining adalah proses menganalisis data untuk menemukan pola.
Data Mining dan KDD: Satu Langkah di Dalam Proses Panjang
Dalam literatur akademik, data mining sebenarnya hanya satu tahap dari proses yang lebih besar bernama Knowledge Discovery in Databases (KDD, penemuan pengetahuan dari database). Usama Fayyad, Gregory Piatetsky-Shapiro, dan Padhraic Smyth merumuskannya dalam makalah di AI Magazine tahun 1996. Menurut mereka, KDD adalah proses menemukan pola yang valid, baru, berpotensi bermanfaat, dan pada akhirnya dapat dipahami manusia. Data mining adalah langkah di tengah proses itu, yaitu saat algoritma dijalankan untuk mengekstrak pola.
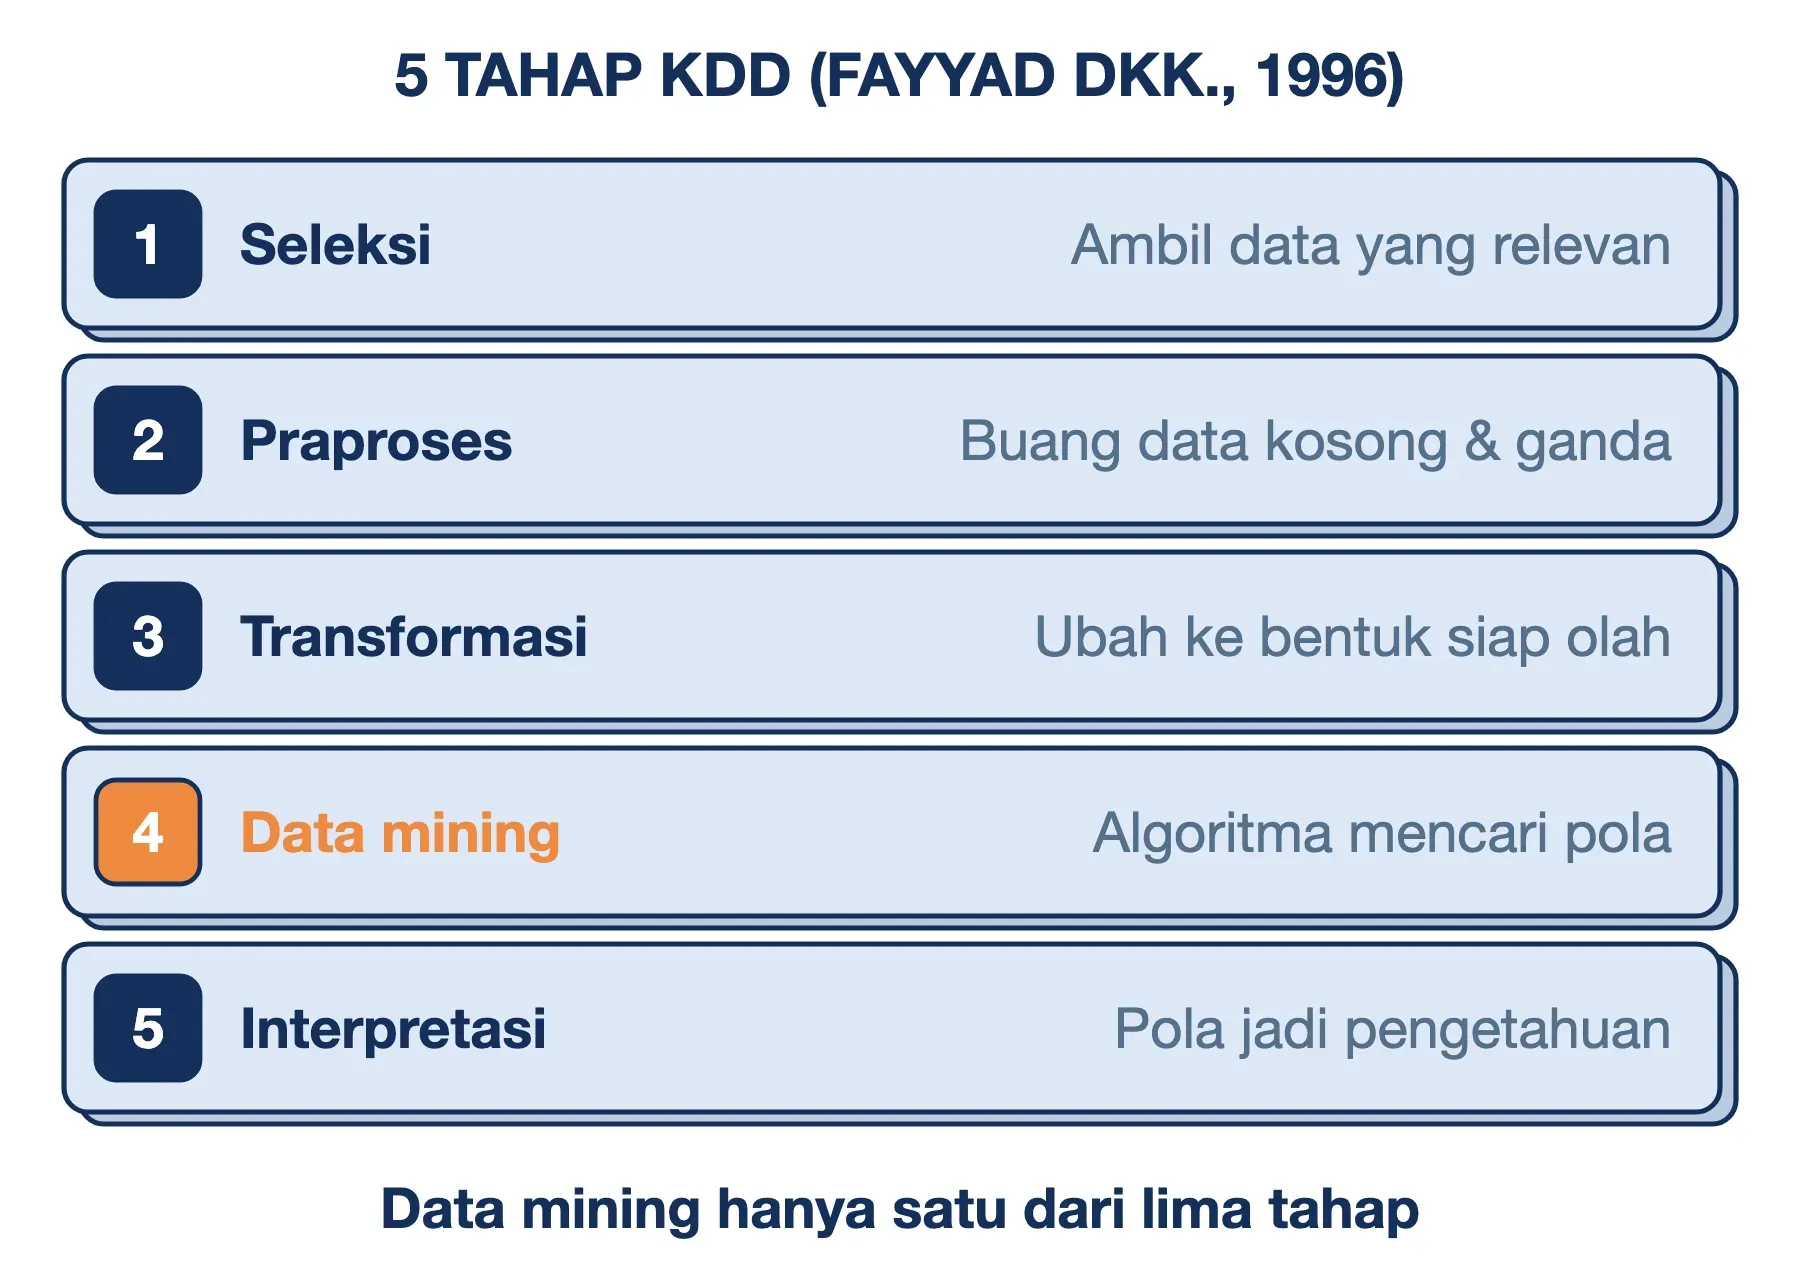
Gambar ringkas dalam makalah tersebut membagi proses KDD menjadi lima tahap berurutan:
- Seleksi: memilih data yang relevan dengan pertanyaan, misalnya transaksi 12 bulan terakhir saja.
- Praproses: membersihkan data dari nilai kosong, duplikat, dan salah ketik.
- Transformasi: mengubah data ke bentuk yang siap diolah, misalnya mengelompokkan umur menjadi rentang.
- Data mining: menjalankan algoritma untuk menemukan pola.
- Interpretasi dan evaluasi: memeriksa apakah pola itu masuk akal dan berguna, lalu menerjemahkannya menjadi pengetahuan.
Empat dari lima tahap tersebut bukan "menambang". Hal ini menjelaskan mengapa proyek data mining jarang selesai cepat: sebagian besar pekerjaan justru menyiapkan bahan tambangnya. Dalam percakapan sehari-hari dan di dunia industri, istilah data mining biasanya dipakai untuk menyebut seluruh proses tersebut. Keduanya tidak salah, asalkan Anda tahu konteks mana yang sedang dibicarakan, terutama saat mengerjakan soal ujian yang membedakan KDD dan data mining.
Apa yang Bukan Data Mining?
Banyak kegiatan pengolahan data terlihat mirip, padahal bukan data mining. Pembedanya satu: data mining mencari pola yang belum diketahui, bukan mengambil jawaban yang sebenarnya sudah tersimpan.
- Menjalankan query database: perintah SQL seperti "tampilkan pelanggan dari Bandung" hanya mengambil data yang kriterianya sudah Anda tentukan sendiri. Tidak ada pola baru yang ditemukan.
- Menyusun laporan penjualan: menjumlahkan omzet per bulan lalu membuat grafik termasuk pelaporan atau business intelligence deskriptif. Laporan menjawab "apa yang terjadi", bukan "pola apa yang tersembunyi".
- Mengumpulkan data dari internet: web scraping (mengambil isi halaman web secara otomatis) adalah cara mengumpulkan bahan. Data yang terkumpul baru bisa ditambang setelahnya.
- Menyimpan data dalam jumlah besar: memiliki data warehouse berisi miliaran baris tidak otomatis berarti melakukan data mining. Tanpa analisis, data itu hanya tumpukan bijih.
Data mining juga sering tertukar dengan beberapa istilah tetangganya. Tabel berikut merangkum perbedaannya:
| Istilah | Fokus utama | Hubungannya dengan data mining |
|---|---|---|
| Statistik | Menguji dugaan dengan sampel dan ukuran keyakinan | Menyediakan alat ukur kekuatan pola |
| Machine learning | Membuat program yang belajar dari contoh | Menyediakan algoritma yang dipakai saat menambang |
| Big data | Menyimpan dan memproses data yang sangat besar dan beragam | Menjadi bahan tambang yang diolah |
| Data mining | Menemukan pola baru yang berguna | Memakai ketiganya untuk menghasilkan pengetahuan |
Tujuan dan Fungsi Data Mining
Tujuan data mining dapat dibagi menjadi tiga, tergantung pada seberapa jauh Anda sudah punya dugaan sebelum mulai:
- Menjelaskan (eksplanatori): memahami mengapa sesuatu terjadi. Contohnya, mencari faktor yang membuat pengguna aplikasi berhenti berlangganan.
- Mengonfirmasi (konfirmatori): menguji dugaan yang sudah ada. Misalnya, manajer menduga promo ongkos kirim menaikkan pembelian ulang, lalu data dipakai untuk membuktikan atau membantahnya.
- Menjelajah (eksploratori): mencari pola tanpa dugaan awal sama sekali. Tujuan inilah yang paling dekat dengan arti "menambang".
Dalam praktik, fungsi data mining muncul dalam empat bentuk pekerjaan. Keempatnya adalah memprediksi (siapa yang akan membeli), mengelompokkan (pelanggan mana yang mirip), mendeteksi kejanggalan (transaksi mana yang mencurigakan), dan merekomendasikan (produk apa yang ditawarkan berikutnya). Manfaat data mining bagi organisasi adalah keputusan yang berdasarkan bukti, bukan sekadar intuisi.
Tahapan Data Mining dengan Kerangka CRISP-DM
KDD menjelaskan apa yang terjadi pada data. Untuk proyek nyata di perusahaan, kerangka yang paling banyak dipakai adalah CRISP-DM (Cross-Industry Standard Process for Data Mining). Kerangka ini disusun konsorsium perusahaan, antara lain Daimler, SPSS, dan NCR, lalu versi pertamanya dipresentasikan pada 1999. Kelebihannya, CRISP-DM dimulai dari kebutuhan bisnis, bukan dari data.
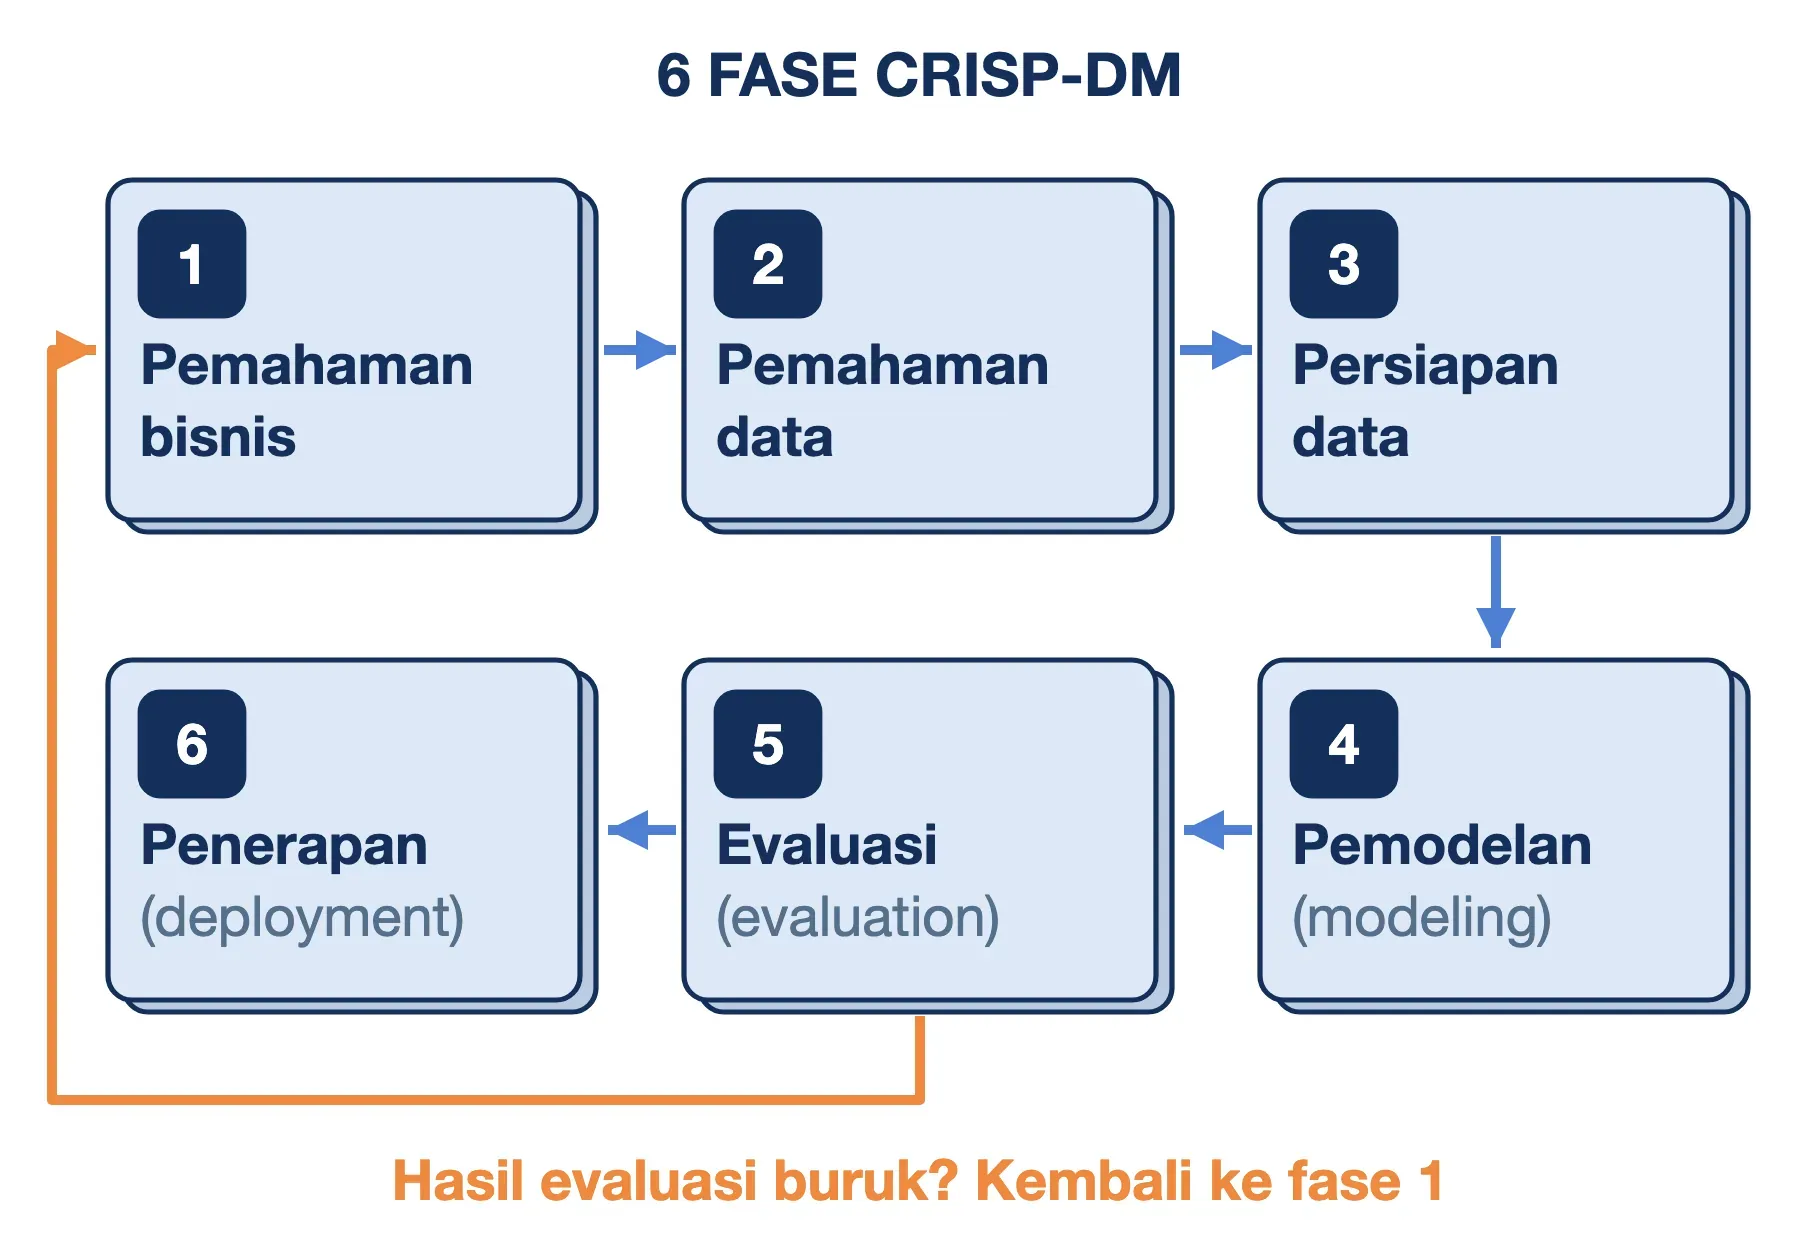
Proses data mining dalam proyek nyata jarang dimulai dari algoritma. Agar lebih konkret, bayangkan sebuah toko online yang ingin tahu pelanggan mana yang akan berhenti berbelanja. Berikut enam tahapan data mining menurut CRISP-DM untuk kasus tersebut:
- Pemahaman bisnis: menetapkan tujuan yang terukur. Misalnya, "temukan 10% pelanggan dengan risiko berhenti tertinggi agar diberi voucer".
- Pemahaman data: memeriksa data yang tersedia, seperti riwayat pesanan, keluhan, dan aktivitas login, lalu mencatat kualitasnya.
- Persiapan data: membersihkan, menggabungkan, dan membentuk variabel baru, misalnya "jumlah hari sejak pesanan terakhir".
- Pemodelan: mencoba beberapa algoritma, misalnya decision tree dan regresi logistik.
- Evaluasi: menguji model dengan data yang belum pernah dilihatnya, lalu memastikan hasilnya menjawab tujuan bisnis.
- Penerapan (deployment): memasang model ke sistem, misalnya daftar pelanggan berisiko dikirim otomatis ke tim pemasaran setiap Senin.
Tahap persiapan data biasanya memakan waktu paling lama. Survei Anaconda State of Data Science 2022 mencatat praktisi data menghabiskan sekitar 38% waktu kerjanya untuk menyiapkan dan membersihkan data. Selain itu, prosesnya tidak lurus. Hasil evaluasi yang buruk sering memaksa tim kembali ke pemahaman bisnis karena pertanyaannya ternyata kurang tepat.
Metode Data Mining: Prediktif dan Deskriptif
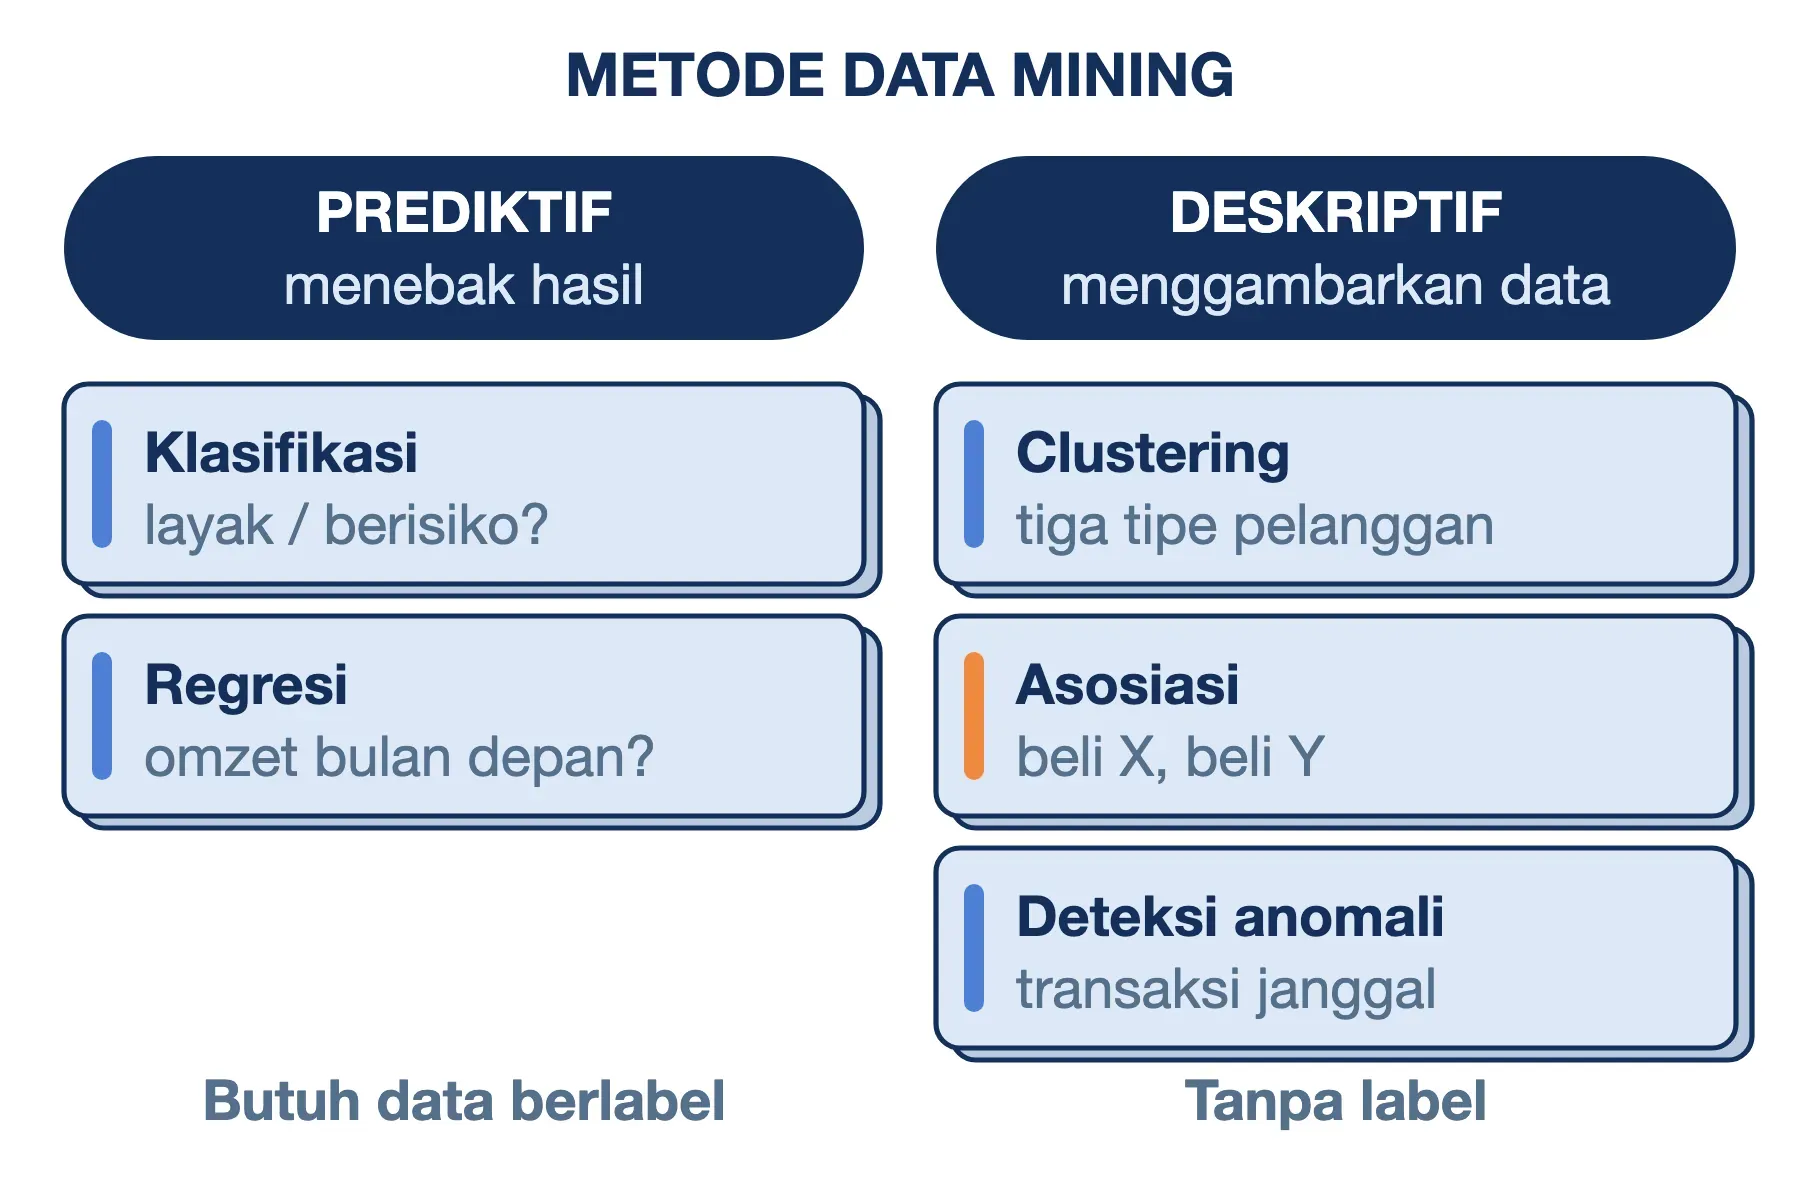
Metode data mining secara umum terbagi menjadi dua keluarga. Metode prediktif memakai data masa lalu yang sudah diketahui jawabannya untuk menebak data baru. Metode deskriptif tidak menebak apa pun, melainkan menggambarkan struktur yang ada di dalam data. Lalu, metode data mining apa saja yang termasuk di dalamnya? Daniel Larose dalam buku Discovering Knowledge in Data (2005) membagi tugas data mining menjadi enam: deskripsi, estimasi, prediksi, klasifikasi, clustering, dan asosiasi. Dalam praktik, keenam tugas itu dikerjakan oleh lima teknik data mining berikut.
Klasifikasi
Klasifikasi data mining adalah metode untuk menebak label atau kategori sebuah data. Contohnya, bank menentukan apakah pengajuan kredit masuk kategori "layak" atau "berisiko" berdasarkan penghasilan, riwayat cicilan, dan jumlah tanggungan. Model dilatih dari ribuan pengajuan lama yang hasilnya sudah diketahui, mirip cara kerja supervised learning. Algoritma yang umum dipakai antara lain decision tree, Naive Bayes, dan k-Nearest Neighbor (k-NN).
Regresi
Regresi juga termasuk metode prediksi data mining, tetapi yang ditebak berupa angka, bukan kategori. Toko dapat memperkirakan omzet bulan depan dari data harga, musim, dan anggaran iklan. Perbedaannya sederhana: klasifikasi menjawab "termasuk yang mana", regresi menjawab "berapa".
Clustering
Clustering (pengelompokan) membagi data menjadi kelompok berdasarkan kemiripan, tanpa label yang disiapkan sebelumnya. Sebuah aplikasi dompet digital, misalnya, dapat menemukan bahwa penggunanya terbagi menjadi kelompok "pembayar tagihan bulanan", "pembeli pulsa harian", dan "pengirim uang ke keluarga". Nama kelompok diberikan manusia setelah polanya ditemukan. Algoritma yang paling populer untuk tugas ini adalah k-means.
Asosiasi
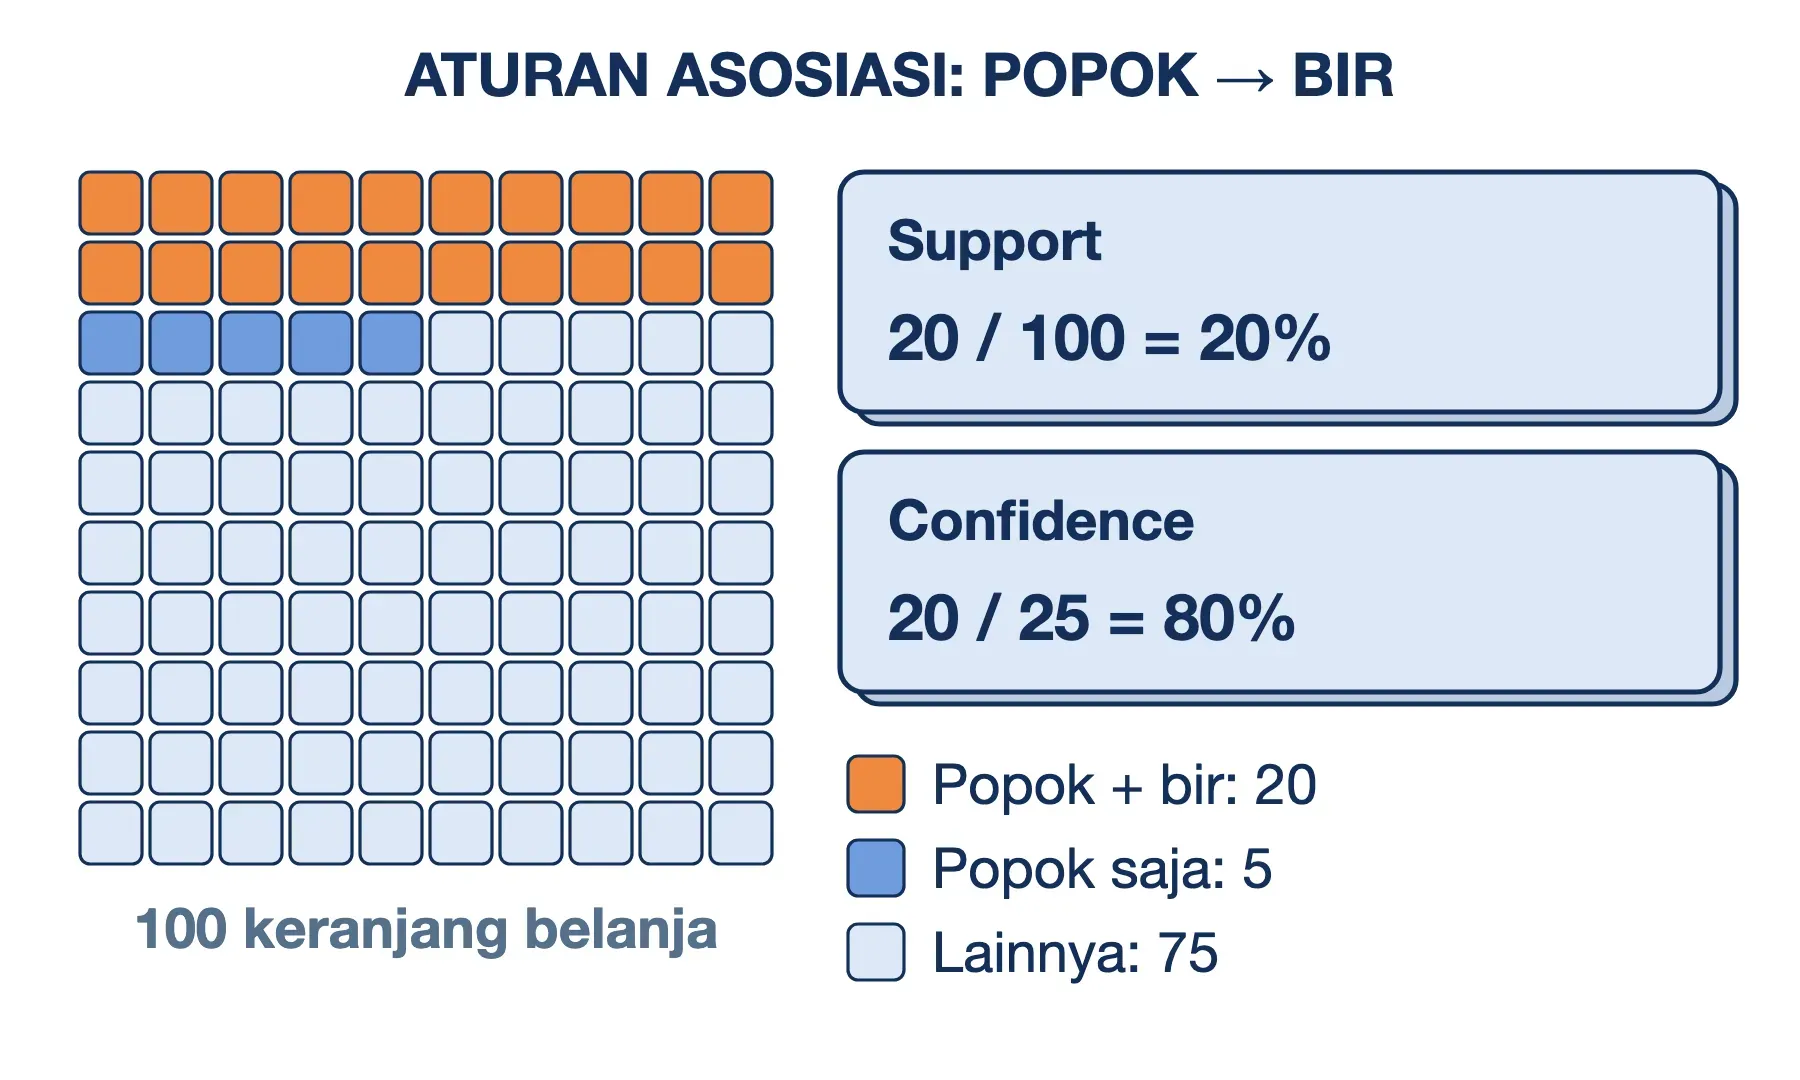
Asosiasi dalam data mining adalah teknik mencari aturan "jika membeli X, cenderung membeli Y" di dalam transaksi. Teknik ini dikenal juga sebagai market basket analysis (analisis keranjang belanja), dengan algoritma klasik Apriori. Kekuatan aturannya diukur dengan support (seberapa sering pasangan itu muncul) dan confidence (seberapa sering Y ikut dibeli saat X dibeli). Misalnya, dari 100 keranjang belanja, 25 berisi popok dan 20 di antaranya juga berisi bir. Aturan "popok → bir" punya support 20% (20 dari 100) dan confidence 80% (20 dari 25).
Contoh paling terkenal adalah kisah "bir dan popok". Versi yang beredar menyebut sebuah supermarket memindahkan rak bir ke sebelah popok lalu penjualan melonjak. Kenyataannya lebih sederhana. Pada 1992, tim Thomas Blischok di NCR/Teradata menganalisis sekitar 1,2 juta keranjang belanja jaringan apotek Osco Drug. Mereka menemukan bir dan popok cenderung dibeli bersamaan antara pukul 17.00 dan 19.00, tetapi Osco tidak pernah memindahkan raknya. Pelajarannya tetap berharga: pola hanya bernilai kalau ada keputusan yang mengikutinya.
Deteksi Anomali
Deteksi anomali mencari data yang menyimpang jauh dari kebiasaan. Bayangkan kartu kredit yang biasanya dipakai di Jakarta untuk belanja Rp200 ribu. Kalau tiba-tiba kartu itu dipakai di luar negeri untuk transaksi Rp15 juta pada pukul tiga pagi, sistem akan menandainya untuk diverifikasi. Metode ini banyak dipakai untuk deteksi penipuan, gangguan mesin pabrik, dan serangan jaringan.
Algoritma yang Digunakan dalam Data Mining
Setiap metode punya algoritma andalannya sendiri. Tabel berikut merangkum algoritma yang paling sering muncul di mata kuliah maupun pustaka Python:
| Metode | Pertanyaan yang dijawab | Algoritma populer |
|---|---|---|
| Klasifikasi | Termasuk kategori apa? | Decision tree (C4.5), Naive Bayes, k-NN |
| Regresi | Berapa nilainya? | Regresi linear, random forest |
| Clustering | Data mana yang mirip? | K-means, DBSCAN |
| Asosiasi | Apa yang muncul bersamaan? | Apriori, FP-Growth |
| Deteksi anomali | Mana yang tidak wajar? | Isolation forest, LOF |
Contoh Penerapan Data Mining di Sekitar Kita
Data mining sudah lama bekerja di balik layanan yang Anda pakai setiap hari. Berikut beberapa contoh penerapan data mining yang dekat dengan pembaca di Indonesia:
- Rekomendasi di marketplace: bagian "sering dibeli bersama" memakai aturan asosiasi dari jutaan transaksi.
- Pengamanan dompet digital dan bank: transaksi yang polanya janggal ditahan sementara sampai pemilik akun memverifikasi.
- Operator seluler: model klasifikasi menandai pelanggan yang berisiko pindah operator agar ditawari paket khusus.
- Kampus: data nilai dan kehadiran dipakai untuk menemukan mahasiswa yang berisiko terlambat lulus sejak semester awal.
- Ritel dan distribusi: regresi memperkirakan permintaan per toko sehingga stok tidak menumpuk atau kosong menjelang Lebaran.
Kesamaan kelimanya: datanya sudah ada sebagai catatan operasional, lalu data mining mengubahnya menjadi tindakan yang lebih tepat sasaran.
Aplikasi untuk Belajar Data Mining
Pertanyaan "data mining pakai aplikasi apa?" punya dua jawaban, tergantung apakah Anda ingin menulis kode atau tidak. Berikut aplikasi data mining yang paling sering dipakai di kampus maupun industri:
- Orange: aplikasi open source dari Universitas Ljubljana, Slovenia. Orange Data Mining adalah alat berbasis visual programming: Anda menyusun alur analisis dengan menyeret dan menghubungkan kotak (widget), tanpa menulis kode.
- Weka: aplikasi open source dari Universitas Waikato, Selandia Baru, yang lama menjadi bahan praktikum di kampus.
- KNIME: platform visual open source yang lebih cocok untuk alur kerja panjang dan data dari banyak sumber.
- Altair AI Studio: dulu bernama RapidMiner Studio, berganti nama sejak rilis 2024.0. Masih sering muncul di modul kuliah dengan nama lamanya.
- Python: pilihan utama di industri, dengan pustaka pandas untuk mengolah tabel dan scikit-learn untuk algoritma klasifikasi, regresi, dan clustering.
Untuk pemula, kami menyarankan memulai dari Orange selama dua sampai empat minggu dengan dataset kecil (di bawah 10.000 baris), misalnya dataset latihan dari Kaggle. Setelah alur seleksi, pembersihan, pemodelan, dan evaluasi terasa wajar, pindahlah ke Python agar analisis Anda bisa diulang dan diotomatisasi.
Kelemahan dan Hal yang Perlu Dipertimbangkan
Data mining bukan mesin yang selalu menghasilkan kebenaran. Ada beberapa batasan yang perlu Anda pahami sebelum mempercayai hasilnya:
- Kualitas data menentukan hasil: data yang kosong, ganda, atau salah input akan menghasilkan pola yang salah. Prinsip ini dikenal sebagai garbage in, garbage out.
- Korelasi bukan sebab-akibat: bir dan popok dibeli bersamaan tidak berarti bir membuat orang membeli popok. Bisa jadi keduanya sama-sama dibeli oleh orang tua yang mampir sepulang kerja. Data mining menemukan hubungan, sedangkan penjelasannya tetap membutuhkan pemahaman manusia.
- Pola palsu: semakin banyak kombinasi yang dicoba, semakin besar peluang menemukan pola yang muncul karena kebetulan. Praktik mengaduk data sampai "ketemu sesuatu" ini disebut data dredging. Model yang terlalu menghafal data latih (overfitting) juga akan gagal saat bertemu data baru.
- Privasi: pada 2012, The New York Times memberitakan bahwa jaringan ritel Target di Amerika menyusun skor dugaan kehamilan pelanggan. Skor itu dihitung dari pola pembelian sekitar 25 produk, seperti losion tanpa pewangi dan suplemen tertentu. Di Indonesia, UU No. 27 Tahun 2022 tentang Pelindungan Data Pribadi menggolongkan data kesehatan sebagai data pribadi spesifik. Pasal 10 juga memberi pemilik data hak mengajukan keberatan atas keputusan yang hanya didasarkan pada pemrosesan otomatis, termasuk profiling (pemrofilan), bila keputusan itu berdampak signifikan.
- Biaya dan keahlian: proyek data mining membutuhkan data yang tertata, infrastruktur, dan orang yang paham statistik sekaligus bisnisnya. Untuk usaha kecil dengan transaksi di bawah beberapa ribu per bulan, laporan penjualan sederhana sering kali sudah memadai.
Pertanyaan yang Sering Diajukan
Mata kuliah data mining belajar apa?
Umumnya materi data mining di mata kuliah ini dimulai dari konsep KDD dan praproses data, lalu berlanjut ke metode klasifikasi, clustering, dan asosiasi beserta algoritmanya. Bagian akhir biasanya membahas evaluasi model, seperti akurasi dan confusion matrix (tabel tebakan benar dan salah). Praktikumnya memakai Weka, Orange, atau Python.
Apa beda data mining dan data science?
Data science adalah bidang yang lebih luas. Cakupannya meliputi pengumpulan data, rekayasa data, analisis, visualisasi, sampai membangun produk berbasis data. Data mining adalah salah satu pekerjaan di dalamnya, yaitu menggali pola dari data yang sudah tersedia.
Apakah data mining harus bisa coding?
Tidak untuk tahap awal. Orange, Weka, dan KNIME memungkinkan Anda menjalankan klasifikasi atau clustering tanpa satu baris kode pun. Namun, untuk pekerjaan di industri, kemampuan Python dan SQL hampir selalu diminta karena analisis perlu diulang, diotomatisasi, dan dihubungkan ke sistem lain.
Kesimpulan
Data mining adalah langkah menggali pola baru dari data berjumlah besar, yang dalam kerangka KDD diapit oleh tahap persiapan data dan tahap interpretasi. Metodenya terbagi menjadi prediktif (klasifikasi dan regresi) dan deskriptif (clustering, asosiasi, deteksi anomali), dengan CRISP-DM sebagai panduan proyek yang paling banyak dipakai. Data mining layak digunakan saat data sudah melimpah dan ada keputusan nyata yang menunggu. Hasilnya tetap perlu dibaca dengan kritis karena pola bukan sebab-akibat dan data pribadi dilindungi undang-undang.
Semoga artikel ini membantu.