Hampir semua orang pernah mengolah data di spreadsheet. Satu lembar kerja Microsoft Excel mampu menampung 1.048.576 baris dan 16.384 kolom, angka yang terasa tidak akan habis untuk laporan penjualan bulanan. Ketika data tumbuh melewati batas itu, data biasanya dipindahkan ke database yang berjalan di sebuah server. Database sanggup menyimpan miliaran baris, selama server tempatnya berjalan masih kuat.
Masalah muncul ketika satu server pun tidak lagi cukup. Catatan klik jutaan pengguna aplikasi atau rekaman sensor yang masuk setiap detik tidak muat di satu mesin, apalagi diolah tepat waktu. Big data adalah sebutan untuk kumpulan data seperti ini, beserta cara menyimpan dan mengolahnya dengan banyak mesin sekaligus. Artikel ini membahas pengertian big data, karakteristik 5V, cara kerja, contoh di sekitar kita, hingga kekurangannya.
Apa Itu Big Data?
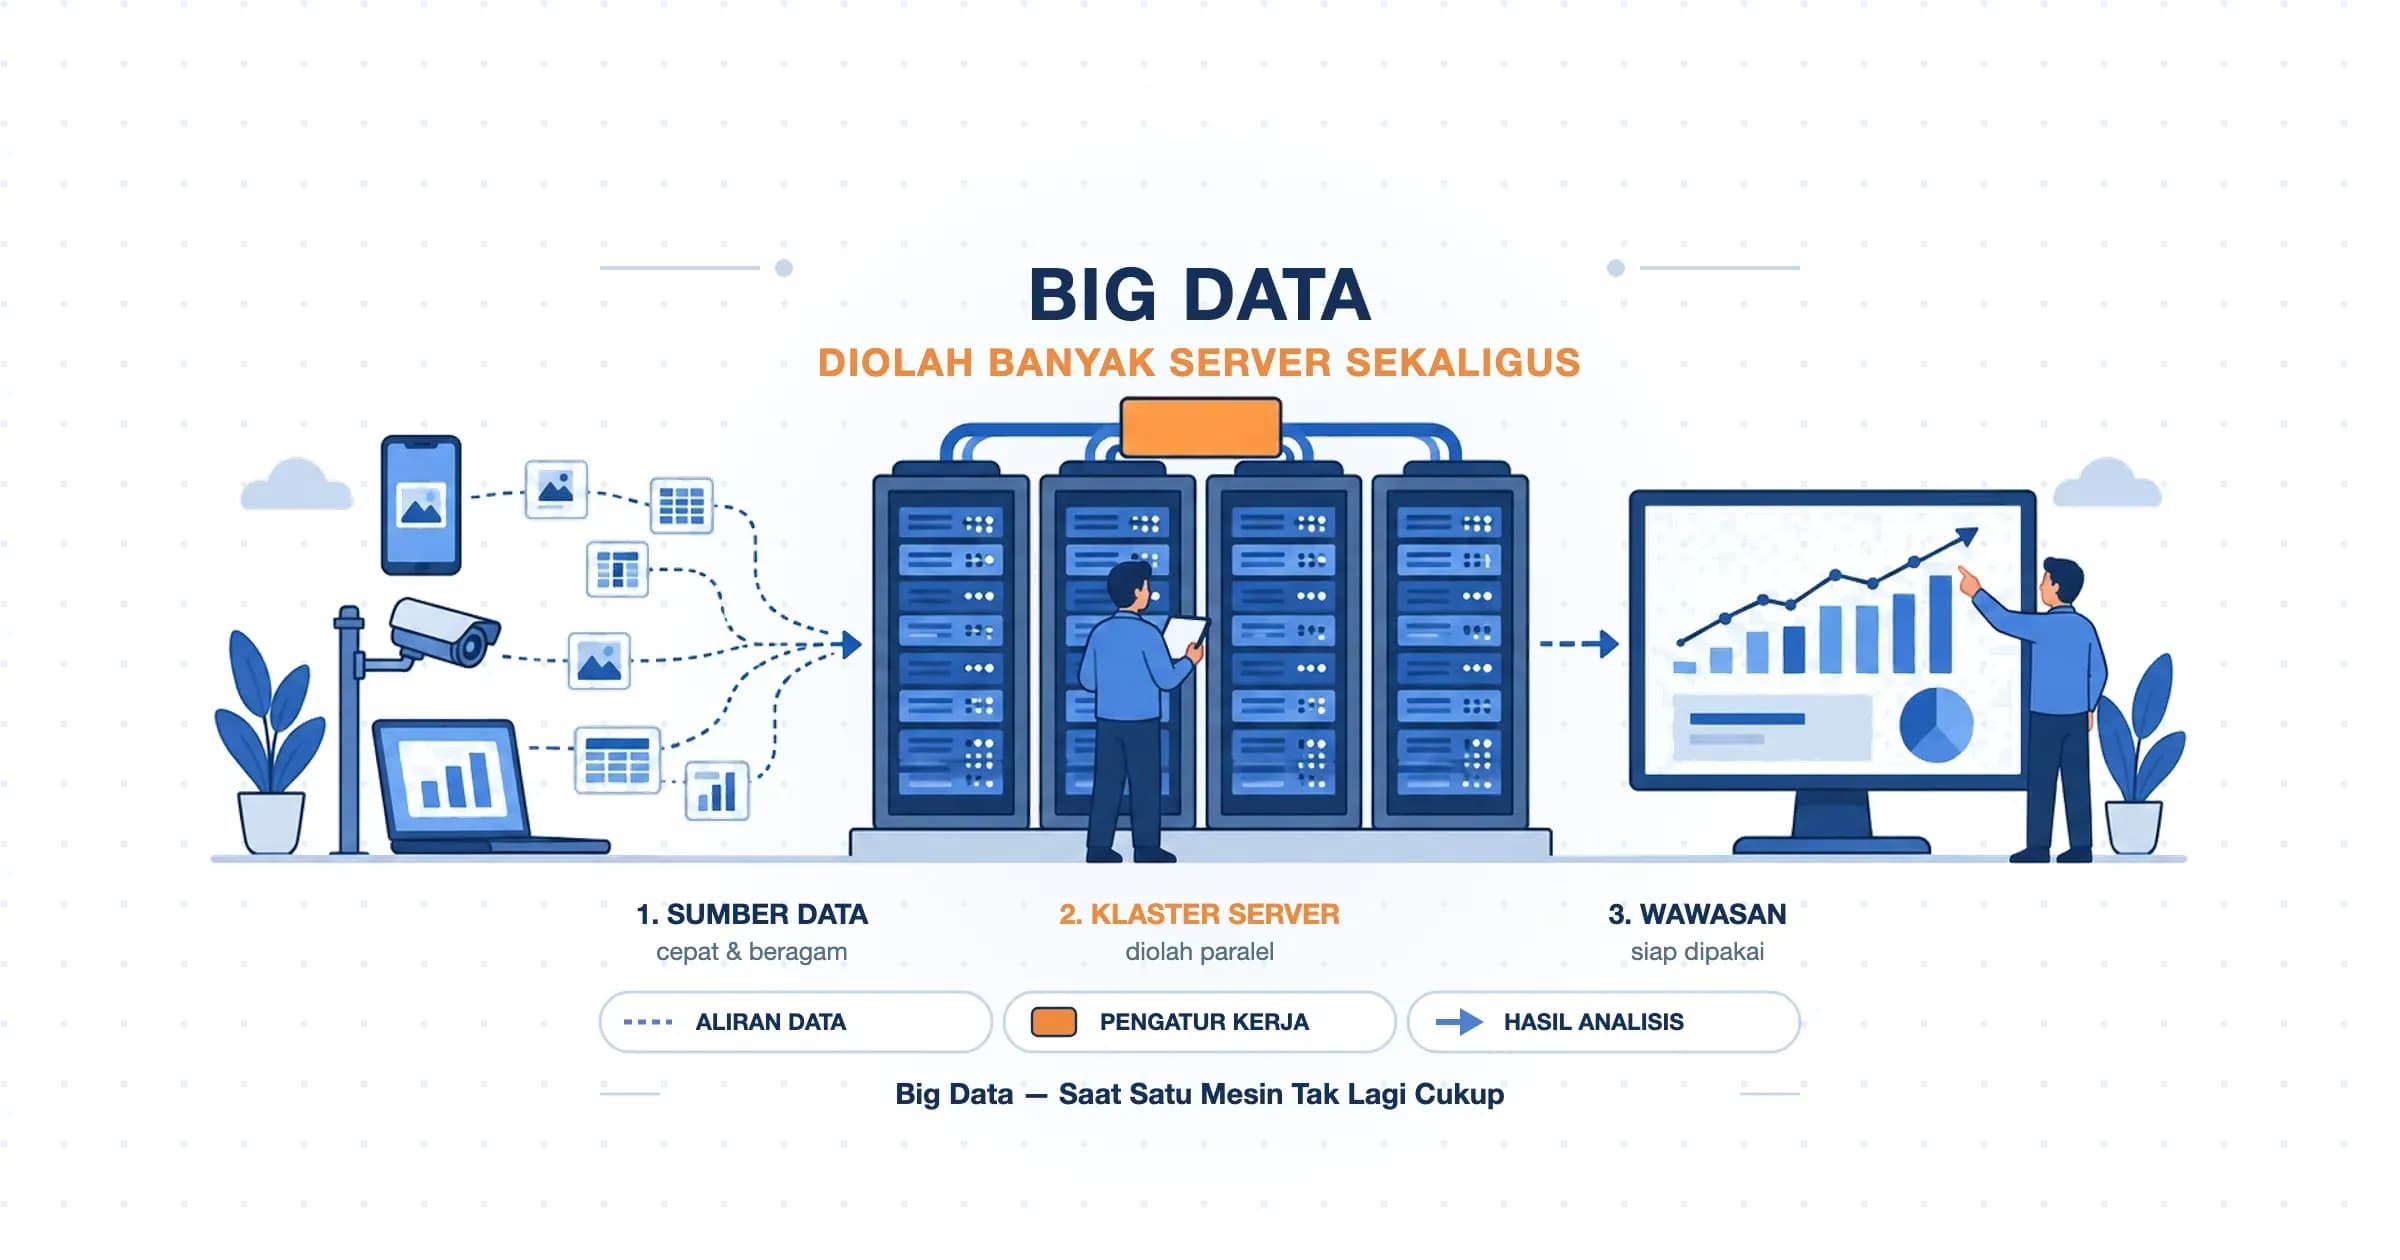
Big data adalah kumpulan data yang ukuran, kecepatan datang, atau keragaman bentuknya melampaui kemampuan sistem pengolah data biasa di satu mesin. Karena itu, data tersebut harus disimpan dan diolah secara terdistribusi, yaitu dibagi ke banyak komputer yang bekerja bersamaan.
Secara harfiah, arti big data adalah "data besar". Namun, yang dimaksud dengan big data bukan sekadar ukuran. Data yang tidak terlalu besar pun bisa melampaui kemampuan satu mesin kalau datangnya terlalu cepat atau bentuknya terlalu beragam.
Konsep big data ini sejalan dengan rumusan NIST (National Institute of Standards and Technology), lembaga standar Amerika Serikat, dalam dokumen SP 1500-1r2. NIST menyebut big data bercirikan volume, velocity, variety, dan/atau variability yang menuntut arsitektur yang bisa diperbesar. Inovasi utamanya ada pada horizontal scaling, yaitu menambah komputer ke dalam klaster alih-alih memperbesar satu komputer.
Perlu diperhatikan, istilah big data dipakai untuk dua hal: datanya sendiri, dan teknologi untuk mengolahnya. Saat seseorang berkata "perusahaan itu memakai big data", yang dimaksud biasanya arti kedua.
Sejarah Big Data: Dari Istilah sampai Hadoop
Istilah big data kemungkinan lahir dari diskusi para insinyur Silicon Graphics (SGI) pada pertengahan 1990-an, dengan John Mashey sebagai pemakai yang paling menonjol. Kerangka konsepnya datang pada Februari 2001. Doug Laney dari META Group (kini bagian Gartner) menulis catatan riset tentang tiga dimensi data: volume, velocity, dan variety. Tiga dimensi inilah yang dikenal sebagai 3V.
Teknologinya menyusul tidak lama kemudian. Makalah Google tentang Google File System (2003) dan MapReduce (2004) menjelaskan cara mengolah data di ribuan server murah. Gagasan itu diadopsi menjadi Hadoop pada 2006, proyek open source yang versi 1.0-nya dirilis Desember 2011. Apache Spark 1.0 menyusul pada Mei 2014.
Kapan Data Pantas Disebut Big Data?
Tidak ada angka resmi yang menjadi garis batas big data. Data 10 TB bisa jadi urusan rutin bagi satu perusahaan, tetapi menjadi masalah besar bagi perusahaan lain yang harus menganalisisnya setiap lima menit. Patokan yang lebih berguna adalah satu pertanyaan: apakah satu mesin masih sanggup?
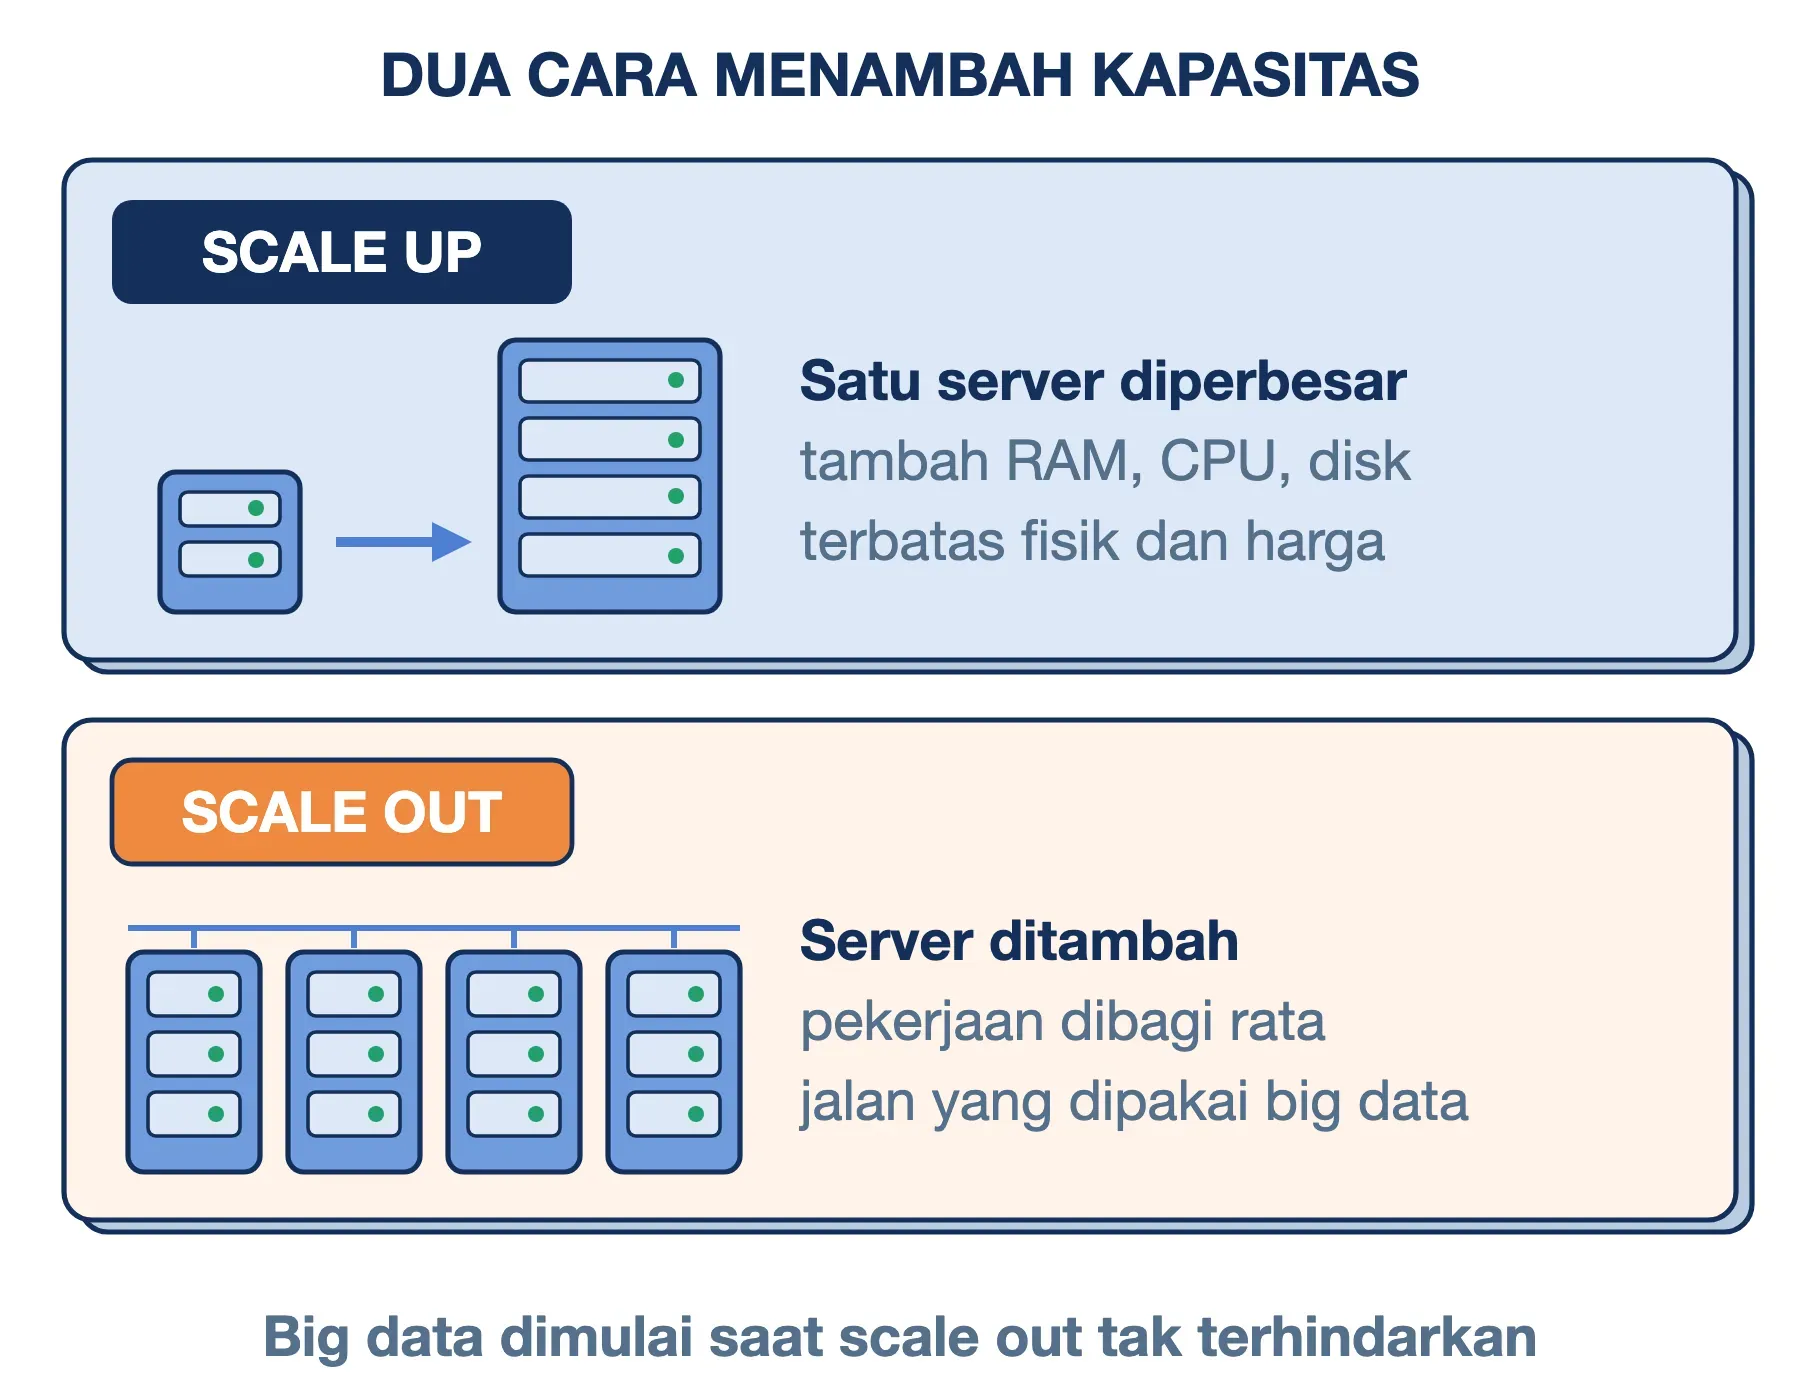
Saat data tumbuh, ada dua cara menambah kapasitas. Scale up (skala vertikal) berarti memperbesar satu server dengan menambah RAM, CPU, atau disk. Scale out (skala horizontal) berarti menambah jumlah server lalu membagi pekerjaan di antara mereka. Scale up lebih sederhana, tetapi suatu saat mencapai batas karena satu mesin punya batas fisik dan harganya naik tajam di kelas atas. Data mulai pantas disebut big data ketika scale out menjadi satu-satunya jalan yang masuk akal.
Untuk mengujinya, ajukan tiga pertanyaan berikut terhadap data Anda:
- Apakah data masih muat di satu server? Hitung juga pertumbuhannya. Data 500 GB yang bertambah 2 GB per hari masih nyaman. Data yang bertambah 500 GB per hari akan memenuhi server mana pun dalam hitungan bulan.
- Apakah analisis rutin selesai tepat waktu? Laporan harian yang butuh sepuluh jam untuk dihitung adalah tanda satu mesin sudah kewalahan.
- Apakah data datang lebih cepat daripada kemampuan mencatatnya? Puluhan ribu kejadian per detik sering kali tidak sanggup ditulis oleh satu server database.
Jika ketiga jawabannya masih "satu mesin cukup", data Anda belum termasuk big data, dan pengelolaannya jauh lebih murah. Sebagai patokan kasar, database toko online berukuran 20–50 GB masih nyaman ditangani satu server database yang dirawat baik. Sebaliknya, catatan klik jutaan pengguna yang bertambah ratusan gigabyte per hari sudah masuk wilayah big data.
Data yang masih nyaman diolah satu mesin sering disebut small data. Jadi, perbedaan big data vs small data bukan soal penting atau tidaknya data, melainkan soal alat yang dibutuhkan untuk mengolahnya.
Karakteristik Big Data: 3V, 5V, dan Seterusnya
Karakteristik big data paling sering dijelaskan dengan huruf V. Tiga V pertama, yang dikenal sebagai 3V big data, berasal dari Laney, sedangkan dua berikutnya ditambahkan para praktisi karena ukuran saja tidak menjamin data berguna. Gabungan kelimanya dikenal sebagai 5V big data.
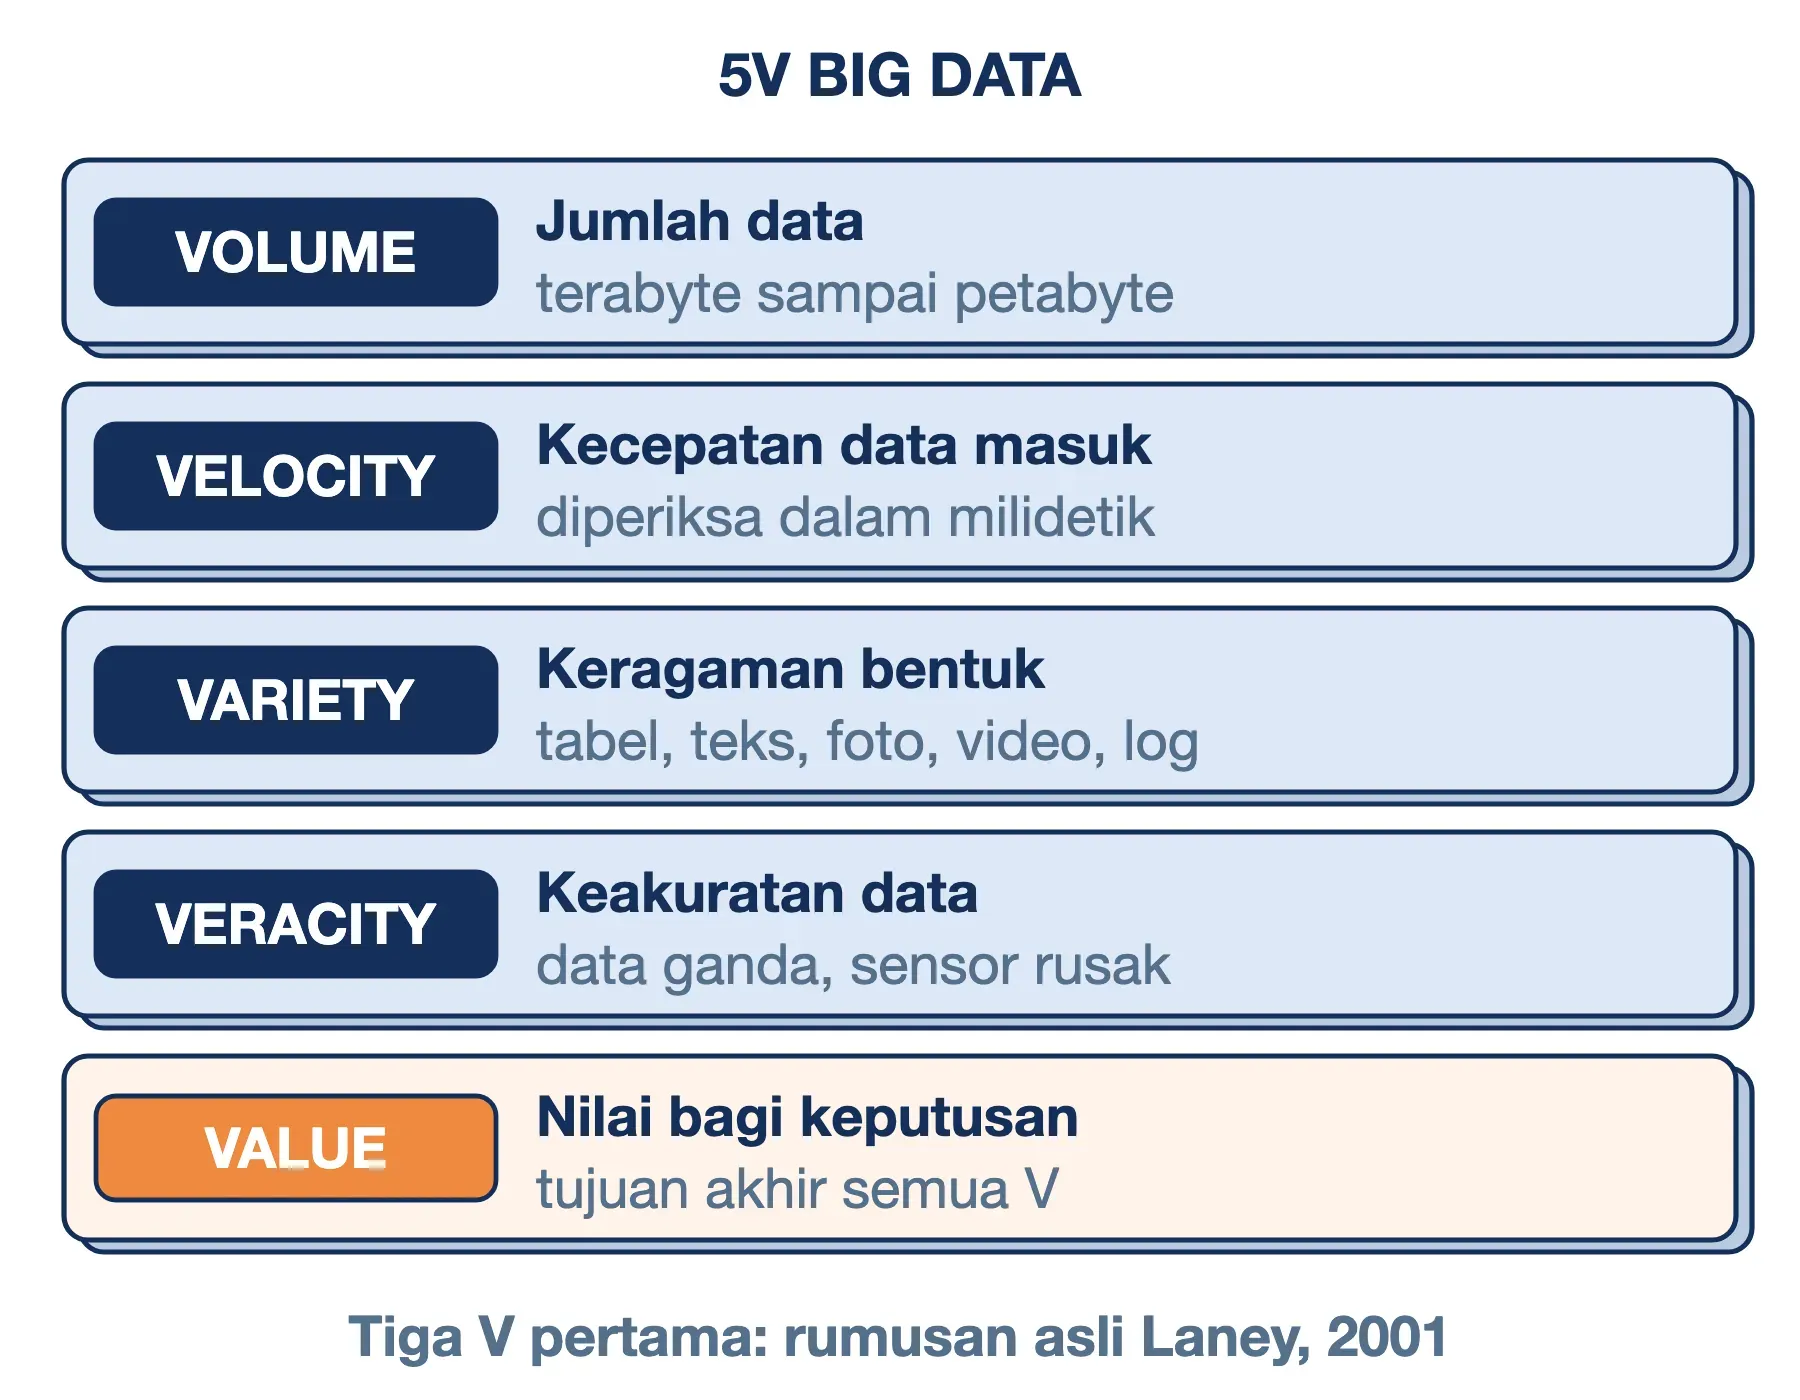
- Volume (jumlah): Banyaknya data yang harus disimpan, biasanya dalam satuan terabyte (TB) hingga petabyte (PB). Sebagai gambaran skala dunia, IDC pada 2018 memproyeksikan total data global naik dari 33 zettabyte menjadi 175 zettabyte pada 2025. Satu zettabyte setara dengan satu miliar terabyte.
- Velocity (kecepatan): Laju data datang dan harus diproses. Transaksi kartu debit, misalnya, perlu diperiksa dalam hitungan milidetik sebelum disetujui. Jadi, velocity dalam big data adalah ukuran seberapa cepat data mengalir masuk.
- Variety (keragaman): Bentuk data yang bermacam-macam, mulai dari tabel, teks, foto, video, hingga log server.
- Veracity (keakuratan): Veracity big data adalah ukuran seberapa jauh data bisa dipercaya. Data ganda, sensor rusak, atau akun palsu menurunkan veracity.
- Value (nilai): Manfaat nyata yang bisa diambil. Data sebanyak apa pun tidak bernilai kalau tidak menjawab pertanyaan bisnis atau penelitian.
Saat ditanya elemen penting dalam big data, lima V di atas adalah jawaban yang paling umum diterima. Beberapa buku masih memakai 3V versi asli, sementara yang lain menambahkan V hingga tujuh atau lebih.
Variability dan Volatility: Dua V yang Sering Tertukar
Variability (variabilitas) adalah perubahan pada perilaku data itu sendiri: laju alirannya naik-turun, formatnya berganti, atau maknanya bergeser. Contohnya lalu lintas toko online yang melonjak berlipat-lipat saat promo tanggal kembar. Perilaku sumber data yang berkembang dinamis seperti inilah yang disebut variability.
Volatility (volatilitas) adalah kecenderungan nilai data berubah seiring waktu, misalnya harga saham atau alamat pelanggan. NIST menegaskan bahwa hanya variability yang memengaruhi arsitektur, karena sistem harus mampu menambah atau mengurangi sumber daya mengikuti lonjakan.
Jenis Big Data Berdasarkan Bentuk Datanya
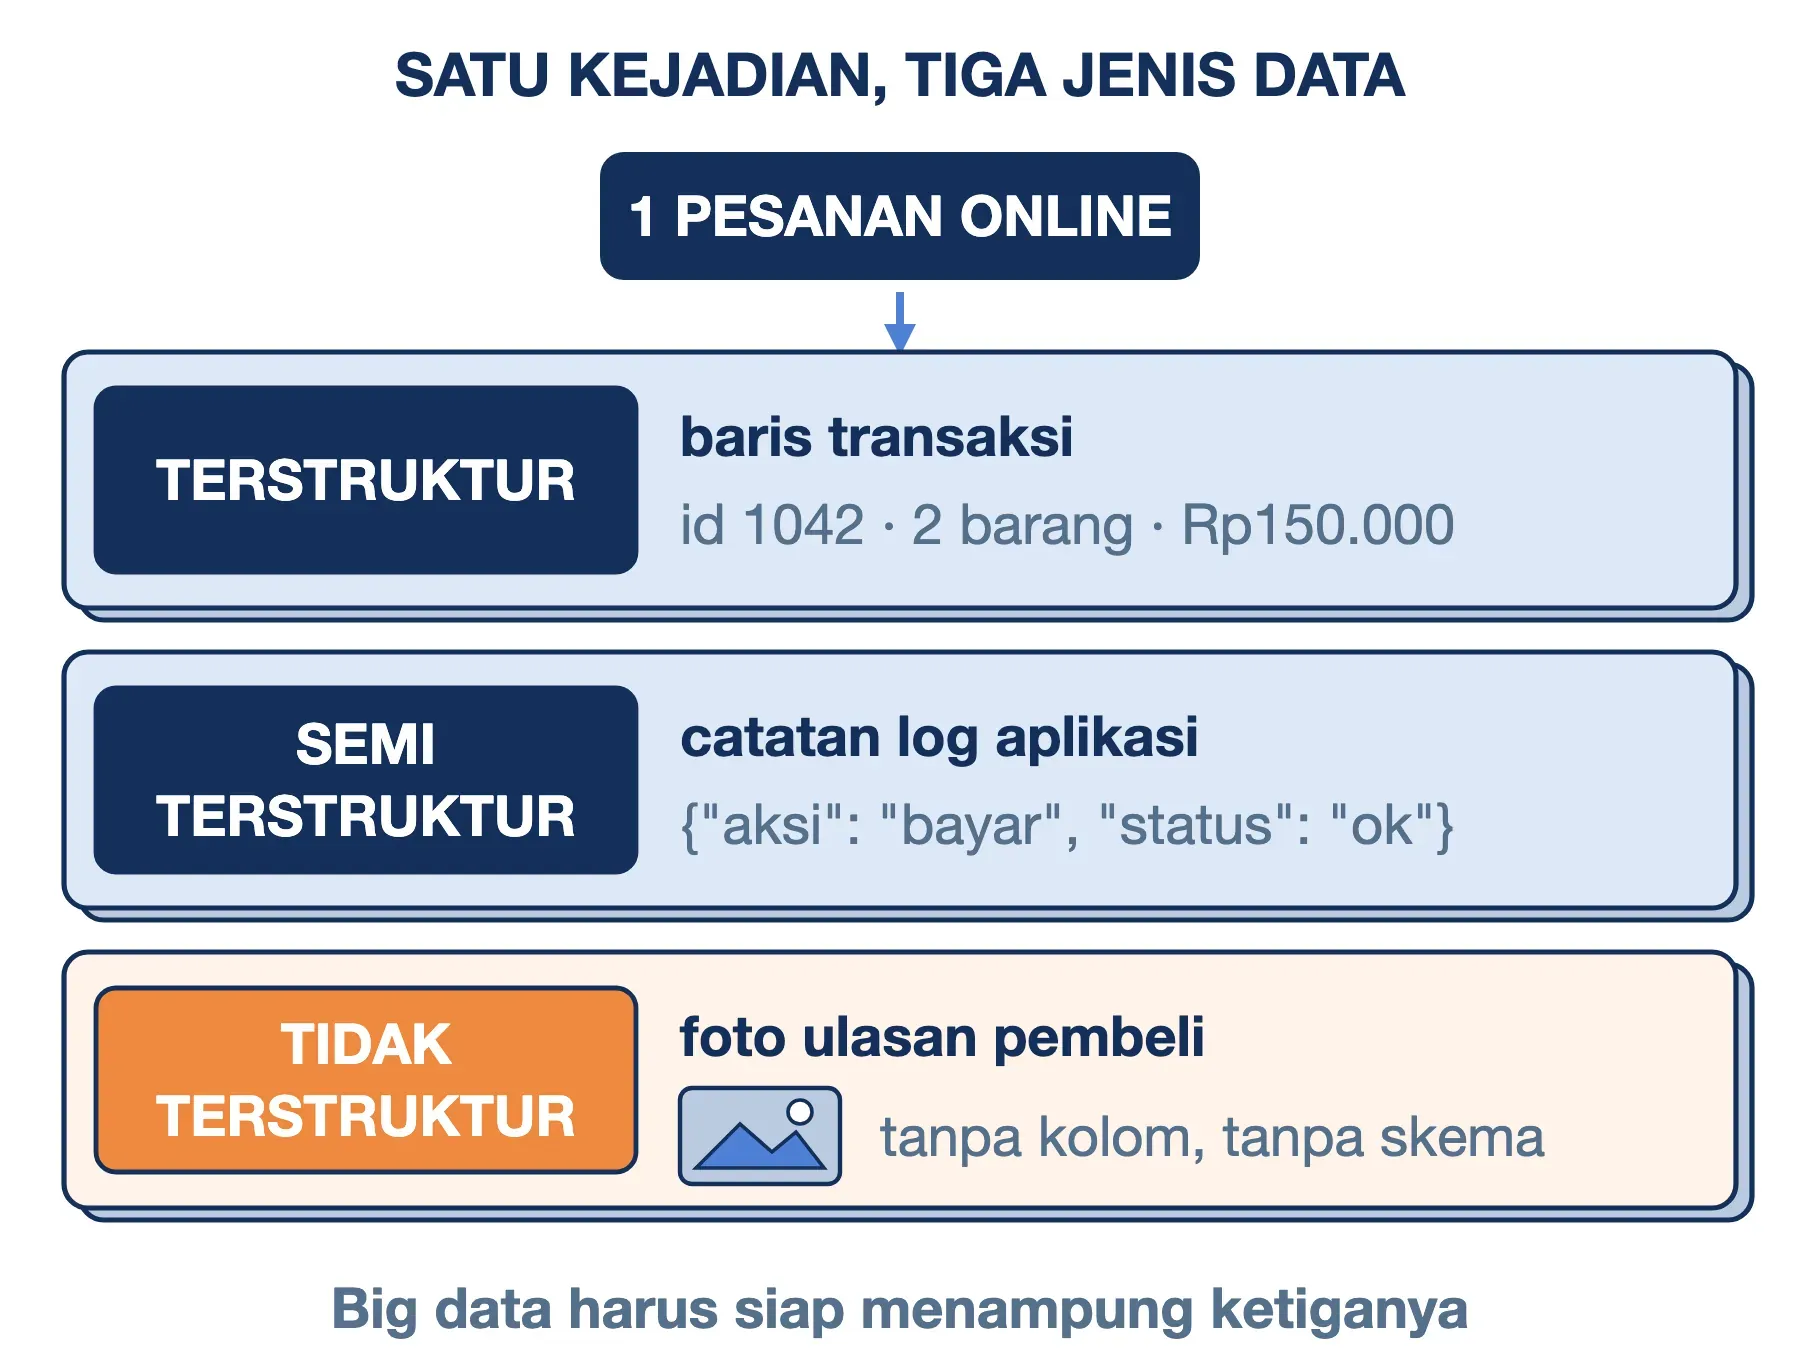
Berdasarkan bentuknya, data dalam sistem big data terbagi menjadi tiga jenis:
- Data terstruktur: Tersusun dalam baris dan kolom dengan skema tetap, seperti tabel transaksi atau data nasabah. Jenis ini paling mudah diolah dengan SQL.
- Data semi-terstruktur: Punya penanda yang memberi sedikit keteraturan, tetapi skemanya longgar. Contohnya berkas JSON, XML, log server, dan email yang header-nya rapi tetapi isinya bebas.
- Data tidak terstruktur: Tidak punya format baku, seperti foto, video, rekaman suara, dan teks unggahan media sosial.
Ketiga jenis ini sering lahir dari satu kejadian. Satu pesanan di aplikasi belanja menghasilkan baris transaksi (terstruktur), catatan log (semi-terstruktur), dan foto ulasan pembeli (tidak terstruktur). Karena itu, sistem big data tidak bisa hanya mengandalkan tabel.
Bagaimana Big Data Diolah?
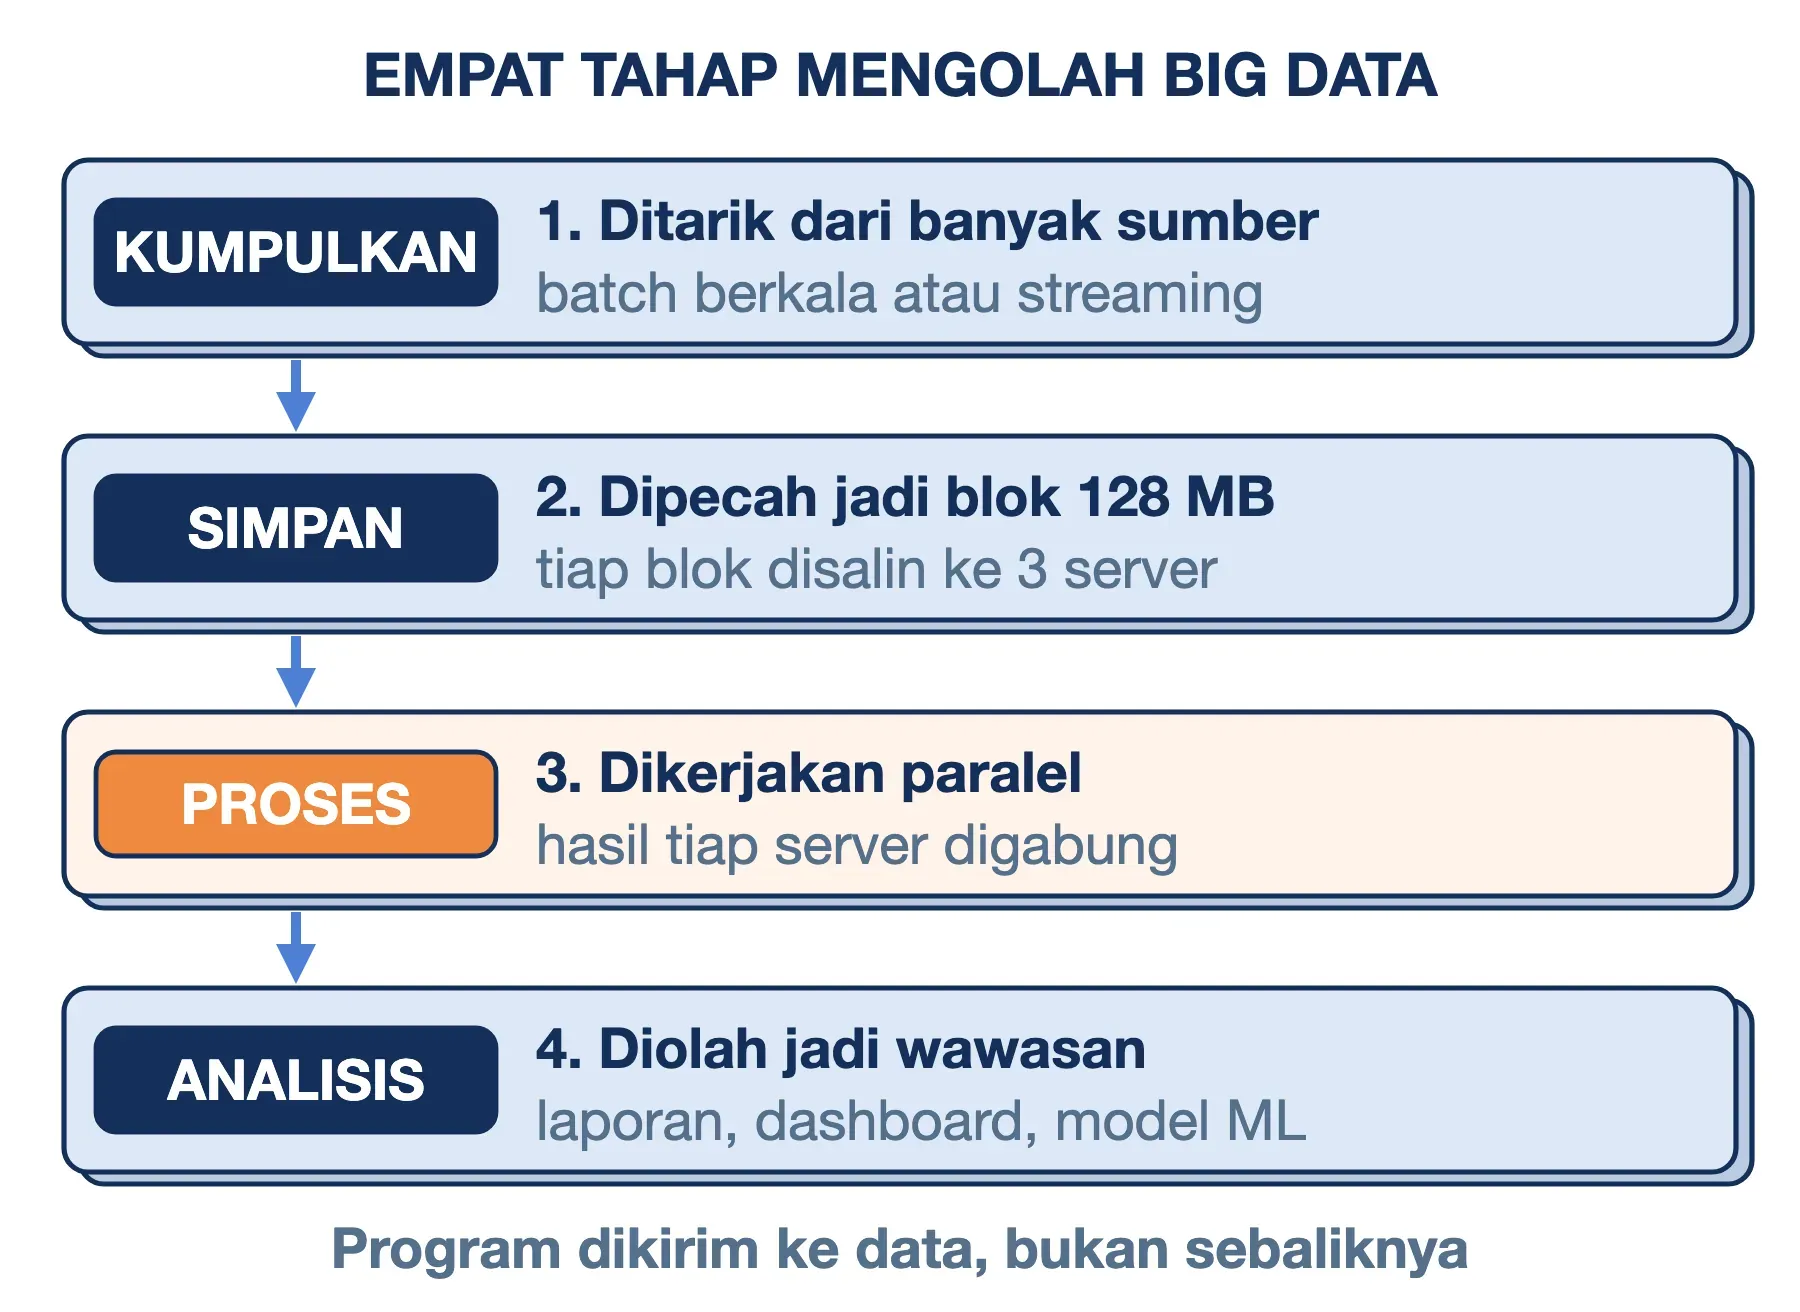
Cara kerja big data umumnya melewati empat tahap berurutan:
- Pengumpulan: Data ditarik dari banyak sumber, seperti aplikasi, sensor, log server, dan media sosial. Polanya ada dua, yaitu batch (dikumpulkan lalu dikirim berkala, misalnya tiap malam) dan streaming (dialirkan terus-menerus begitu terjadi). Pola streaming biasa memakai perantara seperti Apache Kafka supaya tidak ada data tercecer saat terjadi lonjakan.
- Penyimpanan: Data dipecah lalu disebar ke banyak server. Di HDFS (Hadoop Distributed File System), berkas dipotong menjadi blok berukuran 128 MB secara bawaan, dan setiap blok disalin ke tiga server berbeda. Jika satu server rusak, dua salinan lain masih tersedia. Database NoSQL memakai prinsip serupa untuk data berbentuk dokumen atau pasangan kunci-nilai.
- Pemrosesan: Pekerjaan dibagi ke semua server, dikerjakan paralel, lalu hasilnya digabungkan. Prinsipnya mirip sensus satu kota. Satu petugas tidak mungkin mendatangi semua rumah dalam sehari, tetapi seratus petugas yang masing-masing memegang satu kelurahan bisa, lalu kantor pusat cukup menjumlahkan rekapnya.
- Analisis dan penyajian: Data yang sudah diolah dianalisis dengan statistik, query, atau machine learning. Hasilnya disajikan sebagai laporan, dashboard, atau langsung dipakai aplikasi, misalnya untuk rekomendasi produk.
Ada satu prinsip yang membedakan sistem big data dari server biasa: program dibawa ke data, bukan sebaliknya. Mengirim kode beberapa kilobyte ke seratus server jauh lebih murah daripada memindahkan ratusan terabyte data ke satu server. Inilah alasan penyimpanan dan pemrosesan big data biasanya berjalan di mesin yang sama.
Teknologi Big Data yang Umum Dipakai
Beberapa nama berikut akan sering Anda temui saat mempelajari arsitektur big data:
- Hadoop: Kerangka kerja open source berisi HDFS untuk penyimpanan dan MapReduce untuk pemrosesan.
- Apache Spark: Mesin pemrosesan yang menyimpan data antara di memori, sehingga lebih cepat untuk analisis berulang dan machine learning.
- Apache Kafka: Jalur antrean untuk data streaming.
- Database NoSQL: Seperti Cassandra, MongoDB, dan HBase, untuk data berskema longgar.
- Layanan cloud: Google BigQuery dan Amazon EMR menyediakan kemampuan di atas tanpa membangun klaster sendiri. Model cloud computing ini memungkinkan organisasi kecil mencoba big data dengan membayar sesuai pemakaian.
Fungsi dan Manfaat Big Data
Fungsi big data paling mudah dipahami lewat jenis pertanyaan yang bisa dijawabnya:
- Melihat apa yang sudah terjadi: Produk mana yang paling laku di tiap kota, atau jam berapa aplikasi paling ramai dikunjungi.
- Mencari tahu penyebabnya: Kenapa penjualan turun di satu wilayah, dengan menggabungkan data penjualan, cuaca, dan keluhan pelanggan.
- Memperkirakan yang akan terjadi: Kebutuhan stok bulan depan, lonjakan pemakaian listrik, atau titik kemacetan pada jam pulang kantor.
- Bertindak otomatis secara real time: Memblokir transaksi mencurigakan, menyesuaikan harga, atau menampilkan rekomendasi saat pengguna masih membuka aplikasi.
Manfaat big data bermuara pada keputusan berbasis bukti, bukan firasat. Namun, manfaat itu hanya muncul kalau pertanyaannya jelas sejak awal.
Contoh Big Data dalam Kehidupan Sehari-hari
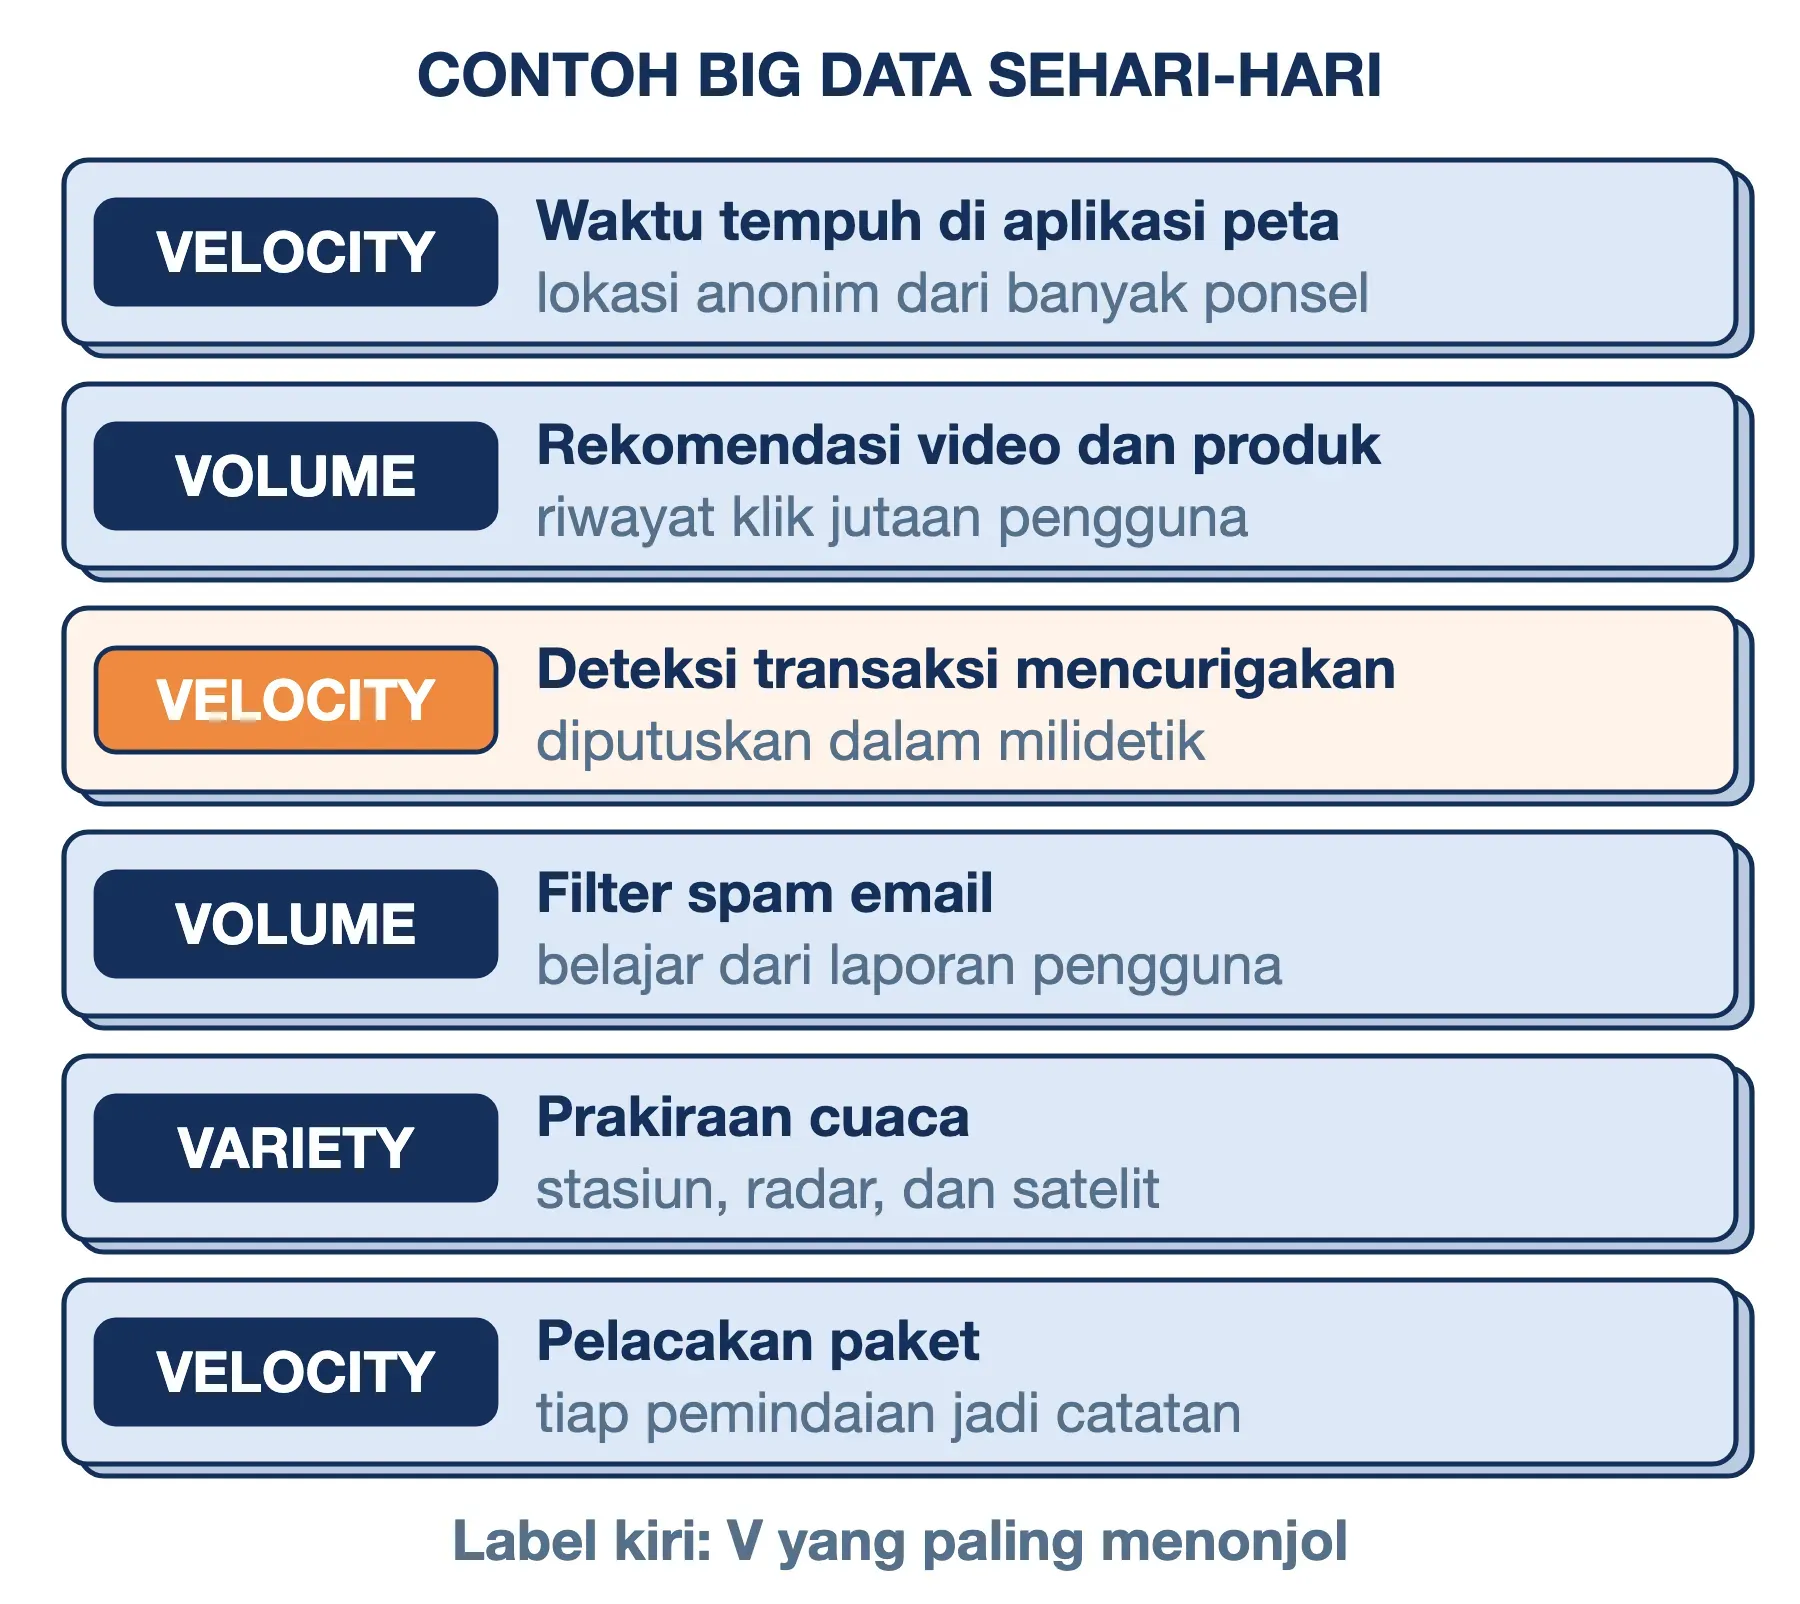
Penerapan big data paling mudah dikenali di layanan yang Anda pakai setiap hari. Berikut contohnya, beserta V yang paling menonjol:
- Estimasi waktu tempuh di aplikasi peta: Aplikasi navigasi menggabungkan data lokasi anonim dari banyak ponsel yang bergerak untuk menebak kepadatan jalan (velocity).
- Rekomendasi video dan produk: Daftar "mungkin Anda suka" disusun dari riwayat klik jutaan pengguna lain yang seleranya mirip (volume dan variety).
- Deteksi transaksi mencurigakan: Bank membandingkan setiap transaksi dengan pola kebiasaan Anda dalam hitungan milidetik. Pembelian di luar negeri lima menit setelah Anda belanja di Jakarta akan langsung ditahan (velocity dan veracity).
- Filter spam email: Penyedia email belajar dari laporan spam jutaan pengguna, sehingga pola penipuan baru cepat dikenali (volume).
- Prakiraan cuaca: Data stasiun pengamatan, radar, dan satelit digabungkan lalu dihitung dengan model numerik (volume dan variety).
- Pelacakan paket: Setiap pemindaian di gudang dan di tangan kurir menjadi satu catatan baru yang terus mengalir (velocity).
Big Data Analytics dan Hubungannya dengan AI
Big data analytics adalah proses memeriksa big data untuk menemukan pola, hubungan, dan wawasan yang membantu pengambilan keputusan. Empat fungsi pada section sebelumnya sebenarnya mewakili empat jenis analitik. Keempatnya adalah analitik deskriptif (apa yang terjadi), diagnostik (kenapa terjadi), prediktif (apa yang akan terjadi), dan preskriptif (apa yang sebaiknya dilakukan).
Hubungan big data dengan kecerdasan buatan berjalan dua arah. Machine learning adalah salah satu alat analisis big data yang paling kuat, karena mampu menemukan pola yang terlalu rumit untuk dirumuskan manual. Sebaliknya, model AI modern membutuhkan big data sebagai bahan belajar. Jadi, big data bukan AI, tetapi AI hari ini hampir tidak mungkin ada tanpa big data.
Big Data, Database, Data Warehouse, dan Data Lake
Keempat istilah ini sering dipakai bergantian, padahal levelnya berbeda. Big data adalah sifat masalahnya, sedangkan database, data warehouse, dan data lake adalah tempat menyimpan data. Masing-masing cocok untuk kebutuhan berbeda.
| Aspek | Database operasional | Data warehouse | Data lake |
|---|---|---|---|
| Fungsi utama | Melayani transaksi harian aplikasi | Laporan dan analisis | Menampung semua data mentah |
| Jenis data | Terstruktur | Terstruktur, sudah dibersihkan | Semua jenis, apa adanya |
| Skema | Ditentukan sebelum data masuk | Ditentukan sebelum data masuk | Ditentukan saat data dibaca |
| Pengguna khas | Aplikasi dan developer | Analis bisnis | Data scientist dan data engineer |
| Contoh | MySQL, PostgreSQL | BigQuery, Snowflake, Amazon Redshift | HDFS, Amazon S3 |
Dari tabel ini terlihat bahwa big data vs data warehouse bukan perbandingan setara. Data warehouse bisa menjadi bagian dari sistem big data, begitu pula data lake. Banyak organisasi kini menggabungkan keduanya dalam pola yang disebut data lakehouse, yaitu data lake yang diberi kemampuan pengelolaan tabel ala data warehouse.
Kekurangan dan Tantangan Big Data
Big data bukan solusi untuk semua masalah data. Ada beberapa konsekuensi yang perlu Anda pertimbangkan sebelum memulainya:
- Biayanya tidak kecil: Klaster berisi banyak server membutuhkan listrik, pendingin, dan ruang di data center, ditambah tenaga ahli. Layanan cloud memangkas investasi awal, tetapi tagihannya bisa membengkak kalau query besar dijalankan sembarangan.
- Data kotor menghasilkan kesimpulan keliru: Prinsip garbage in, garbage out berlaku penuh. Membersihkan data ganda, salah format, dan nilai kosong sering memakan porsi waktu terbesar dalam proyek data.
- Risiko privasi dan keamanan: Makin banyak data pribadi dikumpulkan, makin besar dampaknya jika bocor. UU Nomor 27 Tahun 2022 tentang Pelindungan Data Pribadi berlaku penuh sejak 17 Oktober 2024. Setiap data pribadi yang diproses wajib punya dasar yang sah, sehingga kebiasaan "kumpulkan semua dulu" justru menambah risiko hukum. Masalah keamanan big data juga lebih rumit karena data tersebar di banyak server, sehingga setiap server menjadi pintu masuk yang perlu dijaga.
- Hubungan bukan berarti sebab-akibat: Dengan data yang sangat banyak, pola kebetulan hampir pasti muncul. Dua angka yang naik bersamaan belum tentu saling memengaruhi.
- Butuh keahlian khusus: Sistem terdistribusi membutuhkan data engineer untuk merawatnya dan data scientist untuk menafsirkan hasilnya. Keduanya masih langka dan mahal.
- Sering kali belum dibutuhkan: Banyak organisasi membangun klaster big data padahal datanya masih muat di satu server. Tiga pertanyaan uji di awal artikel membantu menghindari kesalahan ini.
Pertanyaan yang Sering Diajukan
Berapa ukuran data supaya disebut big data?
Tidak ada angka resmi. Ukurannya adalah apakah satu mesin masih sanggup menyimpan dan mengolahnya tepat waktu. Data 2 TB yang dianalisis sebulan sekali bisa ditangani satu server. Data 200 GB per jam yang harus dianalisis seketika sudah membutuhkan sistem terdistribusi.
Di mana big data disimpan?
Big data disimpan di sistem terdistribusi seperti HDFS, object storage cloud (misalnya Amazon S3), database NoSQL, atau data warehouse cloud. Secara fisik, semuanya berada di ratusan sampai ribuan server di dalam data center.
Perilaku data yang berubah-ubah secara dinamis disebut apa?
Perilaku sumber data yang berkembang dinamis disebut variability, misalnya laju data yang melonjak saat promo atau format yang berganti. Istilah ini berbeda dari volatility, yang merujuk pada nilai data yang berubah seiring waktu.
Apa yang perlu dipelajari untuk mulai belajar big data?
Mulailah dari SQL untuk mengolah data terstruktur dan Python untuk analisis data. Setelah itu, pelajari konsep sistem terdistribusi dan satu alat pemrosesan seperti Spark. Dataset publik di Kaggle bisa menjadi bahan latihan gratis sebelum Anda menyentuh data sungguhan.
Kesimpulan
Big data adalah kumpulan data yang terlalu besar, cepat, atau beragam untuk ditangani satu mesin, sehingga harus diolah bersama oleh banyak server. Lima V (volume, velocity, variety, veracity, value) membantu mengenali cirinya, sedangkan variability menjelaskan kenapa sistemnya harus lentur mengikuti lonjakan.
Big data layak dipakai ketika pertanyaannya jelas dan satu server memang tidak lagi cukup. Selama data masih muat di satu mesin, database biasa tetap lebih murah dan sederhana.
Semoga artikel ini membantu.