Komputer tidak mengenal huruf. Setiap teks yang Anda ketik, mulai dari nama berkas hingga isi email, disimpan sebagai deretan angka biner. Agar angka itu bisa dibaca ulang sebagai huruf yang sama di komputer lain, kedua mesin harus memakai tabel terjemahan yang sama. Pada awal 1960-an, kesepakatan ini belum ada. Setiap pabrikan punya tabel sendiri, sehingga teks dari satu mesin bisa berubah menjadi simbol acak di mesin lain.
ASCII adalah standar pengodean karakter yang menjawab masalah tersebut. ASCII merupakan singkatan dari American Standard Code for Information Interchange, yang jika diterjemahkan kurang lebih berarti "Kode Standar Amerika untuk Pertukaran Informasi". Standar ini memberi nomor 0 sampai 127 untuk huruf Latin, angka, tanda baca, dan sejumlah perintah kontrol. Di artikel ini, kita akan membahas isi tabel kode ASCII dan logika bit di balik susunannya. Kita juga akan meluruskan salah kaprah yang sering beredar dan melihat tempat-tempat yang masih mewajibkan ASCII hari ini.
Apa Itu ASCII?
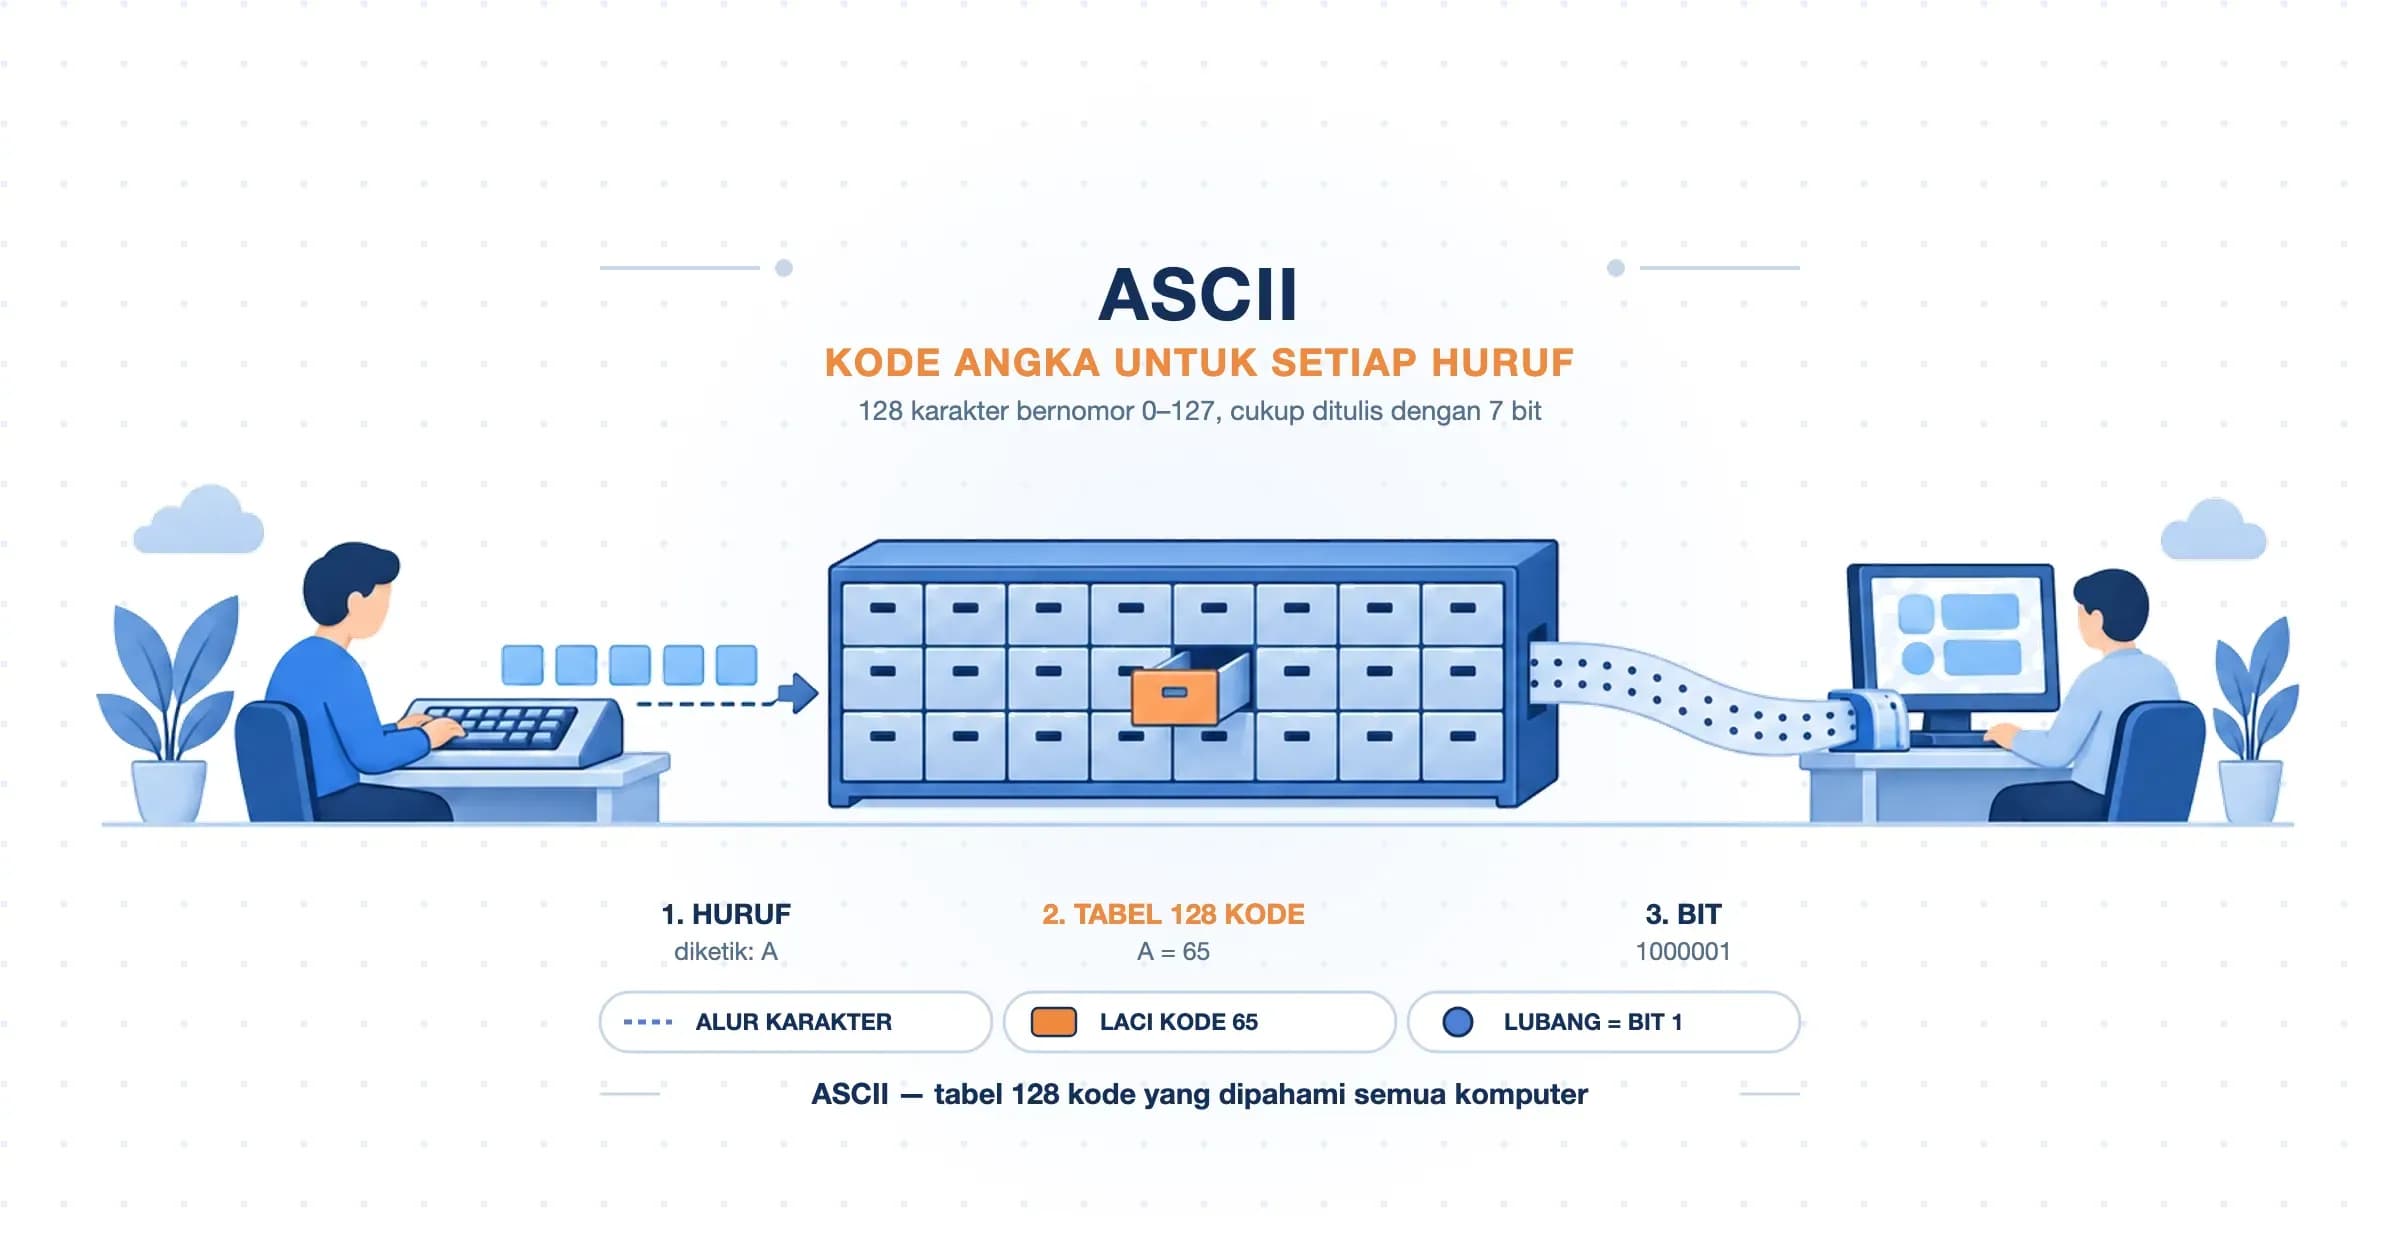
Secara pengertian, ASCII adalah standar yang digunakan untuk menerjemahkan huruf, angka, dan tanda baca menjadi bilangan agar bisa disimpan dan dipertukarkan antarperangkat. Wujudnya berupa tabel berisi 128 kode yang masing-masing mewakili satu karakter. Setiap kode cukup ditulis dengan 7 bit, karena 2 pangkat 7 sama dengan 128. Sebagai contoh, huruf "A" diwakili angka 65, huruf "a" diwakili angka 97, dan angka "0" diwakili kode 48. Proses menerjemahkan karakter menjadi angka seperti ini disebut encoding atau pengodean.
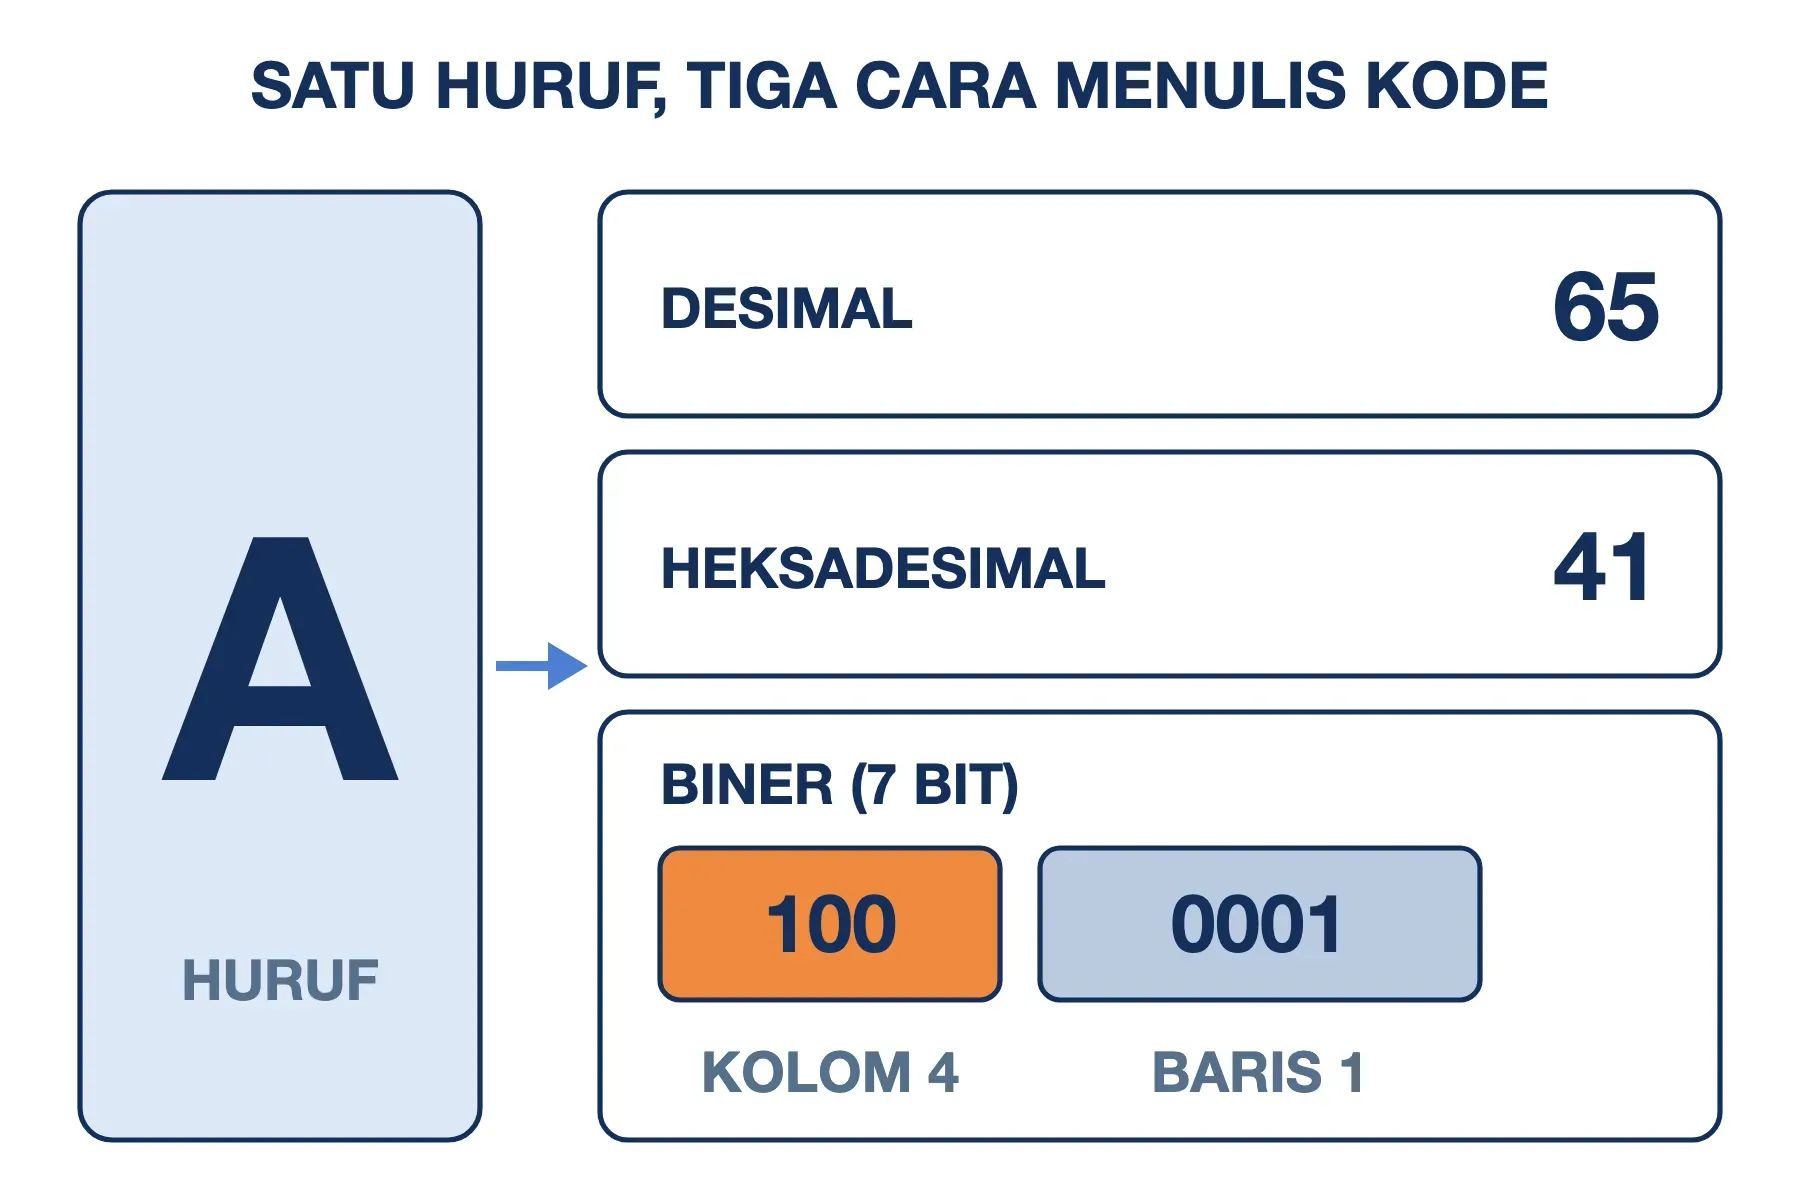
Jadi, yang dimaksud kode ASCII, atau sering juga disebut bilangan ASCII, adalah nomor urut sebuah karakter di dalam tabel tersebut. Nomor ini bisa ditulis dalam bentuk desimal (65), heksadesimal (41), maupun biner (1000001). Ketiganya merujuk ke huruf yang sama, hanya cara penulisannya yang berbeda.
Nama ASCII dibaca "as-ki". IANA (Internet Assigned Numbers Authority), lembaga yang mencatat nama standar di internet, mendaftarkannya dengan nama resmi US-ASCII. Nama inilah yang kadang Anda temui di header email atau deklarasi charset (himpunan karakter) pada berkas lama.
ASCII sering disebut sebagai fondasi teks digital. Alasannya sederhana: standar pengodean modern sengaja dirancang agar 128 kode pertamanya identik dengan ASCII. Yang dimaksud adalah Unicode (daftar induk karakter seluruh dunia) dan UTF-8 (cara Unicode disimpan dalam byte). Teks berbahasa Inggris yang ditulis pada 1970-an masih bisa dibaca utuh oleh browser hari ini tanpa konversi apa pun.
Dari Teleprinter ke Internet: Sejarah Singkat ASCII
ASCII lahir dari dunia teleprinter, yaitu mesin ketik yang mengirim teks lewat jalur telegraf. Pekerjaan standarnya berlangsung di subkomite X3.2 milik American Standards Association (ASA), lembaga yang kini bernama ANSI. Salah satu usulan awalnya diajukan oleh Bob Bemer, insinyur IBM, pada Mei 1961.
Berikut tonggak perkembangannya:
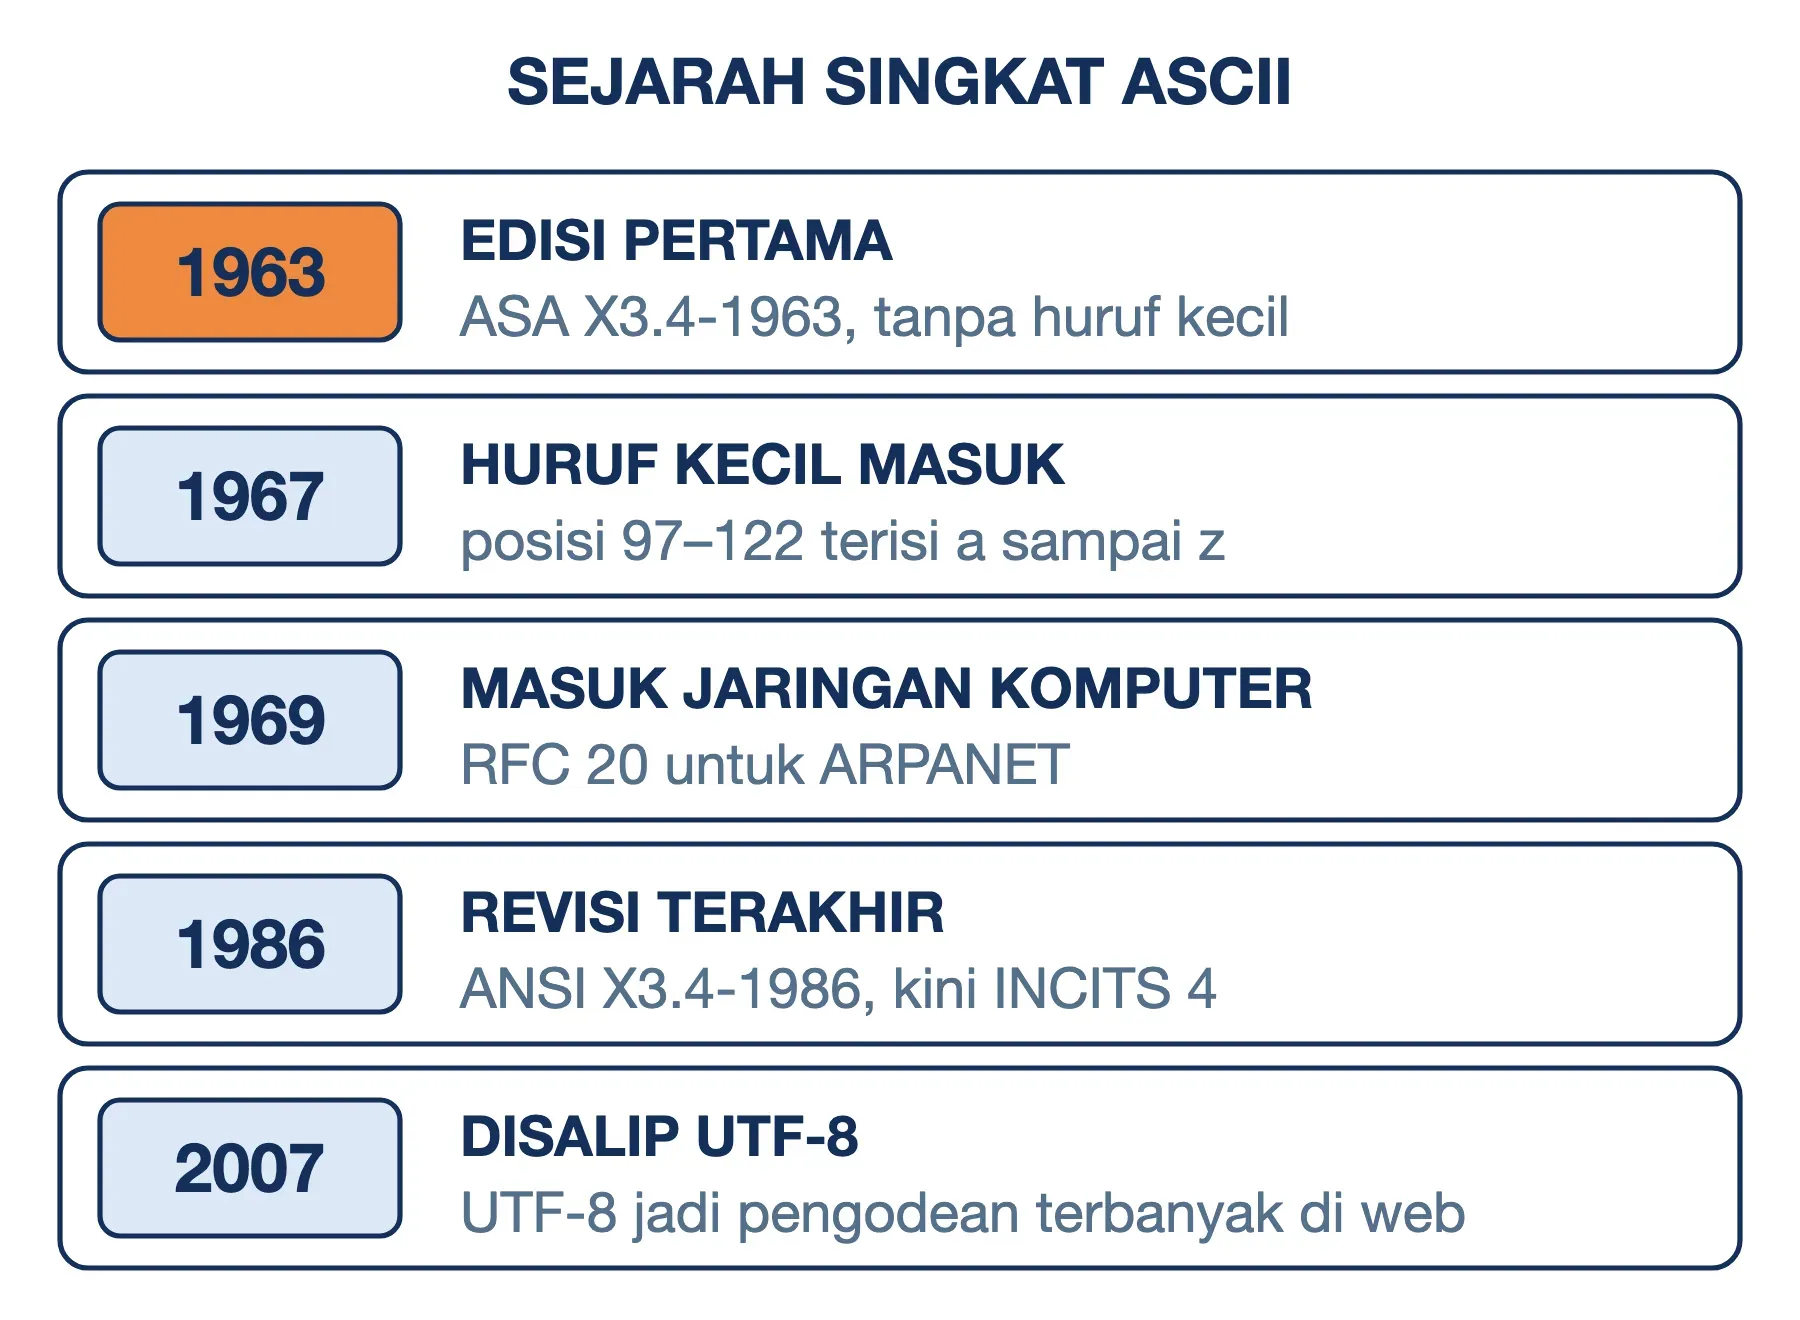
- 1963 — edisi pertama: ASA X3.4-1963 terbit bersamaan dengan Teletype Model 33. Edisi ini belum memuat huruf kecil, dan 28 posisi masih dibiarkan kosong.
- 1967 — huruf kecil masuk: revisi USAS X3.4-1967 menempatkan huruf kecil di posisi 97–122. Kurung kurawal dan garis tegak juga ditambahkan.
- 1969 — masuk ke jaringan komputer: RFC 20 yang ditulis Vint Cerf menetapkan ASCII sebagai format pertukaran teks di ARPANET, cikal bakal internet. Dokumen ini kini berstatus Internet Standard.
- 1986 — revisi terakhir: ANSI X3.4-1986 menjadi isi final standar ini. Sejak itu, isinya hanya ditegaskan ulang tanpa perubahan, terakhir sebagai INCITS 4-1986 (R2022).
- 2007 — disalip UTF-8: pada Desember 2007, UTF-8 menggantikan ASCII sebagai pengodean paling umum di web.
Asal-usul teleprinter inilah yang menjelaskan kenapa ASCII memuat perintah seperti "bunyikan bel" atau "kembalikan kepala cetak ke kiri". Perintah tersebut dulu menggerakkan komponen mekanis, dan sebagian masih kita pakai sampai sekarang.
Isi Tabel ASCII: 33 Karakter Kontrol dan 95 Karakter Cetak
Tabel ASCII terbagi menjadi dua kelompok besar. Kelompok pertama adalah 33 karakter kontrol, yaitu kode 0–31 ditambah kode 127, yang tidak tampil sebagai simbol. Kelompok kedua adalah 95 karakter cetak, yaitu kode 32–126, yang tampil di layar sebagai huruf, angka, tanda baca, atau spasi.
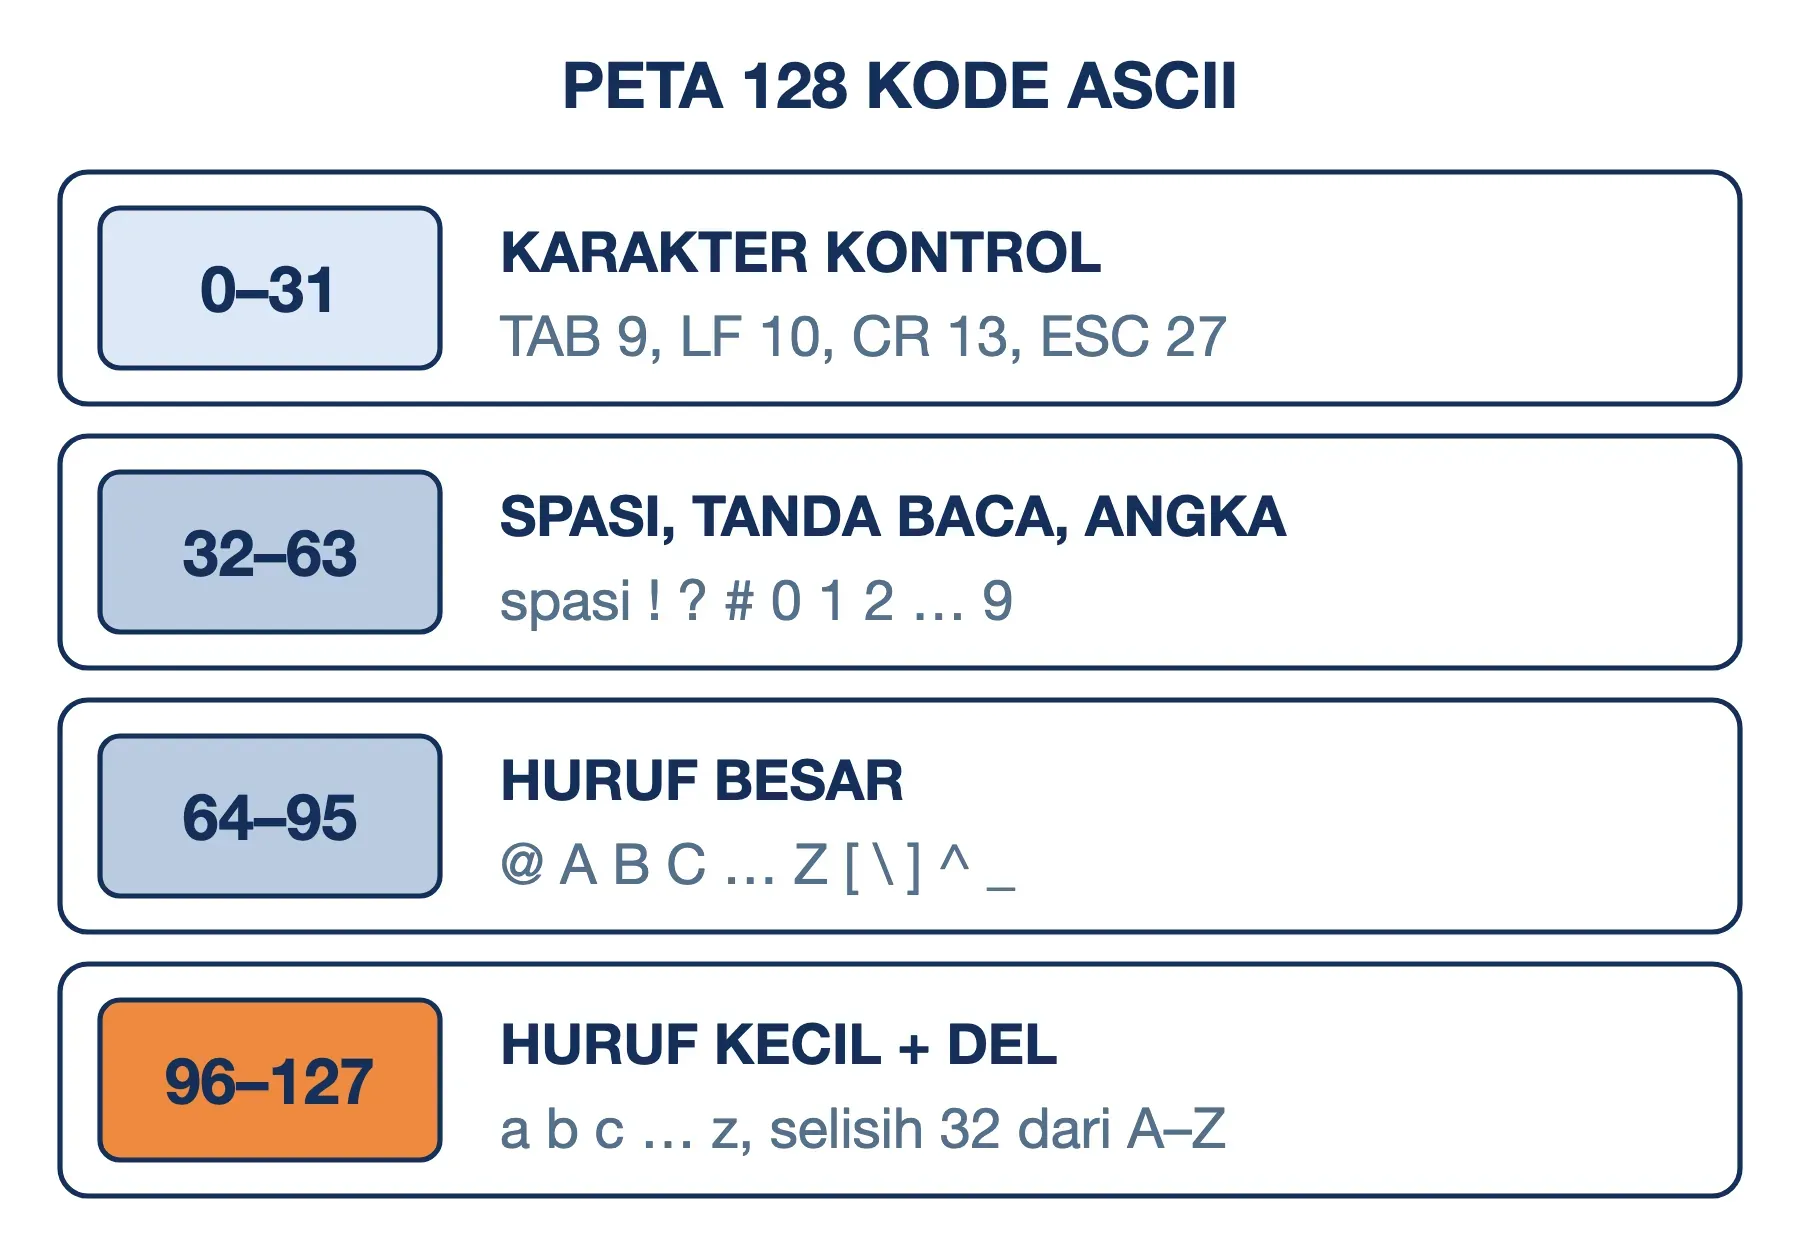
Dengan kata lain, karakter ASCII adalah salah satu dari 128 simbol atau perintah tersebut. Semua huruf, angka, dan tanda baca pada keyboard berbahasa Inggris standar termasuk di dalamnya. Sebaliknya, huruf beraksen seperti "é", simbol euro "€", atau emoji tidak termasuk.
Karakter Kontrol yang Masih Anda Temui
Sebagian besar karakter kontrol hanya relevan untuk mesin teleprinter dan kini jarang dipakai. Namun, delapan kode berikut masih muncul dalam pekerjaan sehari-hari seorang developer atau sysadmin:
| Kode | Nama | Fungsi hari ini |
|---|---|---|
| 0 | NUL | Penanda akhir string di bahasa C |
| 7 | BEL | Bunyi "beep" di terminal |
| 8 | BS | Mundur satu karakter (backspace) |
| 9 | HT | Tab horizontal |
| 10 | LF | Baris baru di Linux dan macOS |
| 13 | CR | Pasangan LF di Windows dan protokol internet |
| 27 | ESC | Awalan perintah warna dan kursor di terminal |
| 127 | DEL | Hapus; dikirim tombol Backspace di banyak terminal Linux |
Kode 10 dan 13 layak diperhatikan khusus. Perbedaan cara sistem operasi memakai keduanya adalah sumber galat yang sering ditemui, dan akan kita bahas di bagian tentang akhir baris.
Tabel Kode ASCII Lengkap 32–127
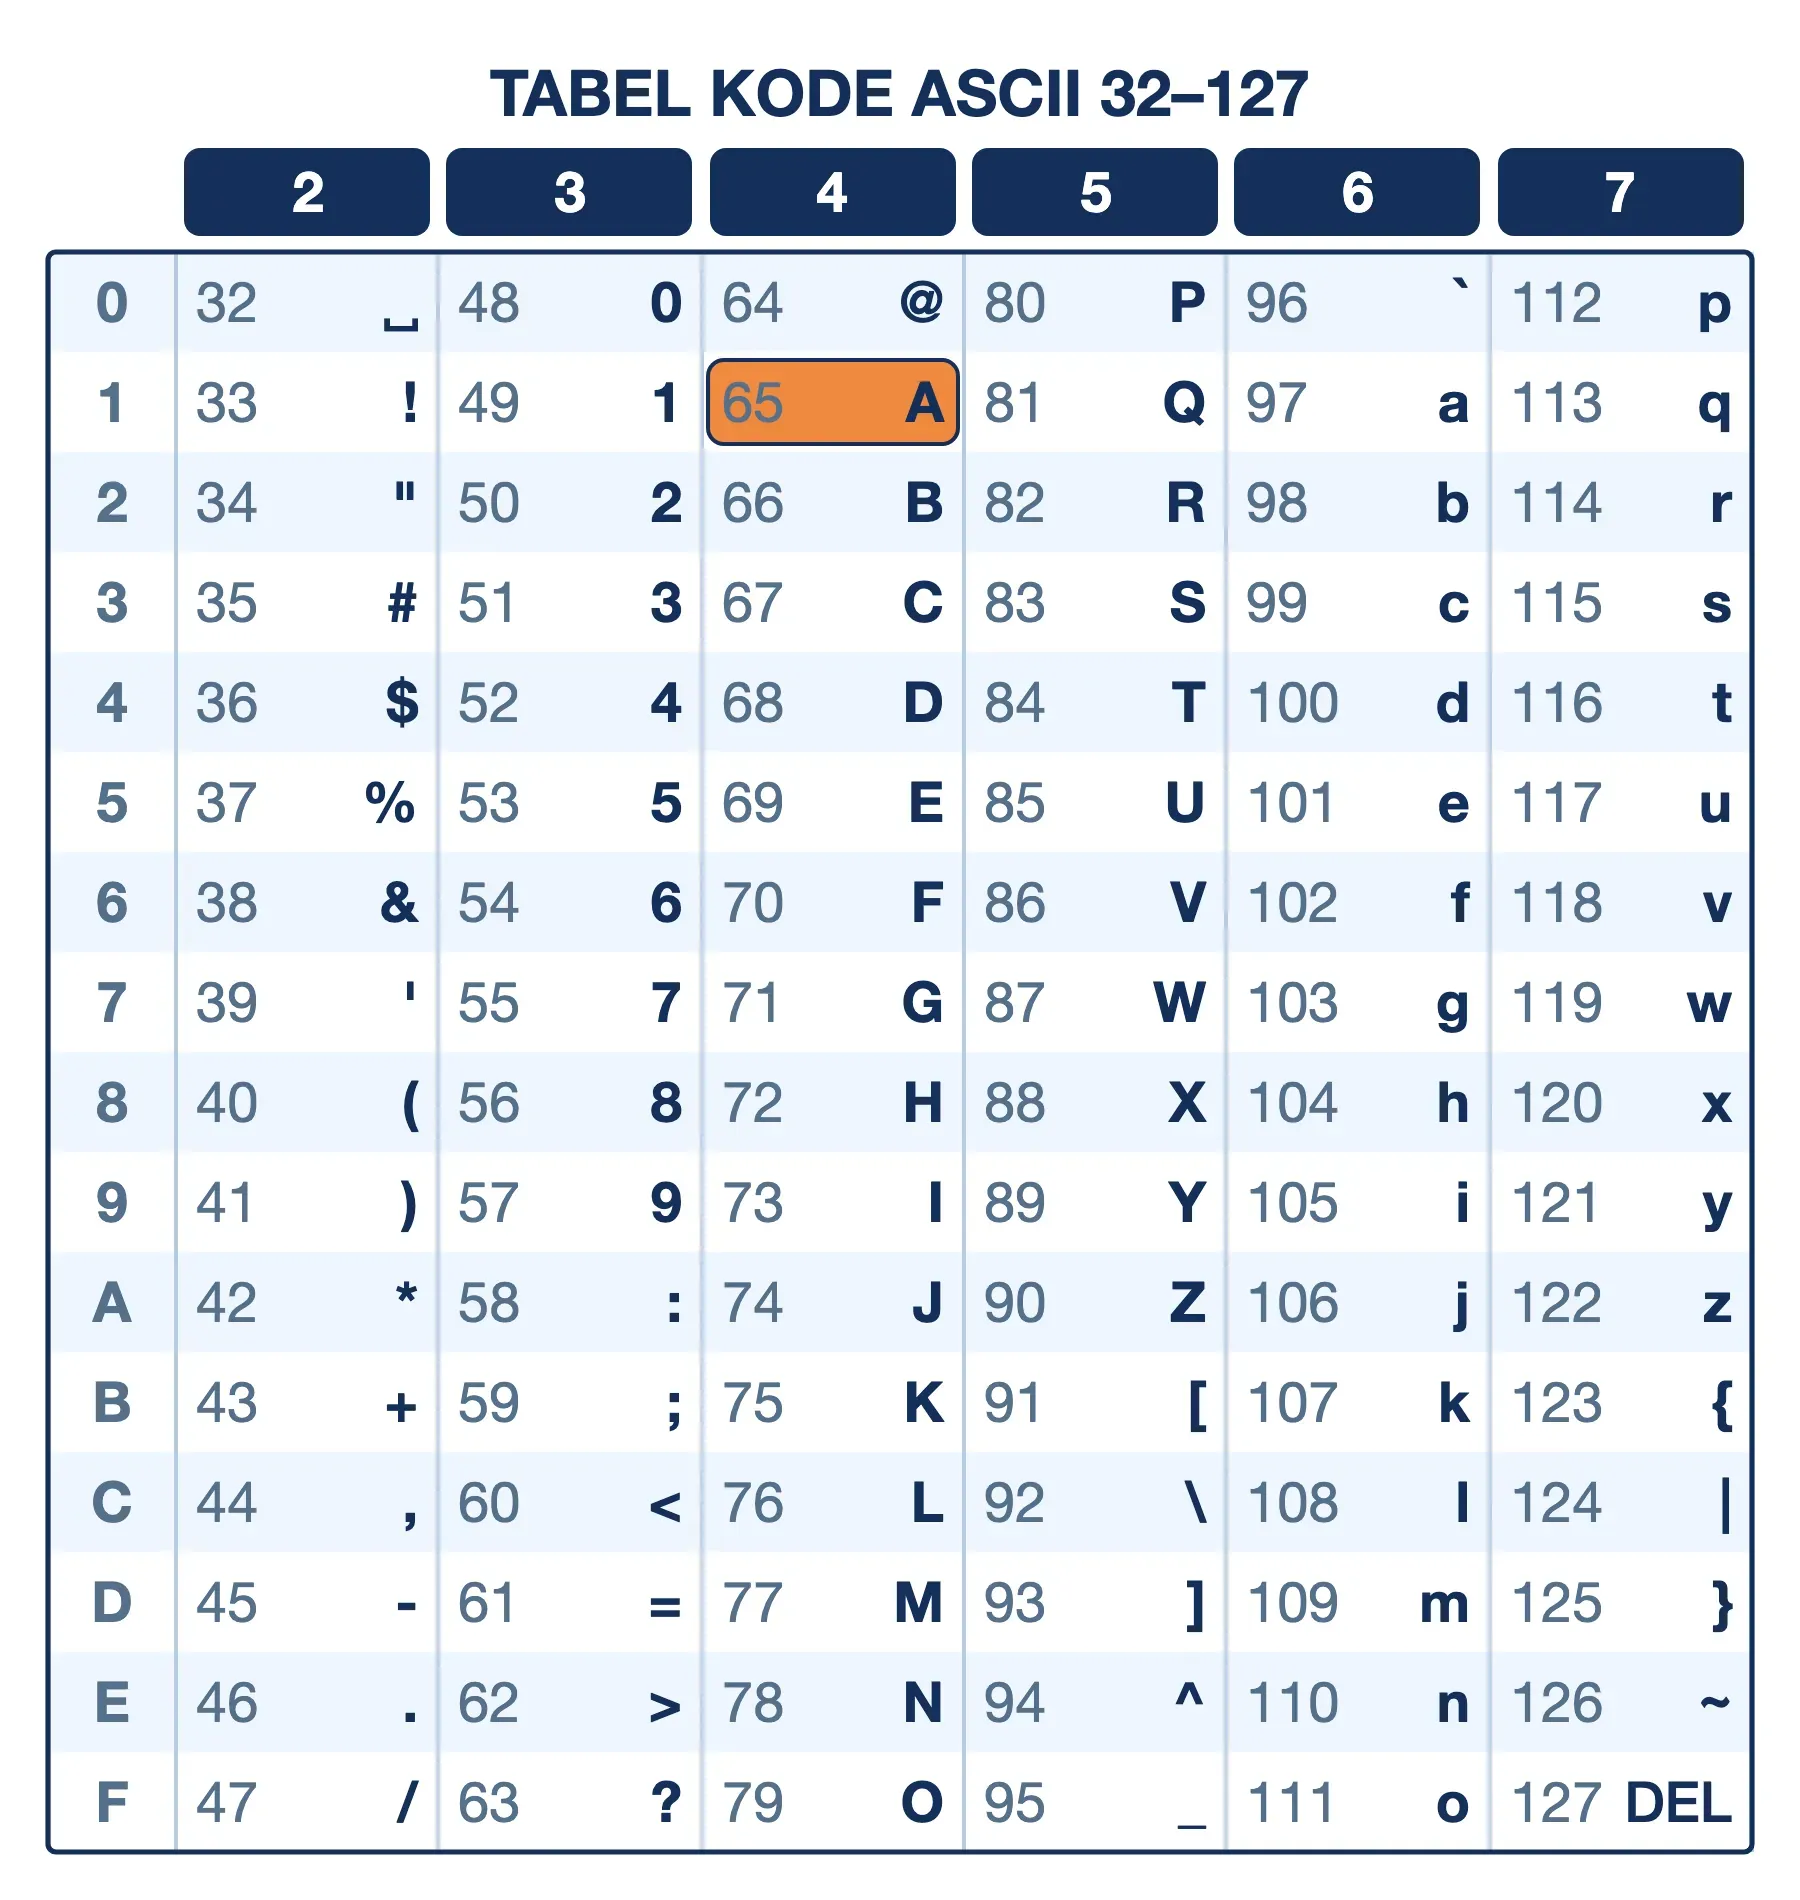
Tabel ASCII aslinya disusun dalam 8 kolom berisi 16 baris. Susunan inilah yang dipakai di bawah. Setiap sel memuat kode desimal diikuti karakternya. Kode heksadesimal didapat dengan menggabungkan nomor kolom dan nomor baris, misalnya huruf "A" ada di kolom 4 baris 1, sehingga kodenya 41 dalam heksadesimal.
Kolom 0 dan 1 berisi karakter kontrol, jadi tabel dimulai dari kolom 2.
Spasi, tanda baca, dan angka (kode 32–63)
| Baris | Kolom 2 | Kolom 3 |
|---|---|---|
| 0 | 32 spasi | 48 0 |
| 1 | 33 ! | 49 1 |
| 2 | 34 " | 50 2 |
| 3 | 35 # | 51 3 |
| 4 | 36 $ | 52 4 |
| 5 | 37 % | 53 5 |
| 6 | 38 & | 54 6 |
| 7 | 39 ' | 55 7 |
| 8 | 40 ( | 56 8 |
| 9 | 41 ) | 57 9 |
| A | 42 * | 58 : |
| B | 43 + | 59 ; |
| C | 44 , | 60 < |
| D | 45 - | 61 = |
| E | 46 . | 62 > |
| F | 47 / | 63 ? |
Huruf besar dan simbol (kode 64–95)
| Baris | Kolom 4 | Kolom 5 |
|---|---|---|
| 0 | 64 @ | 80 P |
| 1 | 65 A | 81 Q |
| 2 | 66 B | 82 R |
| 3 | 67 C | 83 S |
| 4 | 68 D | 84 T |
| 5 | 69 E | 85 U |
| 6 | 70 F | 86 V |
| 7 | 71 G | 87 W |
| 8 | 72 H | 88 X |
| 9 | 73 I | 89 Y |
| A | 74 J | 90 Z |
| B | 75 K | 91 [ |
| C | 76 L | 92 \ |
| D | 77 M | 93 ] |
| E | 78 N | 94 ^ |
| F | 79 O | 95 _ |
Huruf kecil dan simbol (kode 96–127)
| Baris | Kolom 6 | Kolom 7 |
|---|---|---|
| 0 | 96 ` | 112 p |
| 1 | 97 a | 113 q |
| 2 | 98 b | 114 r |
| 3 | 99 c | 115 s |
| 4 | 100 d | 116 t |
| 5 | 101 e | 117 u |
| 6 | 102 f | 118 v |
| 7 | 103 g | 119 w |
| 8 | 104 h | 120 x |
| 9 | 105 i | 121 y |
| A | 106 j | 122 z |
| B | 107 k | 123 { |
| C | 108 l | 124 | |
| D | 109 m | 125 } |
| E | 110 n | 126 ~ |
| F | 111 o | 127 DEL |
Perhatikan bahwa huruf "A" (65) dan "a" (97) berada di baris yang sama, hanya beda dua kolom. Ini bukan kebetulan, dan menjadi pintu masuk untuk memahami logika di balik tabel ini.
Logika Bit di Balik Tabel ASCII
Tabel ASCII tidak disusun asal urut. Komite perancangnya menata posisi setiap karakter agar pekerjaan umum seperti mengubah huruf besar ke kecil atau membaca angka cukup dilakukan dengan operasi bit sederhana. Begitu pola ini dipahami, Anda tidak perlu lagi menghafal tabel.
Kuncinya ada pada pembagian 7 bit menjadi dua bagian. Tiga bit teratas menentukan kolom (0–7), sedangkan empat bit terbawah menentukan baris (0–15). RFC 20 bahkan menuliskan posisi karakter dengan notasi "kolom/baris", misalnya huruf K di posisi 4/11.
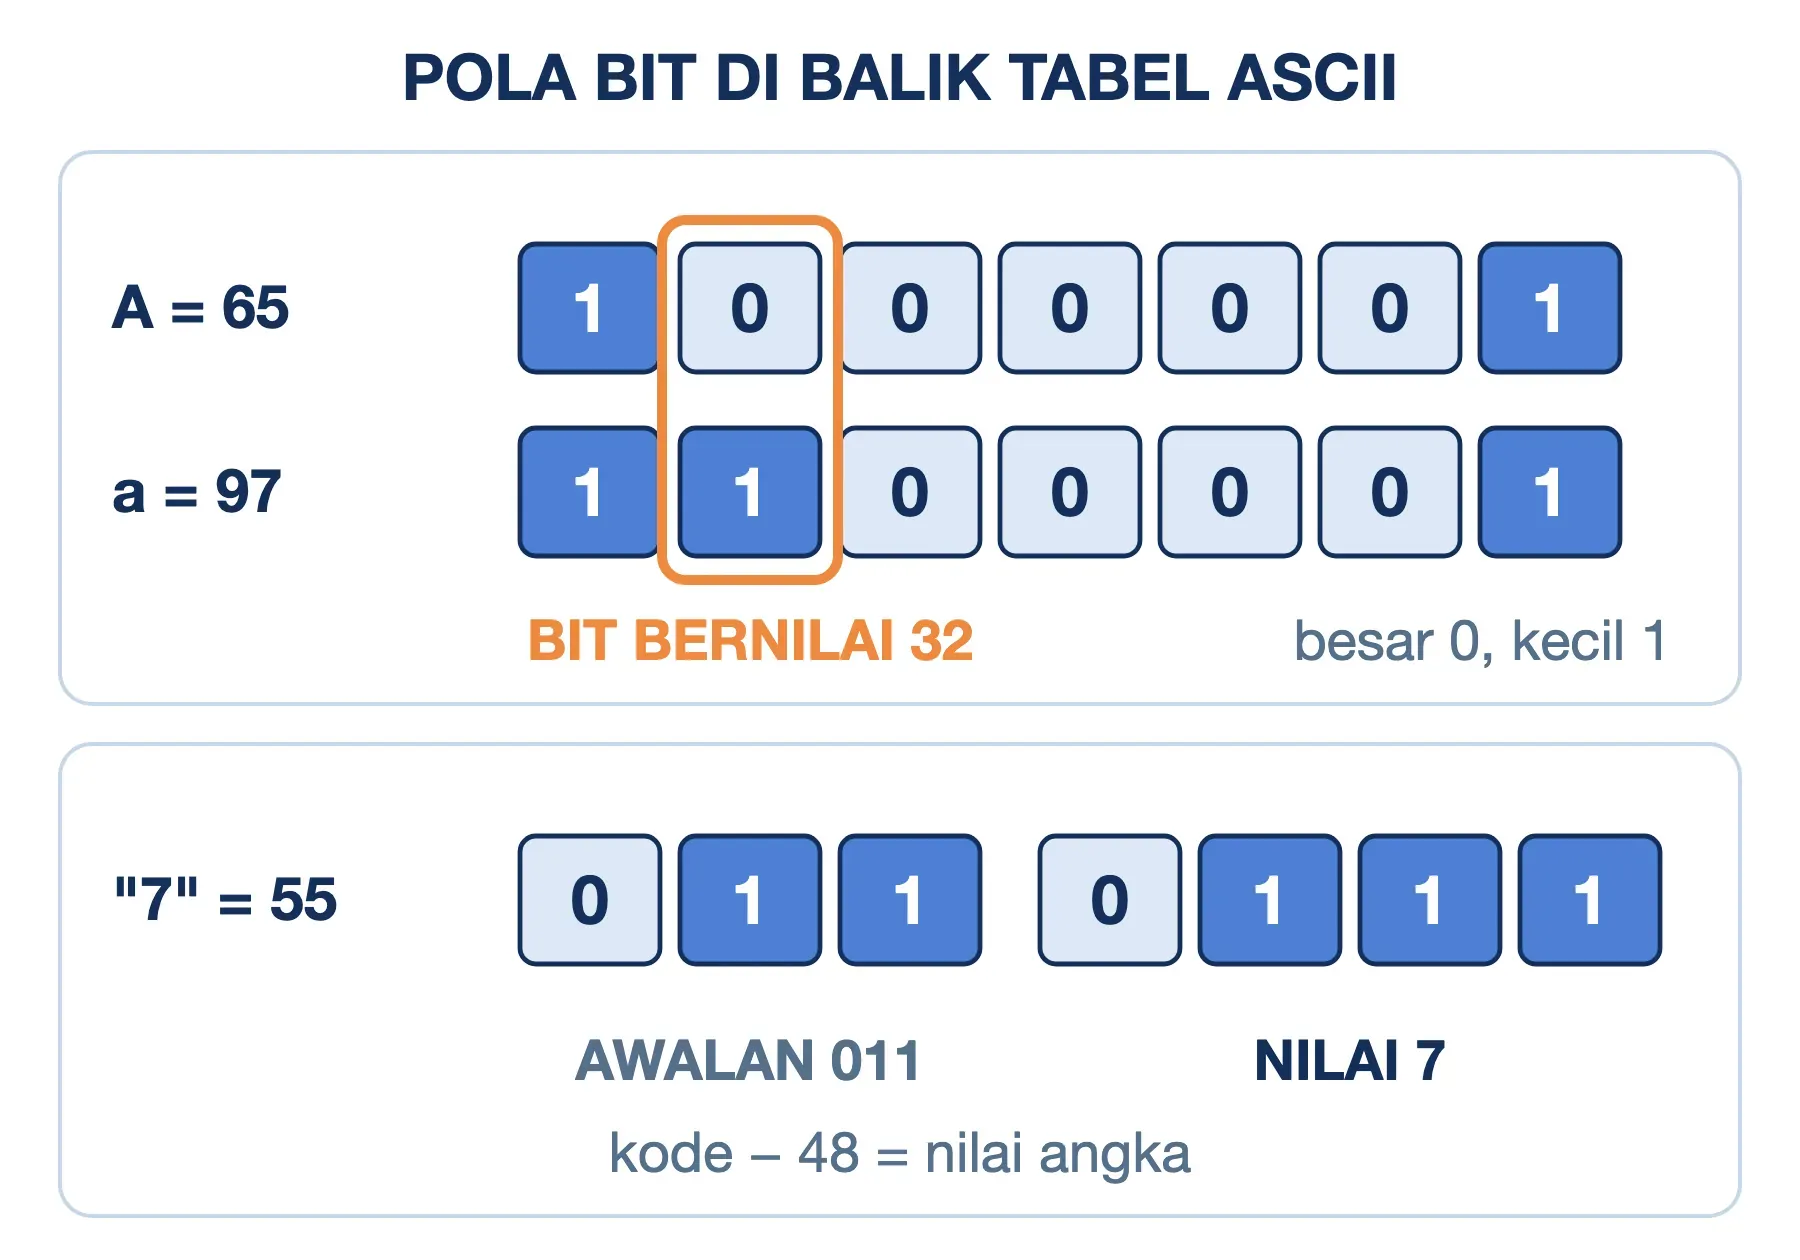
Huruf Besar dan Kecil Hanya Beda Satu Bit
Huruf "A" bernilai 1000001 dalam biner, sedangkan "a" bernilai 1100001. Satu-satunya perbedaan ada di bit keenam dari kanan, yang bernilai 32. Pola ini berlaku untuk semua huruf dari A sampai Z.
Akibatnya, mengubah huruf besar menjadi kecil cukup dengan menyalakan bit tersebut. Program lama memanfaatkan ini untuk pencocokan teks tanpa membedakan huruf besar-kecil dengan sangat murah. Perbedaan 32 ini juga menjadi akar sifat case sensitive di banyak sistem: bagi komputer, "A" dan "a" adalah dua angka berbeda.
Ada efek samping yang perlu diperhatikan. Karena seluruh huruf besar bernilai lebih kecil daripada huruf kecil, pengurutan berdasarkan kode ASCII menempatkan "Zebra" sebelum "apel". Itulah sebabnya daftar berkas di beberapa terminal tampak "salah urut" kalau namanya mencampur huruf besar dan kecil.
Angka 0–9 Menyimpan Nilainya Sendiri
Angka "0" sampai "9" berada di kode 48 sampai 57, atau 0110000 sampai 0111001 dalam biner. Tiga bit teratasnya selalu 011, sedangkan empat bit terbawahnya persis sama dengan nilai angka itu. Karakter "7", misalnya, bernilai 0110111, dan 0111 adalah 7 dalam biner.
Pola ini membuat konversi karakter angka ke nilai numerik menjadi sangat ringan. Cukup kurangi kodenya dengan 48, atau ambil empat bit terbawahnya. Fungsi seperti atoi() di bahasa C bekerja dengan prinsip ini.
Tombol Ctrl Mematikan Dua Bit Teratas
Kombinasi Ctrl+C yang menghentikan program di terminal juga mengikuti pola bit. Saat Ctrl ditekan bersama sebuah huruf, terminal mengirim kode huruf itu dengan dua bit teratasnya dimatikan, atau setara dengan operasi AND 31. Huruf "C" (67) berubah menjadi kode 3, yaitu ETX (End of Text).
Pola yang sama menghasilkan beberapa kombinasi yang familiar:
- Ctrl+C → kode 3 (ETX), dipakai terminal untuk menghentikan program.
- Ctrl+D → kode 4 (EOT, End of Transmission), penanda akhir input di shell Linux.
- Ctrl+H → kode 8 (BS), sama dengan backspace.
- Ctrl+M → kode 13 (CR), sama dengan Enter.
- Ctrl+[ → kode 27 (ESC), sama dengan tombol Escape.
Inilah asal notasi caret seperti ^C atau ^M yang sering muncul di terminal. Tanda ^ berarti "Ctrl", dan huruf di belakangnya menunjukkan karakter kontrol yang dimaksud.
DEL Bernilai 127 karena Pita Berlubang
Kode 127 adalah 1111111 dalam biner, artinya semua bit bernilai 1. Posisi ini dipilih karena kebutuhan pita kertas berlubang pada era teleprinter. Operator yang salah mengetik tidak bisa menambal lubang. Solusinya, semua lubang pada posisi itu dilubangi sekaligus, dan pembaca pita diatur untuk mengabaikan pola tersebut.
Contoh Kode ASCII: Mengubah "Hi!" ke Desimal, Heksadesimal, dan Biner
Mari terapkan semua pola di atas pada kata "Hi!". Huruf "H" ada di kolom 4 baris 8, huruf "i" di kolom 6 baris 9, dan tanda seru di kolom 2 baris 1.
| Karakter | Desimal (heks) | Biner (8 bit) |
|---|---|---|
| H | 72 (48) | 01001000 |
| i | 105 (69) | 01101001 |
| ! | 33 (21) | 00100001 |
Kolom biner di atas ditulis 8 bit, dengan satu angka 0 di depan. Bit tambahan ini ada karena komputer menyimpan data per byte (kelompok 8 bit), bukan karena ASCII memakai 8 bit. Detail inilah yang melahirkan salah kaprah berikutnya.
7 Bit atau 8 Bit? Meluruskan Salah Kaprah Extended ASCII
ASCII adalah standar 7 bit dengan tepat 128 karakter. Namun, banyak sumber, termasuk materi pelajaran, menyebut ASCII sebagai kode 8 bit dengan 256 karakter, lengkap dengan "tabel ASCII 8 bit". Anggapan itu muncul dari dua hal yang berbeda.
Pertama, soal ruang simpan. Komite perancang memilih 7 bit untuk menekan biaya transmisi data, yang saat itu dihitung per bit. Ketika komputer kemudian menyimpan data per byte, satu karakter ASCII menempati 8 bit dengan bit tertinggi selalu 0. RFC 20 menuliskannya secara eksplisit: ASCII 7 bit ditanam di dalam byte 8 bit. Pada jalur komunikasi lama, bit kedelapan itu juga dipakai sebagai parity bit (bit pemeriksa kesalahan).
Kedua, soal Extended ASCII. Setelah komputer pribadi populer, berbagai pabrikan memanfaatkan kode 128–255 yang kosong untuk karakter tambahan. Hasilnya sering disebut "ASCII 8 bit" atau "Extended ASCII", padahal ia bukan bagian dari standar ASCII. Lebih penting lagi, tidak ada satu tabel Extended ASCII yang berlaku umum.
Buktinya mudah diuji. Byte yang sama, yaitu kode 130, dibaca berbeda tergantung tabel yang dipakai:
| Tabel (code page) | Byte 130 dibaca sebagai |
|---|---|
| CP437 (IBM PC, DOS) | é |
| Windows-1252 | ‚ (tanda kutip bawah) |
| ISO-8859-1 | karakter kontrol tak tampak |
| UTF-8 | tidak sah jika berdiri sendiri |
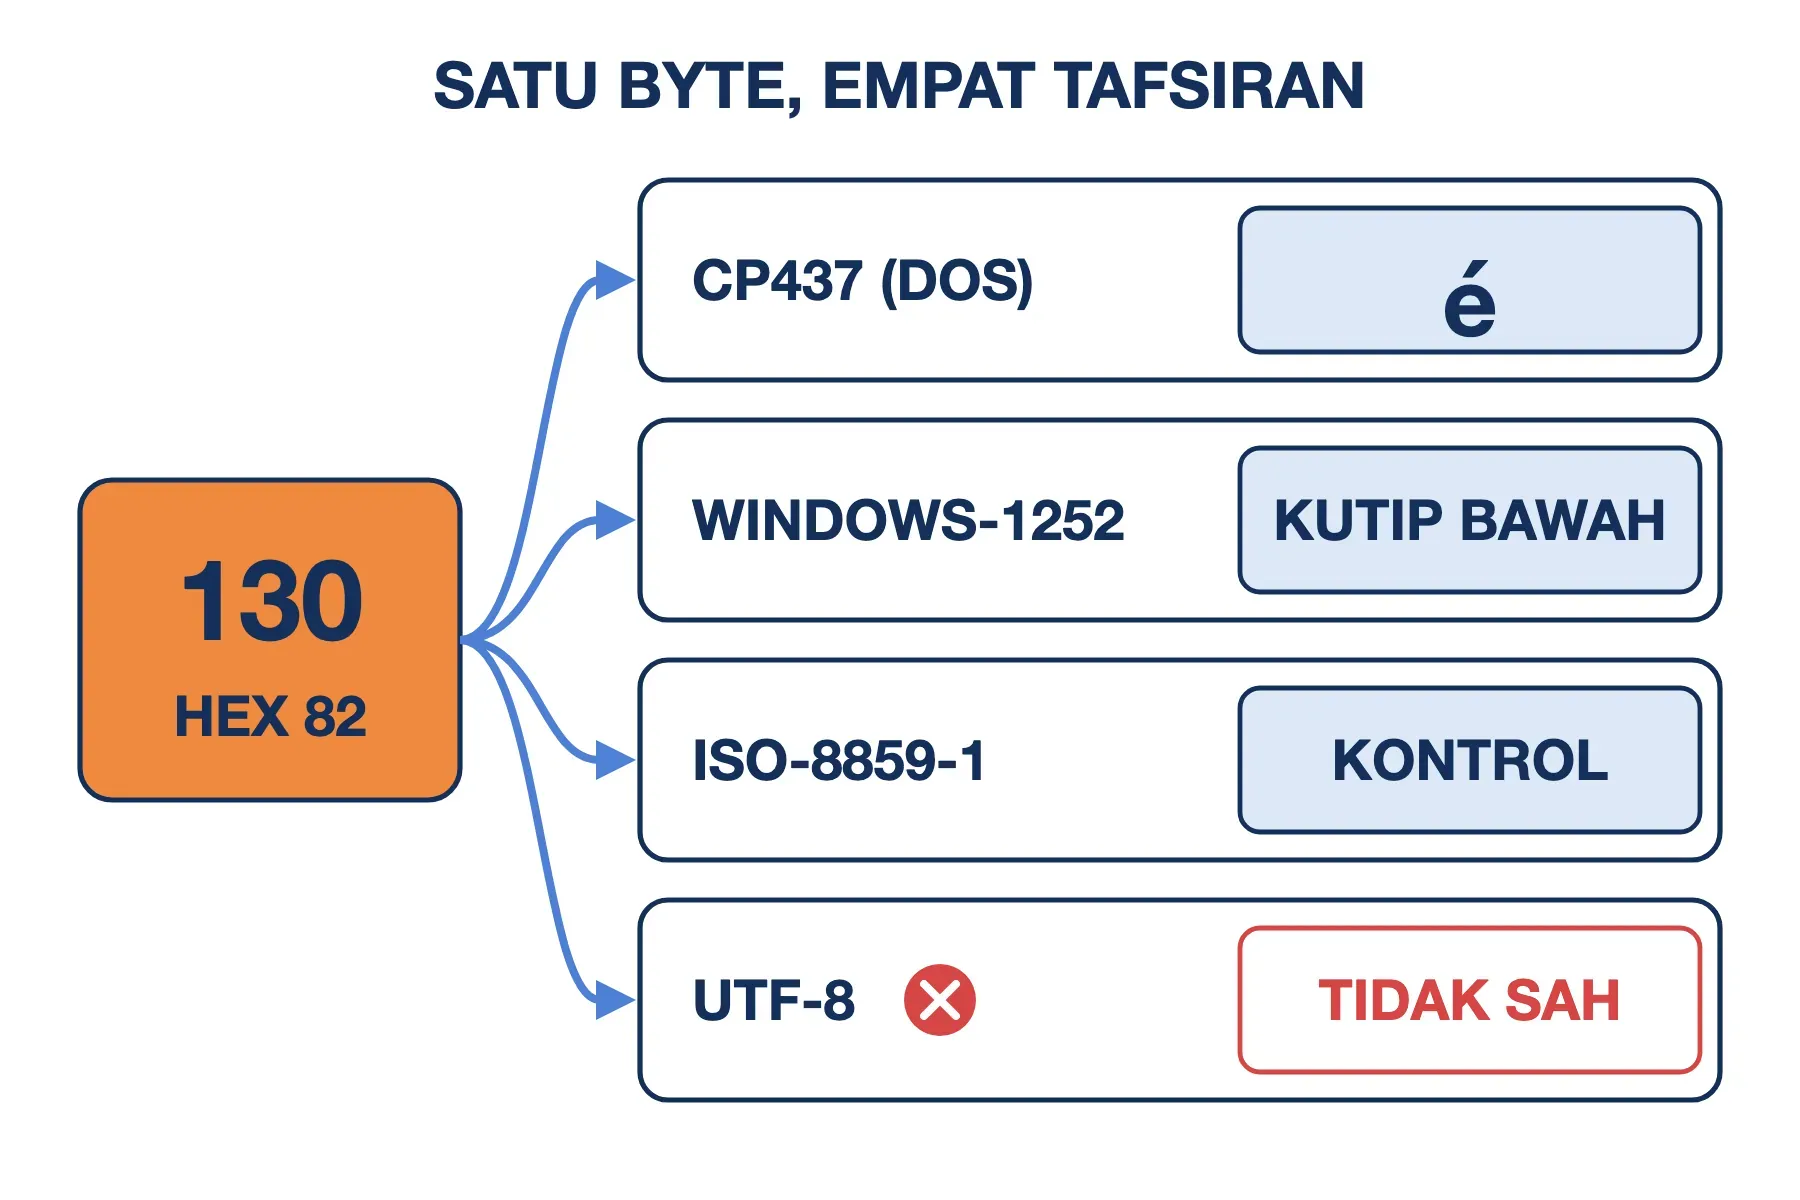
Sebaliknya, huruf "é" disimpan sebagai byte 130 di CP437, byte 233 di Windows-1252, dan dua byte 195 169 di UTF-8. Tabel bergrafis garis kotak yang sering dicantumkan sebagai "ASCII 128–255" sebenarnya adalah CP437 milik IBM PC. Tabel ini memakai kode 176–223 untuk potongan garis dan blok seperti ░ ║ ╔ █, yang dulu dipakai menggambar kotak dan menu di layar DOS. Jadi, setiap kali Anda menemukan kode di atas 127, tanyakan dulu tabel mana yang dimaksud.
Dari tabel CP437 inilah lahir rumusan yang sering muncul di soal ujian: kode 0–127 untuk memanipulasi teks dan kode 128–255 untuk memanipulasi grafik. Rumusan itu benar untuk IBM PC era DOS, tetapi bukan isi standar ASCII. Dalam standar aslinya, seluruh 128 kode dipakai untuk teks dan perintah kontrol, tanpa satu pun kode grafik.
Perbedaan ASCII dan Unicode
Keterbatasan 128 karakter membuat ASCII tidak cukup untuk dunia yang memakai ratusan aksara. Unicode hadir sebagai daftar induk yang memberi nomor unik untuk setiap karakter di semua bahasa. Unicode 18.0 yang dirilis September 2026 sudah memuat 172.808 karakter.
Hubungan keduanya bersifat menyatu, bukan bersaing. Nomor 0 sampai 127 di Unicode sengaja dibuat sama persis dengan ASCII. Ketika nomor Unicode disimpan dengan UTF-8, karakter ASCII tetap menempati satu byte dengan nilai yang sama. Artinya, setiap berkas ASCII murni otomatis juga berkas UTF-8 yang sah.
| Aspek | ASCII | Unicode (UTF-8) |
|---|---|---|
| Jumlah karakter | 128 | 172.808 (versi 18.0) |
| Ukuran per karakter | 1 byte | 1–4 byte |
| Bahasa | Inggris tanpa aksen | Hampir semua aksara, plus emoji |
| Kompatibilitas | — | 128 kode awal sama dengan ASCII |
Rincian cara UTF-8 menyusun byte, serta penyebab teks berubah menjadi simbol aneh, sudah kami bahas di artikel tentang encoding. Untuk konteks ASCII, cukup diingat satu hal: Unicode memperluas ASCII, bukan menggantikannya.
Di Mana ASCII Masih Wajib Dipakai Hari Ini
Menurut W3Techs per 24 Oktober 2026, 99,1% website memakai UTF-8, sedangkan US-ASCII dipakai kurang dari 0,1%. Angka ini mudah disalahartikan seolah ASCII sudah tidak relevan. Kenyataannya, sejumlah protokol inti internet masih mensyaratkan ASCII di bagian tertentu. Developer yang tidak memahami batas ini biasanya baru menyadarinya saat sistem menolak data.
Header Email
RFC 5322, standar format pesan email, menetapkan bahwa pesan terdiri dari karakter US-ASCII bernilai 1 sampai 127. Nama header seperti Subject atau From hanya boleh memakai karakter cetak 33–126, kecuali titik dua. Panjang setiap baris dibatasi 998 karakter, dan disarankan tidak lebih dari 78.
Lalu bagaimana subjek email berbahasa Indonesia dengan huruf beraksen bisa terkirim? Klien email mengubahnya dulu menjadi bentuk ASCII seperti =?UTF-8?B?...?=, yang berisi teks UTF-8 yang sudah di-Base64-kan. Server pengirim yang berbicara lewat SMTP kini juga bisa menawarkan ekstensi SMTPUTF8 untuk alamat non-ASCII. Namun, dukungan ekstensi ini tidak merata di semua server penerima.
Nama Domain dan Punycode
Nama host yang dicari lewat DNS hanya boleh memakai huruf a–z, angka, dan tanda hubung dari tabel ASCII. Domain yang memuat huruf non-ASCII, misalnya kafé.id, harus diterjemahkan dulu ke format bernama Punycode. Hasilnya diawali xn--, sehingga kafé.id menjadi xn--kaf-dma.id.
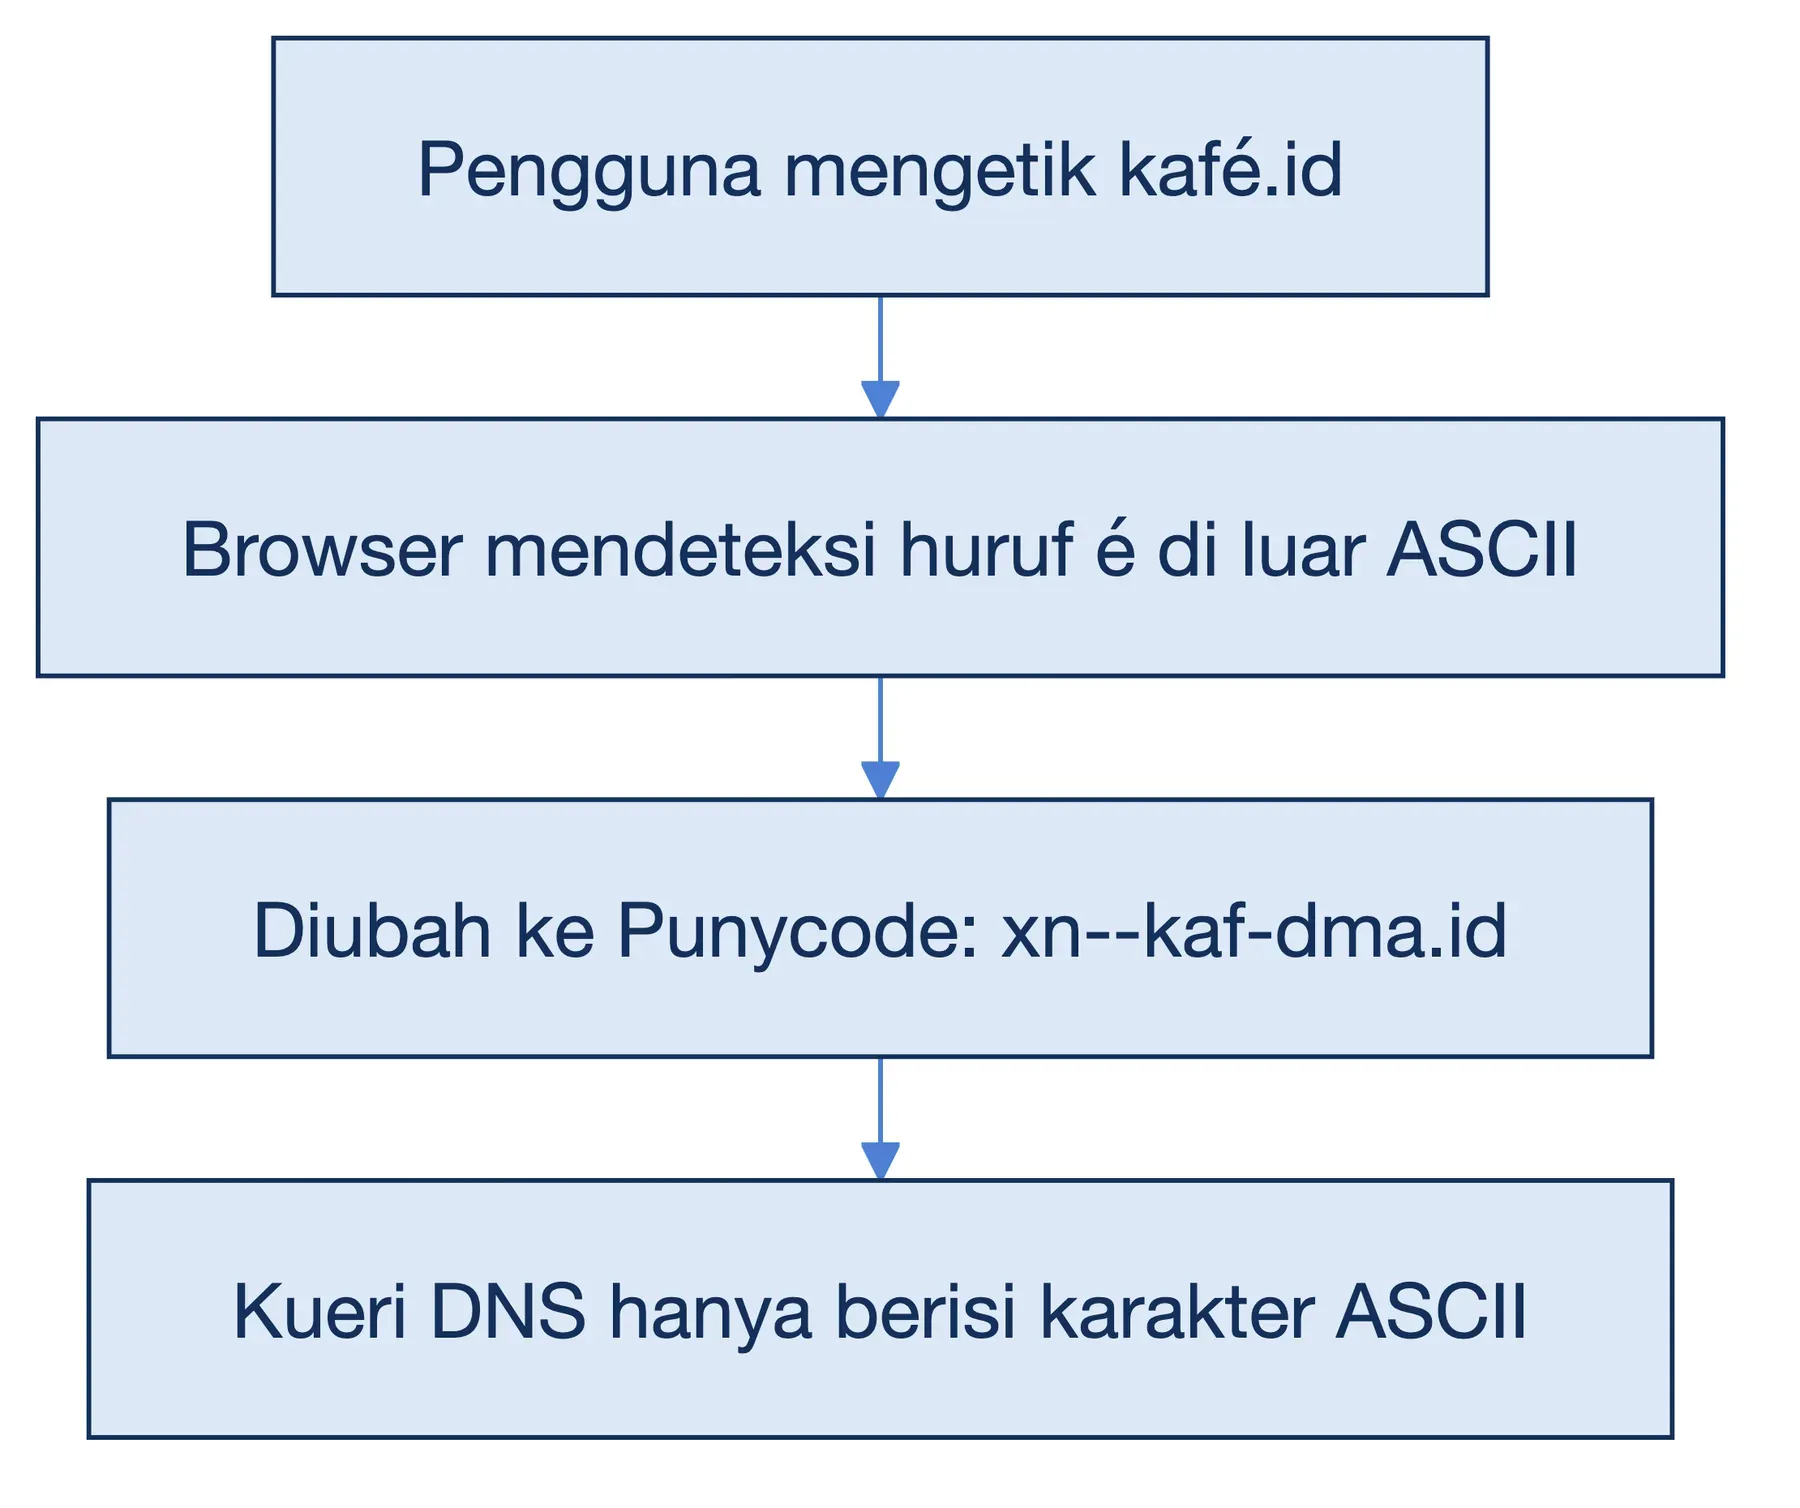
Batas ini punya sisi keamanan. Huruf "а" dari aksara Kiril (U+0430) tampak identik dengan huruf "a" Latin, tetapi kodenya berbeda. Penyerang bisa mendaftarkan domain kembar yang sekilas mirip domain bank. Karena itu, browser modern menampilkan bentuk xn-- untuk domain yang mencampur aksara secara mencurigakan.
Akhir Baris: CR, LF, dan Galat ^M
Ingat kode 13 (CR) dan 10 (LF) dari tabel kontrol tadi? Linux dan macOS mengakhiri setiap baris dengan LF saja. Windows memakai pasangan CR LF, warisan teleprinter yang perlu dua gerakan: kembalikan kepala cetak ke kiri, lalu gulung kertas satu baris. Protokol internet seperti HTTP/1.1 dan SMTP juga memakai CR LF sebagai pemisah baris.
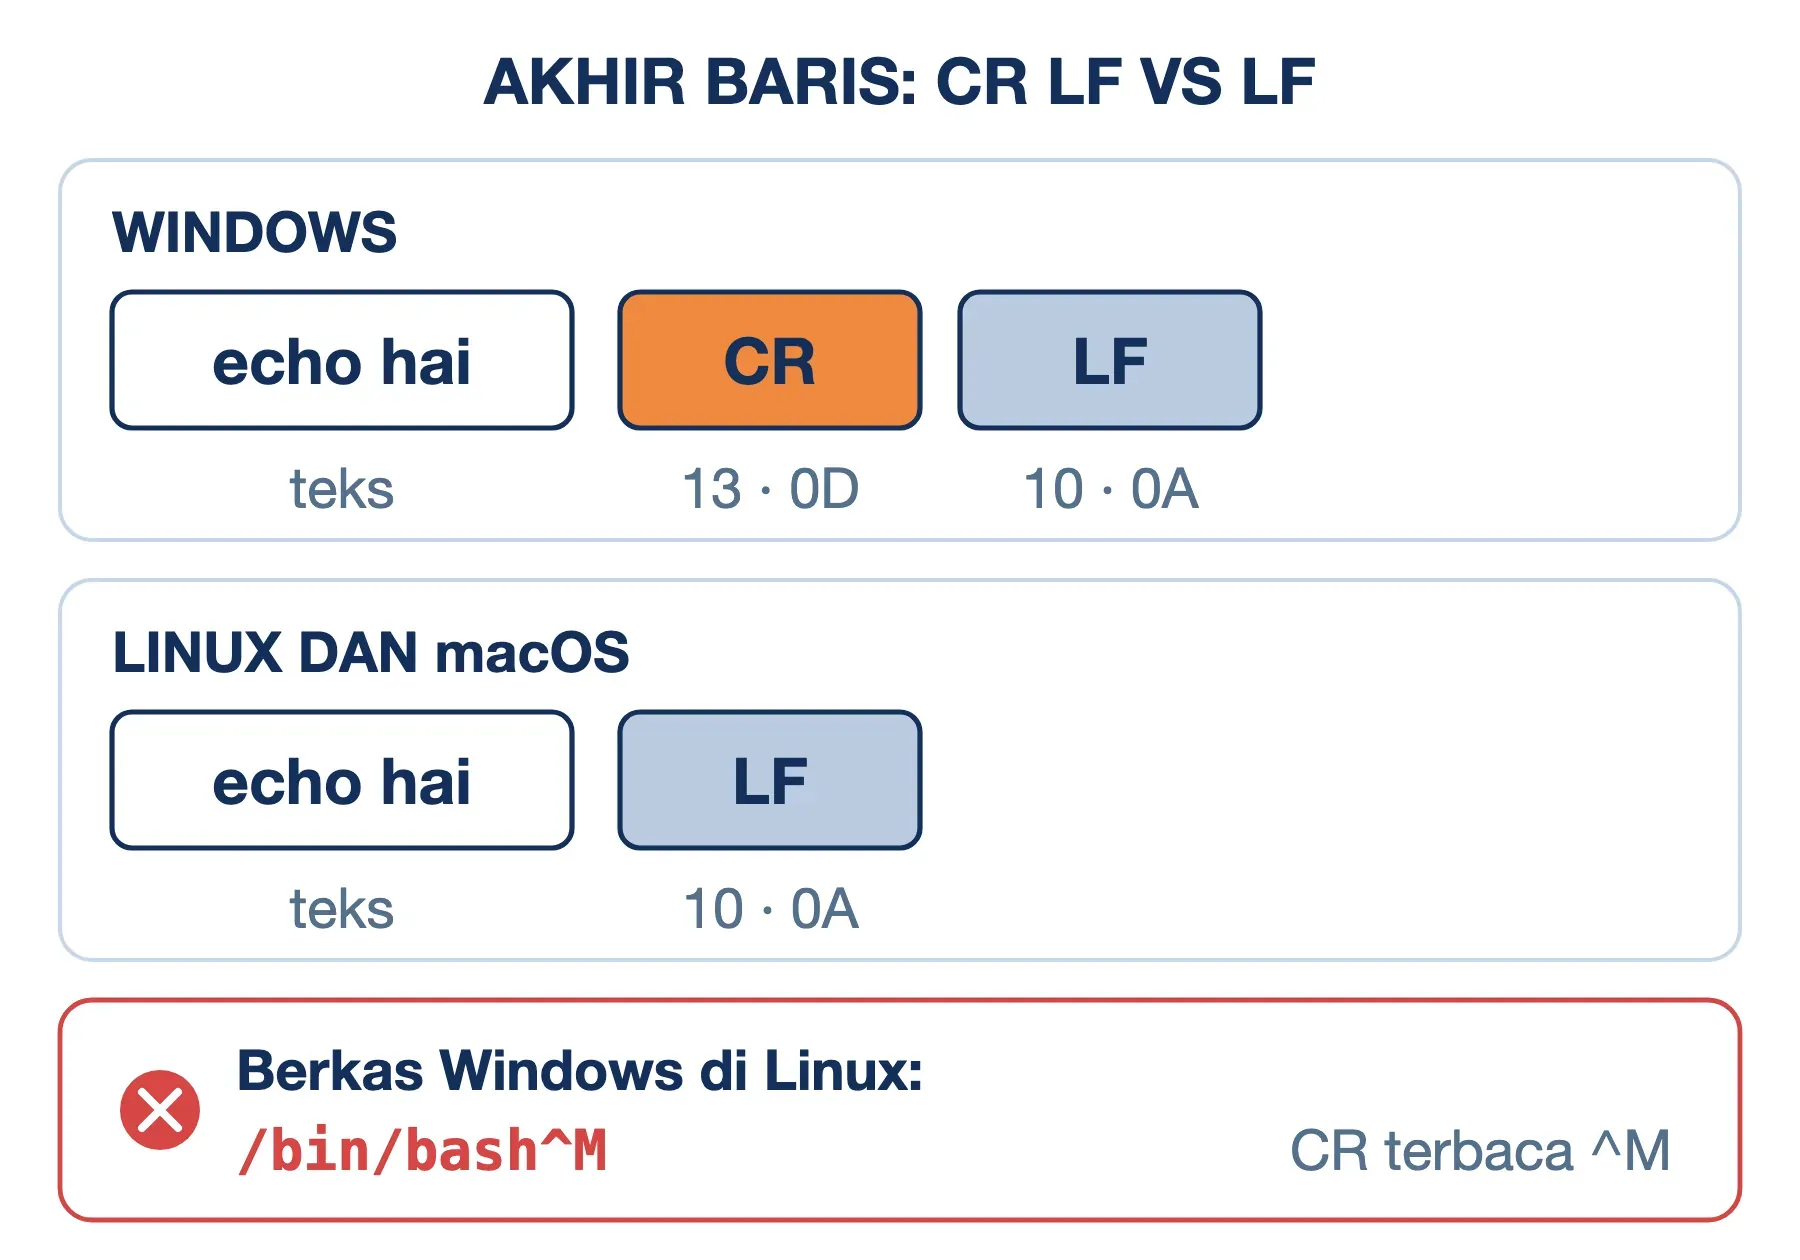
Perbedaan ini sering memunculkan galat saat skrip ditulis di Windows lalu dijalankan di server Linux. Shell membaca karakter CR sebagai bagian dari nama interpreter, sehingga muncul pesan seperti berikut:
bad interpreter: /bin/bash^M: no such file or directoryTanda ^M adalah notasi caret untuk kode 13, persis seperti pola Ctrl yang dibahas sebelumnya. Solusinya adalah mengubah akhir baris ke LF, misalnya dengan perintah dos2unix atau pengaturan "LF" di editor kode. Masalah ini juga alasan protokol FTP punya mode transfer ASCII, yang menyesuaikan akhir baris secara otomatis. Kalau Anda rutin menulis bash script dari Windows, aturlah editor ke LF sejak awal.
Kelebihan ASCII
Meski usianya lebih dari enam dekade, ASCII masih punya keunggulan yang membuatnya dipilih secara sengaja untuk data tertentu:
- Kompatibel ke depan dan ke belakang: teks ASCII sah di UTF-8, Windows-1252, ISO-8859-1, dan hampir semua pengodean lain. Data yang dibatasi ke ASCII hampir tidak mungkin rusak karena salah membaca encoding.
- Satu karakter sama dengan satu byte: panjang teks dalam karakter sama dengan ukurannya dalam byte. Memotong string di posisi mana pun tidak akan membelah satu karakter menjadi dua, berbeda dengan UTF-8.
- Mudah divalidasi: memeriksa apakah sebuah teks murni ASCII cukup dengan memastikan setiap byte bernilai di bawah 128. Aturan ini sederhana dan tidak bergantung pada pustaka khusus.
- Aman melewati sistem lama: perangkat jaringan, mesin kasir, firmware, dan sistem perbankan lawas umumnya pasti mengenali ASCII. Karena itu, format seperti Base64 dan PEM sengaja mengubah data biner, misalnya sertifikat atau lampiran, menjadi teks ASCII sebelum dikirim.
Kelemahan dan Pertimbangan ASCII
ASCII dirancang untuk bahasa Inggris Amerika pada 1960-an, dan batasan itu terasa jelas di konteks Indonesia maupun global. Ada beberapa hal yang perlu Anda pertimbangkan sebelum mengandalkannya:
- Hanya bahasa Inggris tanpa aksen: nama seperti "José", aksara Jawa, huruf Arab, dan emoji tidak bisa ditulis. Simbol yang tampak umum seperti ², €, dan tanda kutip melengkung pun tidak ada di tabel.
- Pernah punya varian nasional: standar internasional ISO 646 mengizinkan negara mengganti beberapa simbol. Di Jepang dan Korea, posisi backslash (92) masih sering tampil sebagai ¥ atau ₩, sehingga path
C:\Usersterlihat sepertiC:¥Users. - Fungsi bernama ASCII bisa memberi angka menyesatkan: dokumentasi Microsoft mencontohkan
ASCII('æ')di SQL Server menghasilkan 195, padahal nomor Unicode huruf itu 230. Angka 195 sebenarnya byte pertama dari bentuk UTF-8-nya. - Validasi "hanya ASCII" bisa menolak data yang sah: formulir yang membatasi nama ke ASCII akan menolak pelanggan bernama "Zoë". Alamat yang disalin dari aplikasi pengolah kata juga bisa ditolak karena tanda kutipnya. Pembatasan seperti ini memindahkan masalah ke pengguna.
Poin terakhir sering menjadi sumber keluhan "validasi ASCII gagal" di formulir online. Penyebabnya hampir selalu karakter tak kasatmata yang ikut tersalin, dan cara menemukannya kita bahas di langkah berikut.
Cara Mengecek dan Mengonversi Kode ASCII
Bagian ini berisi langkah praktis yang bisa langsung Anda jalankan. Contoh memakai Python 3 karena tersedia di hampir semua server Linux dan macOS. Kami mengujinya pada Python 3.9 di macOS.
Langkah #1: Melihat Kode ASCII Sebuah Karakter
Fungsi ord() mengubah karakter menjadi kodenya, sedangkan chr() melakukan kebalikannya. Untuk menampilkan bentuk heksadesimal dan biner, gunakan hex() dan format():
teks = "Hi!"
print([ord(c) for c in teks])
print([hex(ord(c)) for c in teks])
print([format(ord(c), "08b") for c in teks])
print("".join(chr(n) for n in [73, 110, 100, 111]))
Hasilnya adalah [72, 105, 33], ['0x48', '0x69', '0x21'], ['01001000', '01101001', '00100001'], lalu kata Indo. Angka ini cocok dengan tabel "Hi!" di bagian sebelumnya.
Langkah #2: Menguji Apakah Teks Murni ASCII
Sejak Python 3.7, string punya metode isascii() yang mengembalikan True jika semua karakternya berkode di bawah 128. Cara lain adalah mencoba mengodekan teks ke ASCII:
print("Kafe".isascii())
print("Kafé".isascii())
"Kafé".encode("ascii")
Dua baris pertama mencetak True lalu False. Baris ketiga memunculkan galat UnicodeEncodeError: 'ascii' codec can't encode character '\xe9' in position 3: ordinal not in range(128). Pesan "ordinal not in range(128)" adalah tanda pasti bahwa ada karakter di luar tabel ASCII, dan posisinya ikut disebutkan.
Langkah #3: Menemukan Karakter Non-ASCII Tersembunyi
Galat validasi ASCII sering disebabkan karakter yang tidak terlihat berbeda di layar. Pelaku paling umum adalah tanda kutip melengkung (U+201C dan U+201D) hasil koreksi otomatis pengolah kata, spasi tak terputus (U+00A0), dan tanda pisah panjang (U+2013). Teks "Harga “promo” Rp50.000 – terbatas" terlihat wajar, tetapi memuat empat karakter non-ASCII.
Simpan skrip berikut sebagai cek_ascii.py. Skrip ini menampilkan nomor baris, kolom, dan kode Unicode setiap karakter non-ASCII di sebuah berkas:
import sys

teks = open(sys.argv[1], encoding="utf-8").read()
for no, baris in enumerate(teks.splitlines(), 1):
    for kol, ch in enumerate(baris, 1):
        if not ch.isascii():
            kode = f"U+{ord(ch):04X}"
            print(no, kol, repr(ch), kode)
Jalankan dengan python3 cek_ascii.py data.txt. Setiap baris keluaran berisi nomor baris, nomor kolom, karakter, dan kode Unicode-nya. Pada berkas uji kami, hasilnya antara lain 2 8 '“' U+201C (tanda kutip melengkung) dan 2 15 '\xa0' U+00A0 (spasi tak terputus). Di server Linux dengan GNU grep, pencarian cepat juga bisa dilakukan dengan grep -nP '[^\x00-\x7F]' data.txt.
Langkah #4: Memakai Fungsi ASCII() di Database
Fungsi ASCII() di MySQL dan SQL Server mengembalikan kode karakter paling kiri dari sebuah string. Contohnya, SELECT ASCII('A'); menghasilkan 65. Menurut dokumentasi MySQL, string kosong menghasilkan 0 dan NULL menghasilkan NULL.
Fungsi ini hanya akurat untuk karakter ASCII. Untuk karakter multibyte, MySQL menyediakan ORD(), sedangkan SQL Server menyediakan UNICODE() yang mengembalikan nomor Unicode yang benar. Kalau kolom Anda memakai utf8mb4, biasakan memakai fungsi tersebut agar hasil query SQL tidak menyesatkan.
Langkah #5: Mengetik Karakter Lewat Alt Code di Windows
Windows mengizinkan Anda mengetik karakter berdasarkan kodenya. Tahan tombol Alt, ketik angka di numpad (tombol angka di sisi kanan keyboard), lalu lepaskan Alt. Alt+65 menghasilkan "A", dan Alt+64 menghasilkan "@".
Ada satu jebakan. Angka tanpa awalan 0 dibaca menurut tabel DOS lama (CP437 atau CP850, tergantung bahasa Windows), sedangkan angka berawalan 0 dibaca menurut Windows-1252. Contohnya, simbol pangkat dua "²" diketik dengan Alt+0178 atau Alt+253. Keduanya berada di luar ASCII, sesuai penjelasan tentang Extended ASCII sebelumnya.
Rekomendasi: Kapan Membatasi Input ke ASCII
Prinsipnya, batasi ke ASCII hanya untuk data yang dibaca mesin, dan izinkan UTF-8 untuk data yang dibaca manusia. Berikut panduan yang kami pakai:
- Batasi ke ASCII: slug URL, nama berkas di server, username dan ID teknis, nama host, nama header, kunci API, dan nama variabel. Untuk teks satu baris, izinkan rentang kode 32–126 saja. Untuk slug dan nama berkas, persempit lagi ke
a-z,0-9, dan tanda hubung. - Izinkan UTF-8: nama orang, alamat, judul, isi artikel, dan komentar. Di MySQL, gunakan charset utf8mb4 agar emoji yang membutuhkan 4 byte ikut tersimpan.
- Bersihkan sebelum menolak: sebelum menampilkan pesan galat, ganti otomatis karakter yang punya padanan ASCII. Contohnya, tanda kutip melengkung menjadi
"dan spasi tak terputus menjadi spasi biasa. - Simpan berkas teks dengan akhir baris LF: terutama skrip shell, berkas konfigurasi, dan crontab yang akan berjalan di server Linux.
Pertanyaan yang Sering Diajukan
Berapa kode ASCII huruf A dan a?
Huruf "A" berkode 65 (heksadesimal 41, biner 1000001). Huruf "a" berkode 97 (heksadesimal 61, biner 1100001). Kode huruf berikutnya bertambah satu, jadi "B" berkode 66 dan "b" berkode 98.
Berapa kode ASCII tombol panah, Enter, Backspace, dan Escape?
Enter mengirim kode 13 (CR), Tab kode 9, dan Escape kode 27. Backspace mengirim kode 8 di Windows, tetapi banyak terminal Linux mengirim kode 127. Tombol panah tidak punya kode ASCII sama sekali. Terminal mengirimnya sebagai urutan beberapa karakter, misalnya panah atas menjadi ESC, "[", lalu "A" (kode 27, 91, 65). Angka 72, 75, 77, dan 80 yang sering muncul di soal adalah scan code keyboard pada program DOS, bukan kode ASCII.
Berapa kode ASCII untuk pangkat 2?
Simbol pangkat dua "²" tidak ada di tabel ASCII. Di Windows, simbol ini diketik dengan Alt+0178 (Windows-1252) atau Alt+253 (tabel DOS CP437/CP850). Nomor Unicode-nya adalah U+00B2. Di teks yang wajib ASCII, pangkat biasanya ditulis dengan tanda caret, misalnya x^2.
Berapa kode heksadesimal ASCII untuk kata SMK?
Setiap huruf dicari satu per satu di tabel. Huruf "S" ada di kolom 5 baris 3, "M" di kolom 4 baris D, dan "K" di kolom 4 baris B. Hasilnya 53 4D 4B dalam heksadesimal, atau 83 77 75 dalam desimal. Cara yang sama berlaku untuk kata apa pun, selama hurufnya ada di tabel ASCII.
Jenis variabel apa yang menyimpan satu karakter ASCII?
Jawabannya adalah tipe char. Di bahasa C, char berukuran 1 byte dan menyimpan kode karakternya sebagai angka, sehingga 'A' + 1 menghasilkan 66. Penjelasan lebih luas tentang tipe ini ada di artikel tipe data.
Apakah Base64 termasuk enkripsi?
Bukan. Base64 adalah metode pengodean yang menerjemahkan data biner menjadi 64 karakter ASCII yang aman dikirim, yaitu A–Z, a–z, 0–9, "+", dan "/". Siapa pun bisa mengembalikannya ke bentuk asli tanpa kunci, jadi Base64 tidak melindungi kerahasiaan data.
Apa itu ASCII art?
ASCII art adalah gambar yang disusun dari karakter cetak ASCII, misalnya huruf, garis miring, dan tanda bintang. Teknik ini populer sejak era terminal teks dan masih dipakai untuk logo di banner aplikasi baris perintah. Bentuk serupa juga dipakai untuk diagram ASCII, yaitu bagan sederhana dari garis, tanda plus, dan panah di dalam komentar kode atau dokumentasi. Karena hanya memakai karakter ASCII, gambarnya tampil sama di hampir semua sistem selama memakai font berlebar tetap.
Kesimpulan
ASCII adalah tabel 128 kode 7 bit yang disusun dengan logika bit. Huruf besar dan kecil beda satu bit, angka menyimpan nilainya sendiri, dan tombol Ctrl cukup mematikan dua bit teratas. "ASCII 8 bit" dan "Extended ASCII" bukan bagian dari standar itu, melainkan tabel pabrikan yang berbeda-beda. Hari ini ASCII hidup sebagai 128 kode pertama Unicode, dan masih diwajibkan di header email, nama domain, serta akhir baris protokol internet.
Dalam praktik, batasi input ke ASCII untuk data yang dibaca mesin seperti slug, nama berkas, dan username. Untuk data yang dibaca manusia, gunakan UTF-8. Semoga artikel ini membantu.